태그 보관물: ceph

Fixing Container Log Rotation on cri-dockerd and a Rolling Kernel Reboot

cri-dockerd 로그 로테이션 에러를 발견한 경위

노드 유지보수를 준비하다가 kubelet이 하루에 노드당 3만~8만 줄의 동일한 에러를 남기고 있는 것을 발견했습니다. 원인은 cri-dockerd 로그 로테이션 요청이 구조적으로 성공할 수 없는 구성에 있었습니다. kubelet은 컨테이너 로그가 임계값을 넘으면 로테이션을 요청하는데, cri-dockerd는 그 요청을 처리할 수 없어 10초마다 거부하고 kubelet은 10초마다 다시 요청했습니다.

이 글은 그 무한 재시도를 어떻게 측정하고 끊었는지, 그리고 같은 작업 창에서 함께 처리한 커널 롤링 재부팅 기록입니다. 재부팅 과정에서 문서에 “영구화 완료”로 적혀 있던 부팅 스크립트가 실은 한 번도 동작한 적이 없었다는 사실도 드러났는데, 그 쪽이 더 값진 수확이었습니다.

환경

구성 요소 내용
Kubernetes v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
컨테이너 런타임 Docker 29.5.3 + cri-dockerd
노드 OS Ubuntu (kernel 6.8.0-124 → 6.8.0-146)
CNI / LB Calico, MetalLB (L2 모드)
스토리지 Rook-Ceph v1.13.10 (mon 3, OSD 3, MDS active+standby)
API 로드밸런서 HAProxy (클러스터 외부 VM, 192.168.x.x:6443)
노드 사양 워커 allocatable 약 7.8 GiB, swap 없음

로그 로테이션 에러를 끊은 과정

1. 에러 규모를 먼저 측정했습니다

로그가 시끄럽다는 인상만으로는 우선순위를 정할 수 없으므로 노드별로 발생량을 세었습니다. 함께 컨테이너 로그 총량과 journald 점유량도 같이 확인했습니다.

journalctl -u kubelet --since "24 hours ago" --no-pager \
  | grep -ci "ReopenContainerLog\|Failed to rotate log"
du -sh /var/lib/docker/containers
journalctl --disk-usage

결과는 예상보다 컸습니다. 4대만 추려도 하루치 에러가 아래와 같았고, journald는 노드당 2.6~4.0 GB를 점유하고 있었습니다. 디스크가 50 GB인 노드에서 무시할 양이 아닙니다.

노드 24시간 에러 줄 수 컨테이너 로그 journald
<master-node-1> 34,548 110 M 2.6 G
<worker-node-1> 45,422 99 M 3.9 G
<worker-node-2> 79,940 245 M 4.0 G
<worker-node-3> 76,334 126 M 3.9 G

2. 에러 본문에서 원인이 그대로 드러났습니다

발생 빈도가 10초 간격이라는 점이 단서였습니다. 크기 기반 로테이션이라면 이렇게 잦을 수 없으므로 실제 메시지를 확인했습니다.

E1011 11:39:41 container_log_manager.go:266] "Failed to rotate log for container"
  err="failed to rotate log \"/var/log/pods/.../csi-snapshotter/0.log\":
       failed to reopen container log \"bcce9138ed39\":
       rpc error: code = Unknown desc = docker does not support reopening container log files"
  currentSize=65818371 maxSize=10485760

두 숫자가 전부를 설명합니다. maxSize=10485760은 kubelet의 containerLogMaxSize 기본값 10 Mi이고, currentSize는 62.8 MiB로 이미 그 임계를 한참 넘긴 상태입니다. kubelet은 임계를 넘은 파일을 발견하면 CRI의 ReopenContainerLog를 호출해 로테이션을 수행하는데, cri-dockerd는 이 RPC를 구현하지 않습니다.

즉 cri-dockerd 환경에서 kubelet이 보내는 로그 로테이션 요청은 영원히 성공할 수 없었고, kubelet은 그 요청을 10초마다 재시도하고 있었습니다. 파일이 임계 아래로 내려갈 일이 없으므로 이 루프는 컨테이너가 재생성될 때까지 멈추지 않습니다. 로그 용량 문제가 아니라 끝나지 않는 재시도가 본질이었습니다.

3. 로그 로테이션 주체를 docker로 넘겼습니다

기존 설정은 max-size가 100m이고 max-file이 없었습니다. json-file 드라이버에서 max-file을 생략하면 기본값이 1이므로 이력이 남지 않고, 100 MiB는 kubelet 임계값 10 Mi보다 훨씬 커서 위 루프를 항상 유발합니다.

해결 방향은 두 가지가 있었습니다. kubelet의 containerLogMaxSize를 키워 로테이션 시도 자체를 막는 방법과, docker의 상한을 kubelet 임계값보다 작게 두는 방법입니다. 후자를 택했습니다. 전자는 kubelet 설정을 바꿔야 하는데 그 값은 클러스터 전역 ConfigMap에서 내려오므로 변경 범위가 노드 밖으로 커집니다.

항목 변경 전 변경 후
max-size 100m 8m (kubelet 임계 10 Mi 미만)
max-file 미지정 (= 1, 이력 없음) 3
컨테이너당 상한 100 MiB 24 MiB

로그 파일이 8 MiB에서 회전하므로 10 Mi에 도달하는 일 자체가 없어지고, kubelet은 로테이션을 시도할 이유를 잃습니다. 실제 회전은 docker가 수행하며 직전 2세대가 남습니다. 결과적으로 cri-dockerd 로그 로테이션 경로는 더 이상 호출되지 않습니다.
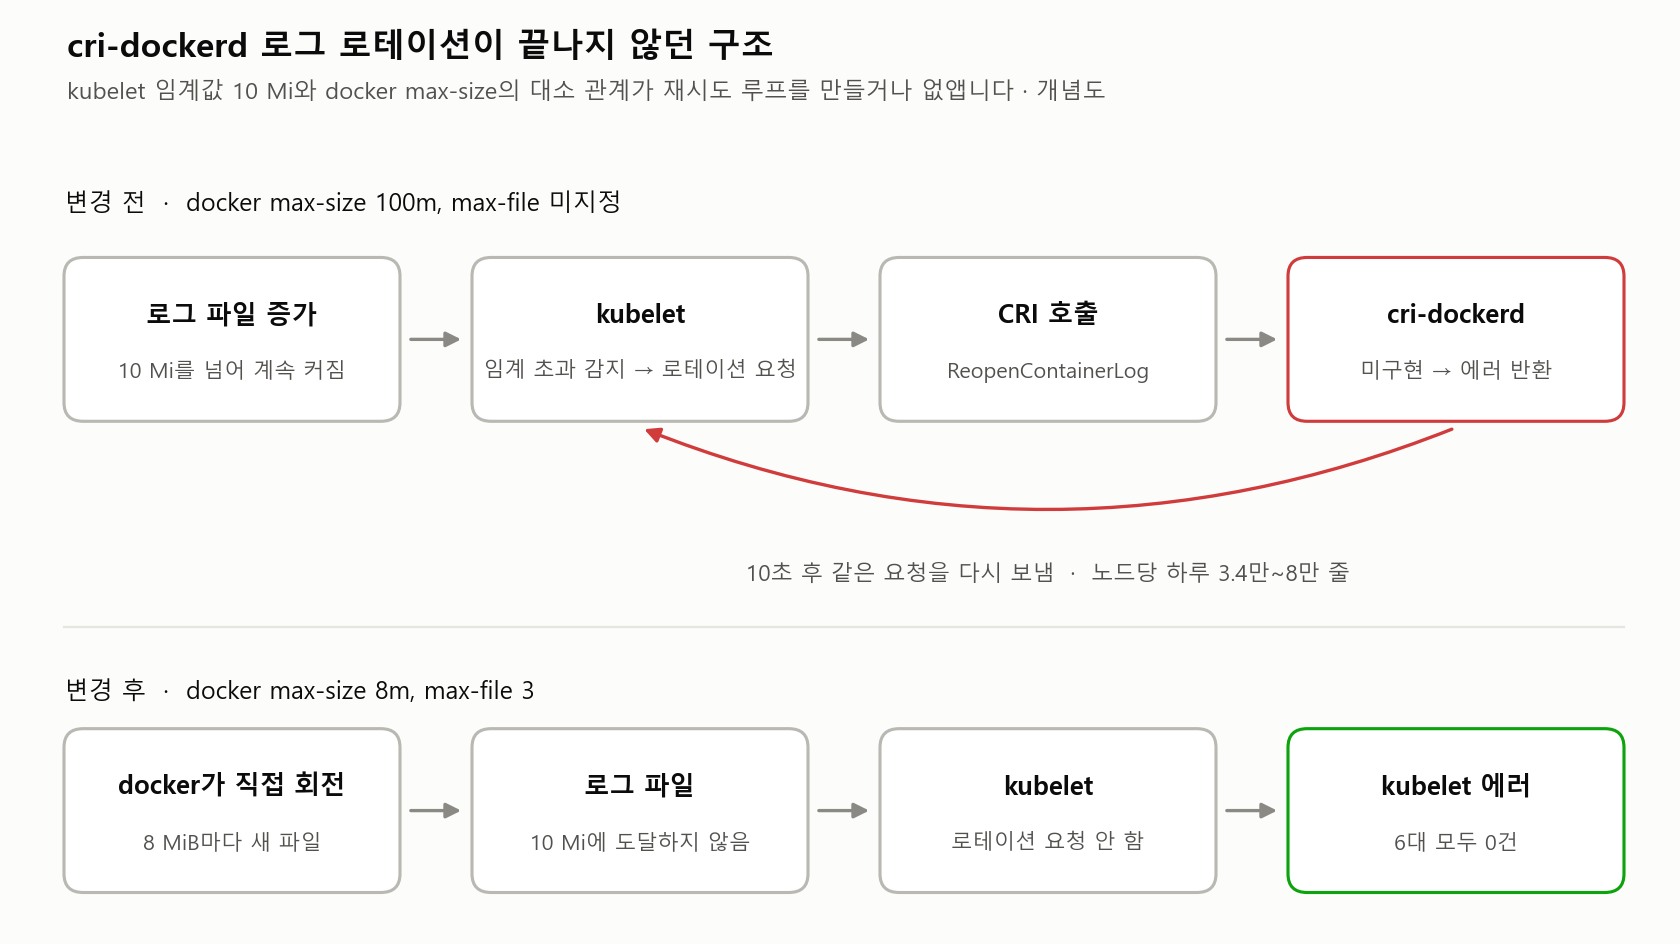
cri-dockerd 로그 로테이션 재시도 루프 개념도: 변경 전 docker max-size 100m에서는 kubelet의 ReopenContainerLog 요청이 10초마다 실패하고, 변경 후 max-size 8m에서는 요청 자체가 사라짐
cri-dockerd 로그 로테이션 재시도 루프가 생기고 사라지는 구조
# /etc/docker/daemon.json
{
  "exec-opts": ["native.cgroupdriver=systemd"],
  "log-driver": "json-file",
  "log-opts": {
    "max-size": "8m",
    "max-file": "3"
  },
  "storage-driver": "overlay2"
}

적용 전 반드시 검증해야 합니다. daemon.json이 깨지면 재부팅 후 docker가 기동하지 못해 노드가 그대로 죽습니다. JSON 구문 검사만으로는 부족하므로 dockerd 자체의 검증기를 통과시킨 뒤 설치했습니다.

sudo cp -a /etc/docker/daemon.json /etc/docker/daemon.json.bak-$(date +%Y%m%d)
python3 -m json.tool /tmp/dj.new > /dev/null          # 구문
sudo dockerd --validate --config-file /tmp/dj.new     # dockerd 레벨 → "configuration OK"
sudo install -m 644 -o root -g root /tmp/dj.new /etc/docker/daemon.json

docker는 재시작하지 않았습니다. 재시작하면 해당 노드의 모든 컨테이너가 재생성되므로, 어차피 진행할 롤링 재부팅에서 자연히 반영되도록 두었습니다.

4. journald 상한을 고정했습니다

SystemMaxUse는 기본적으로 주석 처리되어 있고, 그 경우 파일시스템의 10 %를 쓸 수 있습니다. 50 GB 디스크에서 약 5 GB이며 실제로 4 GB에 근접해 있었습니다. 에러 폭주를 끊어도 상한 자체는 남겨두는 편이 안전합니다.

sudo sed -i -E 's|^[[:space:]]*#?[[:space:]]*SystemMaxUse=.*|SystemMaxUse=1G|' \
  /etc/systemd/journald.conf
sudo systemctl restart systemd-journald
sudo journalctl --vacuum-size=1G

6대 합계로 약 15 GB를 회수했습니다. 노드당 여유 공간이 마스터는 34 → 36 GB, 워커는 23 → 26 GB로 늘었습니다.
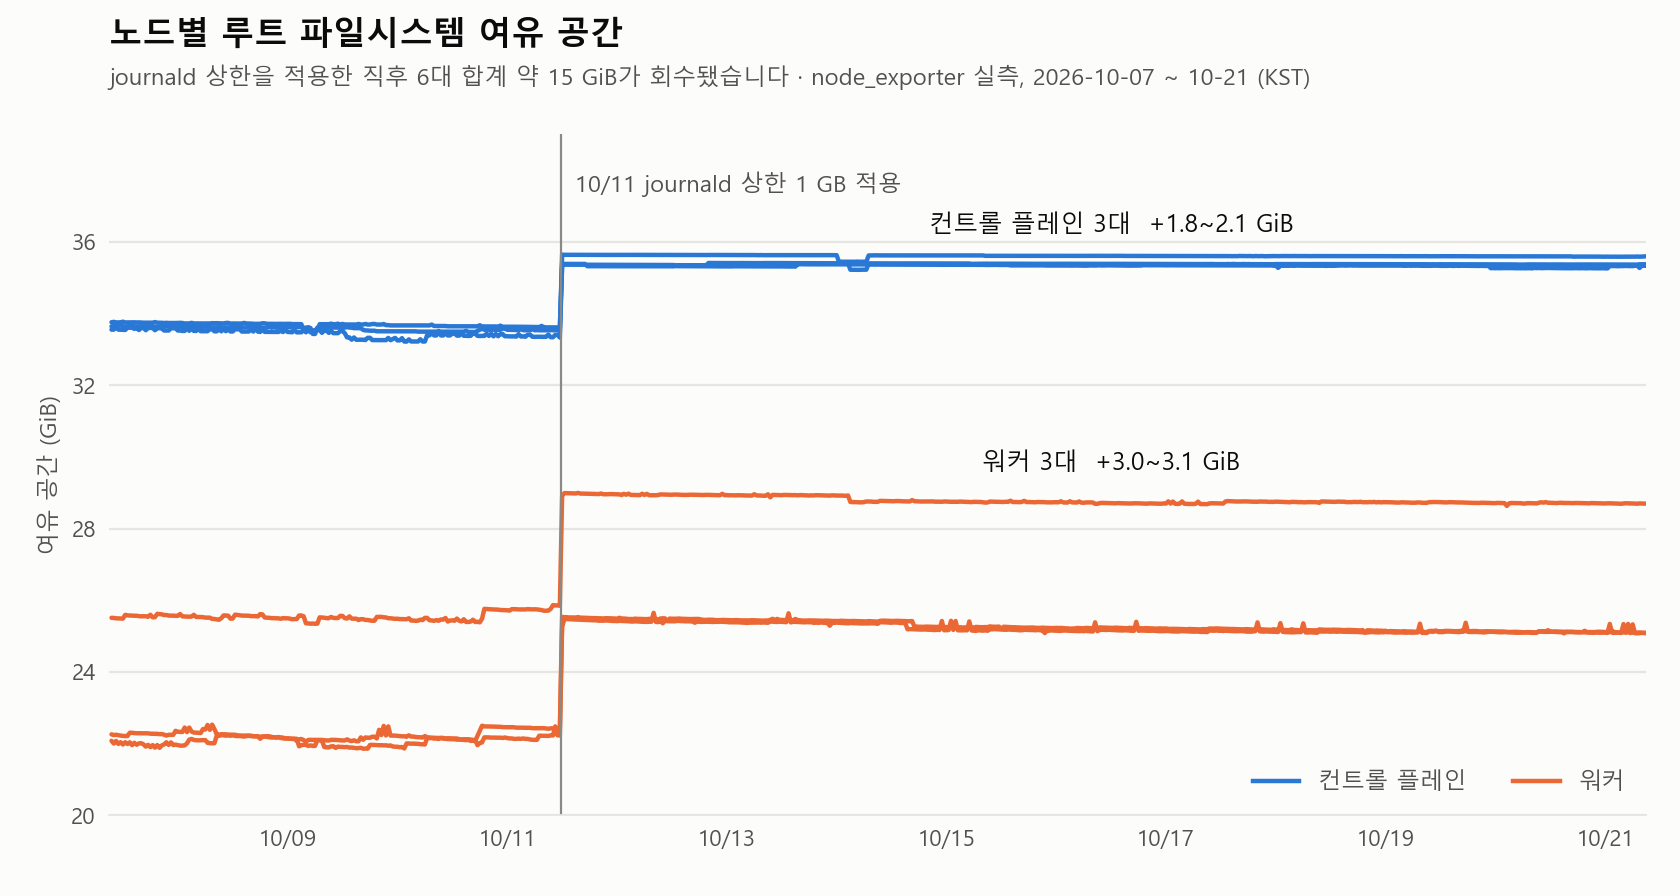
cri-dockerd 로그 로테이션 정리 작업 중 journald 상한 1 GB 적용 직후 노드별 루트 파일시스템 여유 공간이 컨트롤 플레인 약 2 GiB, 워커 약 3 GiB씩 늘어난 그래프
journald 상한 적용 전후 노드별 루트 파일시스템 여유 공간. 10월 11일 정오 무렵 6대가 동시에 늘었고 합계는 약 15 GiB입니다(node_exporter 실측).

5. 롤링 재부팅으로 설정과 커널을 함께 반영했습니다

때마침 커널 드리프트가 쌓여 있었습니다. 6대 전부 6.8.0-146이 설치만 된 상태였고 1대만 그 커널로 가동 중이었습니다. 나머지 5대는 6.8.0-124로 돌고 있어, 다음 재부팅에서 커널이 바뀐다는 뜻입니다. 계획된 창에서 바꾸는 편이 장애 상황에서 마주치는 것보다 낫습니다.

마스터 3대 → 워커 3대 순으로 한 대씩 진행했습니다. 워커 구간은 OSD 하나가 내려가는 동안 Ceph가 리밸런싱을 시작하지 않도록 감쌌습니다.

kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph osd set noout   # 워커 구간 시작

kubectl drain <node> --ignore-daemonsets --delete-emptydir-data --timeout=600s
ssh <admin-user>@<node-ip> 'sudo systemctl reboot'

until kubectl get node <node> \
      -o jsonpath='{.status.conditions[?(@.type=="Ready")].status}' | grep -q True;
do sleep 10; done
kubectl uncordon <node>

kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph osd unset noout # 워커 구간 종료

노드마다 다음 게이트를 모두 통과한 뒤에만 다음 노드로 넘어갔습니다. 커널 버전, ceph 커널 모듈 적재, docker 로그 설정, kubelet·docker 활성 상태, 그리고 마스터는 etcd 쿼럼, 워커는 Ceph의 전체 PG가 active+clean으로 복귀했는지입니다.

노드 재부팅 전 커널 Ready 복귀 관찰
<master-node-1> 6.8.0-124 20초 rc.local 결함 발견
<master-node-2> 6.8.0-124 40초 rc.local 중복 기재 발견
<master-node-3> 6.8.0-124 40초 수정된 rc.local 실동작 확인
<worker-node-1> 6.8.0-146 20초 커널은 이미 최신, 설정 반영 목적
<worker-node-2> 6.8.0-124 30초 OSD PDB가 축출을 1회 지연
<worker-node-3> 6.8.0-124 80초 –

전체 약 40분이 걸렸고 서비스 중단은 없었습니다. Ingress 뒤의 웹 워크로드는 작업 내내 HTTP 200을 유지했습니다.

재부팅하면서 드러난 문제

부팅 스크립트가 매번 조용히 실패하고 있었습니다

현상 – 첫 마스터를 재부팅한 직후, ClusterIP를 HAProxy로 넘기는 DNAT 규칙이 0건이었습니다. 운영 문서에는 /etc/rc.local로 영구화했다고 적혀 있었고 파일도 실행 권한을 갖고 있었습니다.

systemctl status rc-local.service

  rc-local.service: Failed to execute /etc/rc.local: Exec format error
  Process: 822 ExecStart=/etc/rc.local start (code=exited, status=203/EXEC)

원인 – 파일에 shebang이 없었습니다. 실행 권한만으로는 systemd가 인터프리터를 결정할 수 없어 203/EXEC로 떨어집니다. 그 결과 “재부팅 영구화”라고 기록된 장치가 실은 한 번도 동작한 적이 없었습니다. 마스터를 재부팅한 적이 없어서 드러나지 않았을 뿐입니다.

해결 – shebang을 추가하고, 규칙을 넣기 전에 -C로 존재를 확인하도록 다시 썼습니다. 재실행해도 중복이 쌓이지 않습니다.

#!/bin/sh -e
for CHAIN in OUTPUT PREROUTING; do
  iptables -t nat -C "$CHAIN" -d 10.96.0.1 -p tcp --dport 443 \
    -j DNAT --to-destination 192.168.x.x:6443 2>/dev/null ||
  iptables -t nat -I "$CHAIN" -d 10.96.0.1 -p tcp --dport 443 \
    -j DNAT --to-destination 192.168.x.x:6443
done
exit 0

다음 마스터를 재부팅했을 때 규칙이 정확히 2건으로 복원되어 실동작을 확인했습니다.

한 가지 덧붙이면 이 결함의 기능적 영향은 없었습니다. 규칙이 0건인 상태에서도 https://10.96.0.1:443/healthz가 HTTP 200을 반환했습니다. 정상 가동 중에는 kube-proxy가 ClusterIP를 처리하므로, 이 DNAT는 kube-proxy가 아직 준비되지 않은 control plane 조인 시점에만 필요합니다. 그래서 결함이 오래 숨어 있을 수 있었습니다.

같은 파일에 규칙이 중복 기재되어 있었습니다

현상 – 수정 후 서비스를 재시작했더니 한 노드는 규칙이 2건인데 다른 두 노드는 6건이 됐습니다.

원인 – 두 노드의 rc.local 안에 iptables 두 줄이 각각 두 번 적혀 있었습니다. 실행마다 4건이 삽입되던 셈입니다. 동일한 DNAT 규칙이 중복되면 첫 매칭만 평가되므로 기능상 무해하지만, 규칙 수로 상태를 판단할 수 없게 됩니다.

해결 – 중복 줄을 제거해 3대의 파일을 통일하고, 라이브 테이블에서도 체인별 1건만 남도록 정리했습니다. 위의 -C 검사가 재발을 막습니다.

CephFS 커널 모듈이 부팅 시 적재되지 않았습니다

현상 – 앞서 한 워커가 커널 교체와 함께 재부팅된 뒤, RWX 볼륨을 쓰는 워크로드가 마운트에 실패했습니다.

MountVolume.MountDevice failed ... an error (exit status 1) occurred
while running modprobe args: [ceph]

원인 – 모듈 파일은 새 커널 트리에 정상적으로 존재했고 수동 modprobe ceph도 성공했습니다. 모듈 부재가 아니라 부팅 시 자동 적재가 되지 않은 것이었습니다.

해결 – /etc/modules-load.d/ceph.conf로 영구화하고 6대 전부에 배포했습니다. 설정 파일이 존재한다는 사실만으로는 검증이 안 되므로, 모듈을 내린 뒤 적재 서비스를 재시작해 부팅을 재현했습니다.

sudo modprobe -r ceph                       # 사용 중이면 실패하는데 그건 정상
sudo systemctl restart systemd-modules-load
lsmod | grep '^ceph '                       # 적재돼 있어야 한다

이후 6대 재부팅 전부에서 자동 적재를 확인했습니다. 블록 스토리지(RBD)는 이 문제와 무관하며 CephFS를 쓰는 워크로드만 영향을 받습니다.

로그 로테이션 설정 적용 후에도 큰 파일이 남아 있었습니다

현상 – 재부팅을 마치고 확인했더니 8 MiB를 넘는 로그 파일이 노드당 1~3건 남아 있었습니다. 설정이 먹지 않은 것처럼 보였습니다.

원인 – 해당 파일들의 소유 컨테이너를 역추적하니 모두 exited 상태였고, 마지막 수정 시각이 재부팅 시점이었습니다. 구 100m 설정으로 돌던 컨테이너들의 잔존 로그였습니다. 더 커지지 않으며 docker가 해당 컨테이너를 정리할 때 함께 사라집니다.

확인 – 신규 컨테이너에 설정이 실제로 적용됐는지는 파일 크기가 아니라 컨테이너의 로그 설정을 직접 조회해 판단해야 합니다.

docker inspect $(docker ps -q | head -1) \
  --format '{{json .HostConfig.LogConfig}}'

{"Type":"json-file","Config":{"max-file":"3","max-size":"8m"}}

파드가 원래 노드로 돌아오지 않습니다

현상 – 6대를 모두 순회한 뒤 메모리 사용률이 한쪽으로 쏠렸습니다. 한 워커는 68 %인데 다른 워커는 25 %였습니다.

원인 – drain으로 옮겨진 파드는 노드가 복귀해도 자동으로 되돌아오지 않습니다. 순차 재부팅에서는 뒤에 처리한 노드의 파드가 앞서 복귀한 노드로 모이기 쉽습니다.

대응 – 기능 문제는 아니지만 노드 메모리 여유가 빠듯한 환경에서는 지켜볼 값입니다. 작업 직후 kubectl top nodes로 분포를 확인하고, 필요하면 해당 디플로이먼트를 재시작해 재배치를 유도하는 편이 안전합니다. 스케줄러가 선언된 requests를 기준으로 판단하므로, 실사용이 requests보다 큰 워크로드에서는 스케줄러의 여유 표시를 그대로 믿기 어렵습니다.

로그 로테이션 조치 결과

cri-dockerd 로그 로테이션 요청의 무한 재시도는 완전히 멈췄습니다. 재부팅 이후 수집 구간에서 6대 모두 해당 에러가 0건입니다.

journalctl -b -u kubelet --no-pager | grep -c "ReopenContainerLog"
# 6대 전부 0
항목 작업 전 작업 후
kubelet 로테이션 에러 노드당 하루 3.4만~8만 줄 0건
journald 점유 노드당 2.6~4.0 GB (상한 미설정) 노드당 약 950 MB (상한 1 GB)
컨테이너 로그 상한 100 MiB × 1세대 8 MiB × 3세대
커널 6대 중 5대가 6.8.0-124 6대 전부 6.8.0-146
디스크 여유 마스터 34 GB / 워커 23 GB 마스터 36 GB / 워커 26 GB

클러스터 상태도 함께 확인했습니다. 6대 전부 Ready이고 스케줄 가능 상태이며, etcd 3개 엔드포인트가 모두 정상, Ceph는 HEALTH_OK에 mon 3/3, OSD 3/3, 전체 PG active+clean입니다.

kubectl get nodes -o custom-columns=\
'NODE:.metadata.name,STATUS:.status.conditions[-1].status,KERNEL:.status.nodeInfo.kernelVersion'

kubectl get pods -A | grep -v Running | grep -v Completed
kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph -s

정리하면 이번 작업의 핵심은 두 가지입니다. 하나는 런타임이 지원하지 않는 기능을 요청하는 구성은 조용히 자원을 태운다는 점입니다. cri-dockerd 로그 로테이션 문제는 로테이션 주체를 docker로 옮겨 해결했습니다. 다른 하나는 부팅 시 동작하는 설정은 실제로 재부팅해 보기 전까지 검증된 것이 아니라는 점입니다. 이번에 드러난 rc.local 결함과 커널 모듈 자동 적재 문제 모두 재부팅 없이는 알 수 없었습니다.

확인하지 않은 범위도 남겨둡니다. kubelet의 containerLogMaxSize를 직접 조정하는 방식은 시도하지 않았고, max-size를 10 Mi 이상으로 되돌리면 같은 에러가 재발하는지도 실측하지 않았습니다. 동작 원리상 재발이 예상되지만 측정한 결과는 아닙니다.

참고

관련 포스트:

참고 문서: Kubernetes Logging Architecture · Docker json-file logging driver · cri-dockerd · journald.conf
When Ceph OSD Cache Memory Stalls kubelet: Diagnosing Node Memory Exhaustion

3주 간격으로 두 번 멈춘 워커 노드

같은 클러스터에서 3주 간격으로 두 번, 워커 노드 하나가 응답을 멈추고 그 여파로 데이터베이스가 중단됐습니다. 두 번째 사고를 파고들어 찾은 원인은 Ceph OSD 캐시 메모리 문제였습니다. OSD가 osd_memory_target 설정에 따라 노드당 3 GiB를 쓰는데도 리소스 선언은 전혀 없었고, 그 결과 노드 메모리가 수 시간에 걸쳐 말라가다 kubelet이 멈췄습니다.

이 글은 그 연쇄를 추적한 과정과, osd_memory_target 조정 및 데몬별 requests/limits 선언으로 가용 메모리를 0.3 GiB에서 5.1 GiB까지 회복시킨 기록입니다. 중간에 Rook의 리소스 설정이 CR에 따라 무시되는 함정도 하나 만났습니다.

환경

구성 요소 내용
Kubernetes v1.36.3 (control plane 3대 + worker 3대)
워커 노드 노드당 allocatable 7.8 GiB, swap 없음
스토리지 Rook-Ceph v1.13.10 (mon 3, OSD 3, MDS active+standby)
워크로드 MariaDB, WordPress, kube-prometheus-stack

NotReady 추적부터 두 단계 메모리 조치까지

1. 증상 — 노드는 살아 있는데 NotReady

장애 노드는 ping에 응답하고 SSH도 열려 있었습니다. kubelet 포트(10250)까지 살아 있었는데 노드만 NotReady였습니다. kubelet이 API 서버에 하트비트를 보내지 못한 것입니다.

kubectl get lease -n kube-node-lease <worker-node> -o jsonpath='{.spec.renewTime}'
# → 37분 전에서 멈춰 있음. 그런데 호스트는 정상 응답

영속 저널이 켜져 있어 재부팅 이전 로그를 읽을 수 있었던 것이 결정적이었습니다. 강제 재부팅을 했다면 메모리에만 있던 로그는 사라졌을 것입니다.

journalctl -b -1 --no-pager -u kubelet --since "<장애시각 -10분>"

2. kubelet이 멈추기 직전의 신호

kubelet 로그의 마지막 줄들이 패턴을 보여줬습니다.

kubelet: "Failed to rotate log for container" err="... docker does not support reopening container log files"
         currentSize=41897845 maxSize=10485760     # calico-node 41 MB
         currentSize=61953310 maxSize=10485760     # mgr watch-active 62 MB
kubelet: "Housekeeping took longer than expected" expected="1s" actual="1.302s"
kubelet: (마지막 로그)

kernel:  libceph: osd0 down
kernel:  rbd: rbd0: encountered watch error: -107      # ENOTCONN
systemd-journald: Under memory pressure, flushing caches.
(이후 저널 완전 정지)

journald: Under memory pressure가 핵심 단서였습니다. 디스크는 55%로 여유가 있었으니 용량 문제가 아니었습니다.

3. 메모리 추이 확인

Prometheus에서 노드별 가용 메모리를 조회하니 장애 노드만 다른 양상이었습니다.

node_memory_MemAvailable_bytes  (총 7.7 GiB, swap 없음)

장애 노드   06:00=0.6  07:00=0.4  07:20=0.3  08:00=0.3  08:10=0.3 GiB   ← 수 시간째 4% 수준
다른 노드   0.5~1.5 GiB / 0.8~2.1 GiB

주목할 점은 OOM killer가 돌지 않았다는 것입니다. 특정 컨테이너가 한도를 넘은 게 아니라 시스템 전역 메모리가 말라 커널 reclaim이 thrash되면서 kubelet이 응답 불능에 빠진 것이었습니다. swap이 없어 완충이 전혀 없었습니다.

4. 범인 — 리소스 선언이 없는 OSD

파드별 메모리를 보니 OSD가 압도적이었습니다.

kubectl top pods -A --sort-by=memory | head -5

rook-ceph-osd-1    3088Mi
rook-ceph-osd-2    2972Mi
rook-ceph-osd-0    1232Mi    # 직전에 재시작되어 아직 안 자람
mariadb-galera-0   1494Mi
prometheus         806Mi

설정을 확인하니 세 가지가 동시에 문제였습니다.

ceph config get osd osd_memory_target            # 4294967296  (4 GiB, 기본값)
ceph config get osd osd_memory_target_autotune   # false       (노드 크기에 맞춰 조정 안 함)

kubectl get pods -n rook-ceph -l app=rook-ceph-osd \
  -o jsonpath='{.items[0].spec.containers[0].resources}'
# {}   ← requests / limits 둘 다 없음

allocatable이 7.8 GiB인 노드에서 OSD 하나가 4 GiB를 목표로 상한 없이 자랍니다. 여기에 DB와 모니터링 스택이 더해지면 수지가 맞지 않습니다.

더 나쁜 건 스케줄러가 이를 몰랐다는 점입니다. requests가 14~30%만 선언돼 있는데 실사용은 63~89%였습니다. 스케줄러 입장에선 노드가 비어 보여 계속 파드를 배치합니다.

5. 1단계 — osd_memory_target 축소 (무중단)

OSD가 스스로 bluestore 캐시를 줄이도록 하는 런타임 설정이라 재시작이 필요 없습니다.

kubectl exec -n rook-ceph deploy/rook-ceph-tools -- \
  ceph config set osd osd_memory_target 2147483648     # 4 GiB -> 2 GiB

수 분 내에 OSD 메모리가 3,084 → 2,006 Mi로 내려갔습니다. 실측 기준 osd_memory_target 대비 실사용 비율이 약 0.75였습니다.

주의할 점이 있습니다. kubectl top nodes로 보면 회수 효과가 금세 상쇄된 것처럼 보이는데, 이는 페이지 캐시가 다시 채워진 것이라 무해합니다. 판단은 node_memory_MemAvailable_bytes로 해야 합니다.

MemAvailable 변화
  노드A   0.5 GiB → 1.3 GiB   (2.6배)
  노드B   1.3 GiB → 2.2 GiB

6. 2단계 — 데몬별 requests/limits 선언

osd_memory_target 설정은 OSD의 자율 조절(soft)일 뿐입니다. 쿠버네티스에 알리고 강제 상한을 두려면 CR에 선언해야 합니다. 둘은 서로 다른 문제를 풉니다.

설정 해결하는 것
osd_memory_target OSD가 스스로 캐시를 줄임 (실사용량 자체를 낮춤)
k8s requests 스케줄러가 현실을 알게 함 → 과잉 배치 방지
k8s limits cgroup 강제 상한 → 노드 전체 사망을 컨테이너 1개 OOM으로 축소

이번 사고에서 OOM killer가 돌지 않은 것이 바로 limits 부재 때문이었습니다. 상한이 있었다면 OSD 하나만 죽고 Ceph는 degraded로 버텼을 텐데, 상한이 없어 노드가 통째로 말랐습니다.

# CephCluster CR
spec:
  resources:
    osd:  { requests: {memory: 2Gi},   limits: {memory: 3Gi} }
    mon:  { requests: {memory: 512Mi}, limits: {memory: 1Gi} }
    mgr:  { requests: {memory: 512Mi}, limits: {memory: 1Gi} }

limit을 target에 바짝 붙이면 rocksdb와 메모리 단편화 오버헤드로 OOM kill 루프에 빠집니다. target 2 GiB에 limit 3 GiB로 1 GiB 여유를 뒀습니다.

적용은 위험도가 낮은 순서로 한 종류씩, 각 단계마다 ceph health를 확인하며 진행했습니다.

# mgr -> mds -> mon -> osd 순. 각 단계 사이에 HEALTH_OK 확인
kubectl patch cephcluster -n rook-ceph rook-ceph --type merge \
  -p '{"spec":{"resources":{"mgr":{"requests":{"memory":"512Mi"},"limits":{"memory":"1Gi"}}}}}'

리소스 선언 중 만난 Rook·LimitRange 함정

MDS 리소스가 CephCluster CR 에서 무시됨

현상 — CephCluster.spec.resources.mds에 값을 넣었더니 CR에는 기록되는데 MDS 파드에는 전혀 반영되지 않았습니다. mgr은 같은 방식으로 적용됐는데 MDS만 롤링조차 되지 않았습니다.

kubectl get pods -n rook-ceph -l app=rook-ceph-mds \
  -o jsonpath='{range .items[*]}{.metadata.name}{" "}{.spec.containers[0].resources}{"\n"}{end}'
# mds-myfs-a ... {}      <- 비어 있음
# mds-myfs-b ... {}

원인 — Rook에서 MDS 데몬 배포는 CephFilesystem CR이 소유합니다. CephCluster의 resources가 지원하는 키는 mgr·mon·osd·prepareosd·crashcollector·exporter 등이고 mds는 포함되지 않아 조용히 무시됩니다.

해결 — CephFilesystem.spec.metadataServer.resources에 선언합니다.

kubectl patch cephfilesystem -n rook-ceph myfs --type merge \
  -p '{"spec":{"metadataServer":{"resources":{"requests":{"memory":"256Mi"},"limits":{"memory":"1Gi"}}}}}'

전환 중 standby MDS가 교체되며 20초가량 HEALTH_WARN이 떴다가 복귀했고, CephFS를 쓰는 워크로드는 영향을 받지 않았습니다.

LimitRange 를 전역 기본값으로 착각

현상 — 리소스 선언이 없는 컨테이너가 95개나 돼서 LimitRange로 기본값을 주려 했는데, 한 네임스페이스에 선언하면 전체에 적용될 것으로 기대했습니다.

원인 — LimitRange는 네임스페이스 스코프이고 쿠버네티스에 전역 기본 LimitRange라는 개념 자체가 없습니다. server dry-run으로 확인했습니다.

LimitRange 있는 네임스페이스  → {"limits":{"memory":"256Mi"},"requests":{"cpu":"10m","memory":"64Mi"}}
LimitRange 없는 네임스페이스  → {}     (아무것도 주입되지 않음)

해결 — 대상 네임스페이스마다 오브젝트를 하나씩 둡니다. 같은 검증에서 함정을 하나 더 찾았습니다. limit만 선언하고 request를 빠뜨리면 request가 defaultRequest가 아니라 limit과 같은 값이 됩니다. requests가 부풀어 스케줄링이 막힐 수 있으니 항상 함께 선언해야 합니다.

선언: limits{1Gi}, request 없음  →  결과: limits{1Gi} requests{memory:1Gi}   # 64Mi 아님

덧붙여 max/min은 넣지 않았습니다. 조건 위반 시 파드 생성을 거부하므로 정상 워크로드가 막힐 위험이 있습니다. CPU limit도 throttling 때문에 두지 않았습니다.

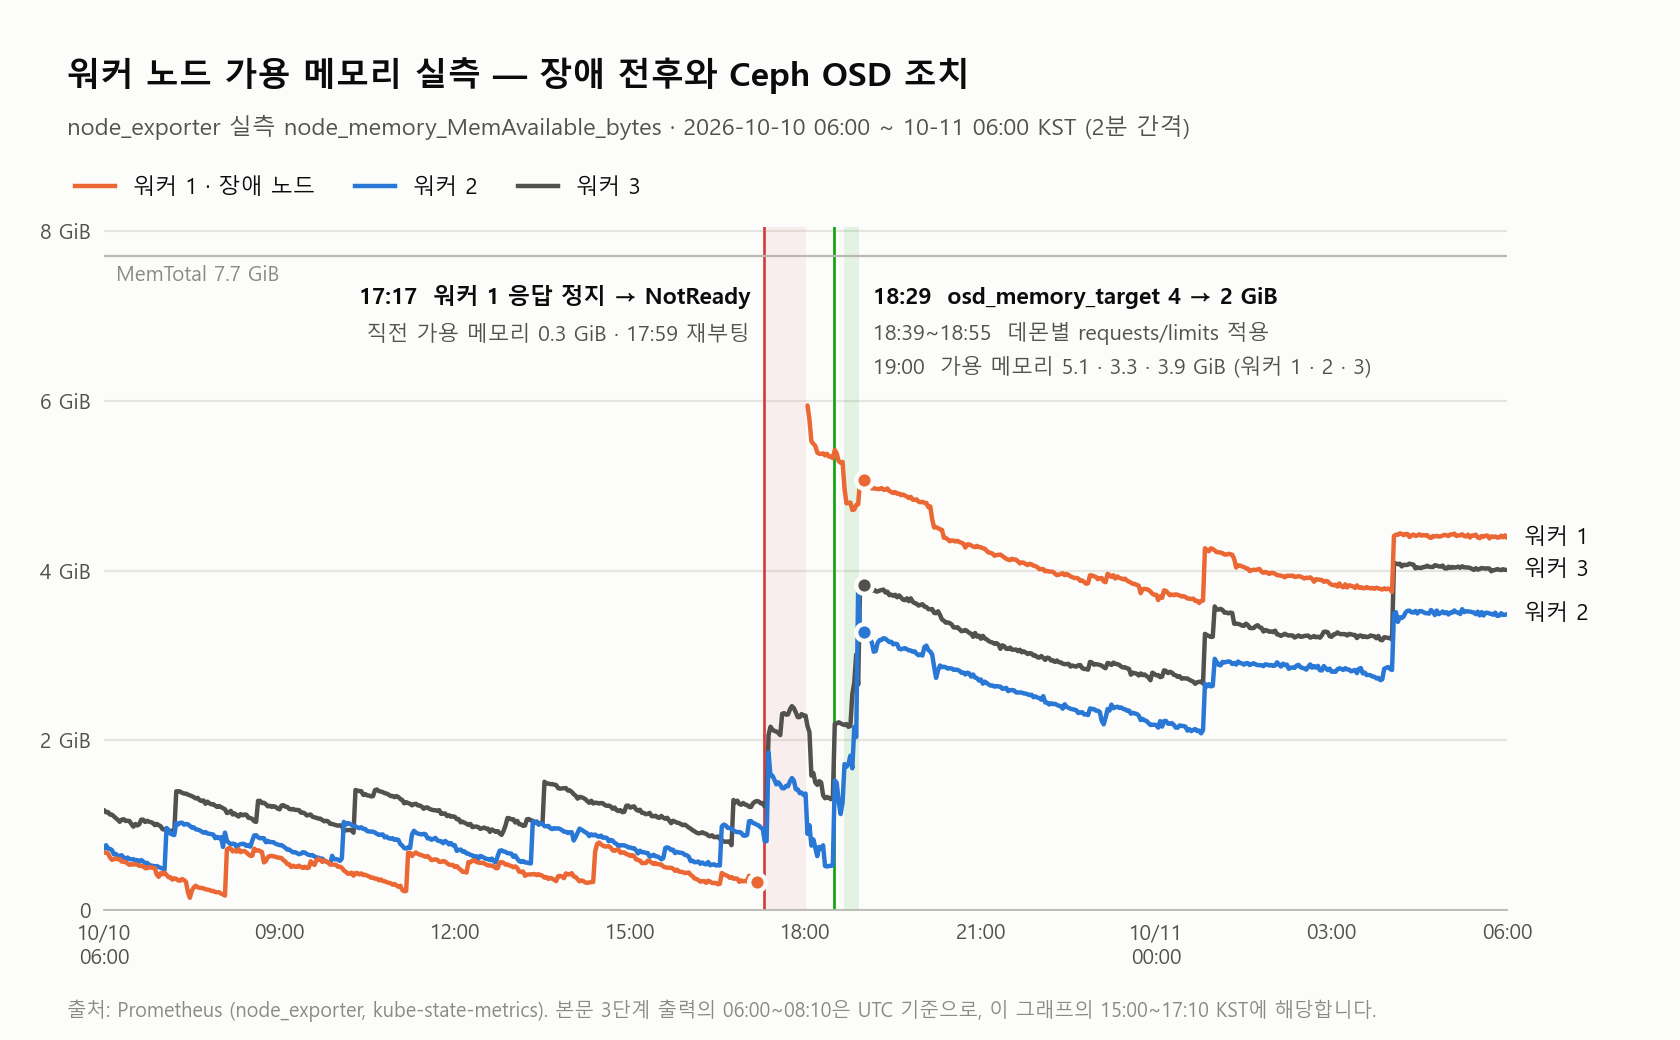
가용 메모리 0.3 GiB에서 5.1 GiB로 회복

Ceph OSD 캐시 메모리 사용량을 제어한 뒤 노드 가용 메모리가 회복됐습니다.

Ceph OSD 캐시 메모리 조치 전후 워커 노드 3대의 MemAvailable 실측 그래프로, 장애 노드가 0.3 GiB 수준에서 응답을 멈춘 뒤 재부팅과 osd_memory_target 축소, limits 적용을 거쳐 세 노드 모두 3~5 GiB대로 회복된 모습입니다.
osd_memory_target 조정과 리소스 선언 전후의 워커 노드 가용 메모리 실측 추이(KST)이며, 워커 1·2·3이 아래 표의 노드A·B·C입니다.
노드 MemAvailable (전) MemAvailable (후) top (전 → 후)
노드A 0.3 GiB 5.1 GiB 60% → 35%
노드B 0.5 GiB 3.3 GiB 88% → 54%
노드C 1.3 GiB 3.9 GiB 81% → 48%

노드B가 0.5 GiB였다는 것은 장애 노드가 쓰러지기 직전(0.3 GiB)과 거의 같은 수준이었다는 뜻입니다. 다음 차례였던 셈입니다.

OSD 롤링 적용 중에도 데이터 경로는 멈추지 않았습니다.

osd[0:2/2 1:2/2 2:2/2] limit적용=0/3  HEALTH_OK
osd[0:2/2 1:1/2 2:2/2] limit적용=1/3  HEALTH_WARN 1 osds down; Degraded
osd[0:2/2 1:2/2 2:0/2] limit적용=2/3  HEALTH_WARN 1 osds down; Degraded
osd[0:2/2 1:2/2 2:2/2] limit적용=3/3  HEALTH_OK

풀이 size=3 / min_size=2라 한 대씩 재시작하는 동안 I/O가 계속됐고, 상위 데이터베이스도 영향을 받지 않았습니다.

검증은 이렇게 합니다.

kubectl exec -n rook-ceph deploy/rook-ceph-tools -- ceph config get osd osd_memory_target
kubectl get pods -n rook-ceph -l app=rook-ceph-osd \
  -o jsonpath='{.items[0].spec.containers[0].resources}'
kubectl top nodes

# 판단은 MemAvailable 로. top 은 페이지 캐시 때문에 과장돼 보인다
curl -sG "http://<prometheus>/api/v1/query" \
  --data-urlencode 'query=node_memory_MemAvailable_bytes/1024/1024/1024'

참고

관련 포스트:

참고 문서: Ceph BlueStore Configuration (osd_memory_target) · Rook CephCluster CRD · Rook CephFilesystem CRD · Kubernetes LimitRange

Diagnosing a 9-Second Node Blackout: Rook Tolerations and Control Plane Metrics

9초 단절이 Rook 파드 축출로 번지기까지

워커 노드 한 대가 약 9초 동안 네트워크에서 사라졌습니다. 그 쿠버네티스 노드 순단 하나가 스토리지 컨트롤 파드의 즉시 축출로 번졌고, 결국 상위 워크로드까지 영향을 받았습니다. 정작 처음 눈에 띈 증상은 Ceph 파드가 무더기로 재기동된 것이어서, 저장소 쪽 문제로 오인하기 쉬운 상황이었습니다.

이 글은 그 9초를 어떻게 특정했는지, 그리고 같은 일이 반복되어도 피해가 번지지 않도록 적용한 두 가지 조치를 정리한 운영 기록입니다. 관측 도구 자체가 장애 노드 위에 있을 때 생기는 판단 착오와, 그것을 걷어내기 위해 클러스터 바깥의 관측자를 동원한 과정이 핵심입니다.

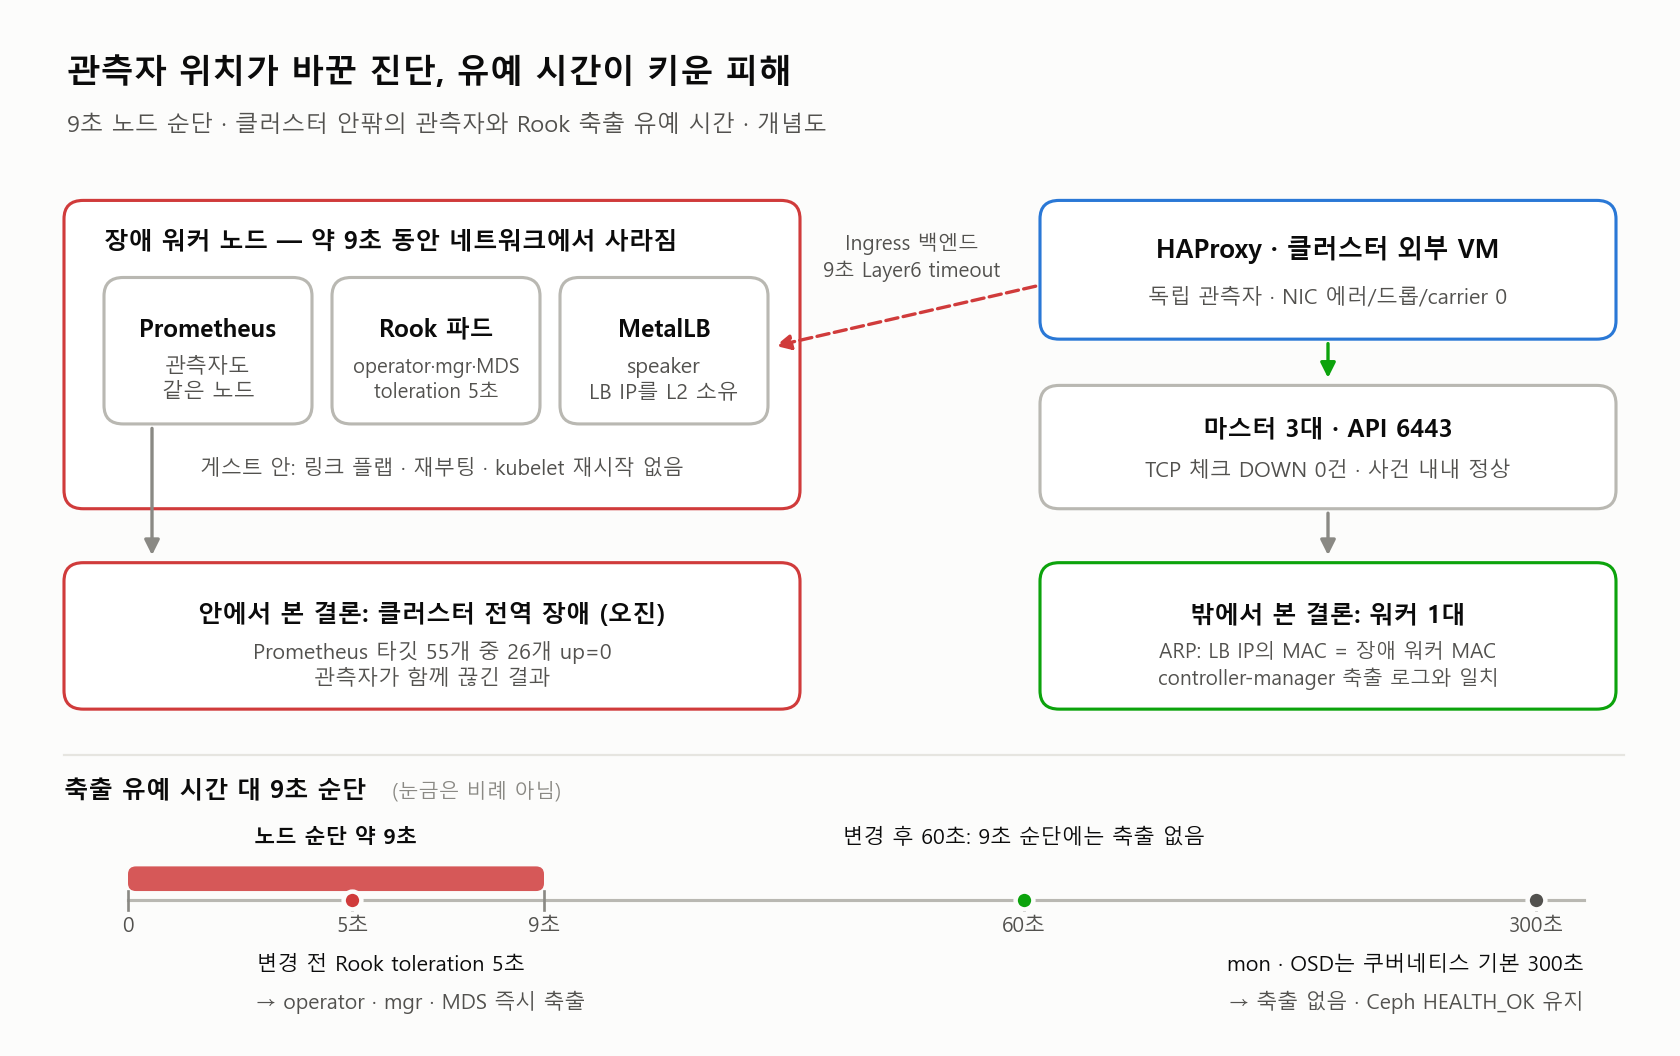
쿠버네티스 노드 순단 9초 동안 장애 노드 안의 Prometheus는 전역 장애로 오진하고 클러스터 밖 HAProxy는 워커 1대로 범위를 좁힌 구조와, Rook toleration 5초·60초·기본 300초를 9초 단절과 비교한 개념도입니다.
쿠버네티스 노드 순단 9초를 클러스터 안팎의 관측자가 다르게 본 구조와 축출 유예 시간의 차이입니다.

환경

구성 요소 내용
Kubernetes v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
컨테이너 런타임 Docker + cri-dockerd
CNI / LB Calico, MetalLB (L2 모드)
스토리지 Rook-Ceph v1.13.10 (mon 3, OSD 3, MDS active+standby)
API 로드밸런서 HAProxy (클러스터 외부 VM, 192.168.x.x:6443)
모니터링 kube-prometheus-stack
가상화 VMware (전 노드 VM)

관측자 편향을 걷어낸 추적과 두 가지 조치

1. 최초 관측과 오진

Prometheus에서 장애 시각의 스크레이프 상태를 조회했더니 55개 타깃 중 26개가 같은 1분 구간에 up=0이었습니다. API 서버 3대 전부, kubelet 6대 전부가 포함되어 있어 처음에는 클러스터 전역 네트워크 장애로 판단했습니다.

kubectl exec -n rook-ceph deploy/rook-ceph-tools -- \
  curl -sG "http://<prometheus-svc>:9090/api/v1/query_range" \
  --data-urlencode 'query=up' \
  --data-urlencode "start=<epoch>" --data-urlencode "end=<epoch>" \
  --data-urlencode "step=15"

그런데 이 판단에는 결함이 있었습니다. Prometheus 파드 자체가 문제가 의심되는 워커 노드 위에서 동작하고 있었기 때문입니다. 관측자가 장애 대상 안에 있으면 “모든 타깃이 죽었다”는 결과는 타깃의 상태가 아니라 관측자의 상태를 반영합니다. 게다가 query_range는 직전 값을 최대 5분까지 끌어와 채우므로, 스크레이프가 아예 누락된 구간이 정상값 1로 보이기도 합니다.

2. 클러스터 바깥의 독립 관측자 확보

편향을 걷어내기 위해 클러스터 외부에 있는 HAProxy의 로그를 확인했습니다. HAProxy는 API 서버 3대를 TCP 체크로 상시 감시하고 있으므로, 물리망이나 마스터에 문제가 있었다면 반드시 흔적이 남습니다.

# API 백엔드는 하루 종일 DOWN 이력이 없었음
journalctl -t haproxy --since "YYYY-MM-DD 00:00:00" | grep -iE "DOWN|UP|no server"

Server www.example.com/app1 is DOWN, reason: Layer6 timeout, check duration: 2001ms.
backend 'www.example.com' has no server available!
Server www.example.com/app1 is UP, reason: Layer6 check passed, check duration: 1ms.

결과는 명확했습니다. 6443 백엔드는 DOWN 기록이 한 건도 없었고 NIC 에러·드롭·carrier 카운터도 모두 0이었습니다. 즉 물리망과 마스터 3대는 사건 내내 정상이었습니다. 유일한 이벤트는 Ingress 컨트롤러 백엔드가 9초 동안 Layer6 타임아웃을 낸 것뿐이었습니다.

3. ARP 테이블로 MetalLB L2 소유자 특정

그 백엔드 주소는 MetalLB가 L2로 광고하는 LoadBalancer IP입니다. L2 모드에서는 speaker 하나가 해당 IP를 소유하므로, 그 speaker가 있는 노드가 사라지면 IP도 함께 사라집니다. HAProxy의 ARP 테이블에서 소유자를 바로 확인할 수 있었습니다.

ip neigh show | grep -E "192.168.x."

192.168.x.112 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # worker-node
192.168.x.120 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # LoadBalancer IP - 동일 MAC

LoadBalancer IP의 MAC이 특정 워커 노드의 MAC과 동일했습니다. 여기에 kube-controller-manager 로그가 같은 시각 그 노드의 파드를 축출한 기록이 더해지면서, 서로 독립된 두 관측자가 같은 노드를 지목하게 되었습니다.

taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-operator-..."
taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-mgr-a-..."
taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-mds-myfs-b-..."

4. 게스트 내부에는 증거가 없음을 확인

노드가 네트워크에서 사라졌다면 게스트 안에도 흔적이 남아야 합니다. 그런데 어느 지표에도 흔적이 없었습니다.

확인 항목 결과
node_network_carrier_changes_total 전 노드 불변 — 링크 플랩 없음
node_network_up 1 유지
node_boot_time_seconds 불변 — 노드 재부팅 없음
kubelet process_start_time_seconds 불변 — kubelet 재시작 없음
calico-node / kube-proxy / CoreDNS 재시작 0회
HAProxy NIC 카운터 error / dropped / carrier 모두 0

링크는 끊기지 않았는데 네트워크에서는 사라졌고, 물리망과 다른 VM은 멀쩡했습니다. 이 조합은 게스트 계층이 아니라 그 바깥, 즉 하이퍼바이저 계층의 순간적인 정지를 시사합니다. 다만 해당 계층의 이벤트 로그에 접근하지 못해 근본 원인 확정까지는 이르지 못했다는 점을 분명히 해 둡니다. 스냅샷이나 백업 스케줄은 없다는 것이 확인되어, 정기 작업 가설은 배제되었습니다.

5. 조치 1 — Rook toleration 완화

9초짜리 쿠버네티스 노드 순단 하나가 큰 사고가 된 직접적인 이유는 Rook이 자신의 파드에 붙이는 축출 유예 시간이 5초였기 때문입니다. 노드에 unreachable 테인트가 붙자마자 operator·mgr·MDS가 즉시 축출되어 재배치되었습니다.

다행히 데이터 경로인 mon과 OSD에는 이 설정이 적용되지 않습니다. 이들은 쿠버네티스 기본값 300초를 쓰기 때문에 축출되지 않았고, 그래서 Ceph 자체는 HEALTH_OK를 유지했습니다. 유예 시간을 60초로 올렸습니다.

# operator가 관리하는 데몬(mgr, MDS, exporter, crashcollector)에 적용
kubectl set env deploy/rook-ceph-operator -n rook-ceph \
  ROOK_UNREACHABLE_NODE_TOLERATION_SECONDS=60

# operator와 tools 자신의 toleration은 설치 매니페스트가 소유하므로 별도 패치
for d in rook-ceph-operator rook-ceph-tools; do
  kubectl patch deploy -n rook-ceph $d --type=json \
    -p='[{"op":"replace","path":"/spec/template/spec/tolerations/0/tolerationSeconds","value":60}]'
done

이 변경은 operator 파드를 재기동시키고, 이어서 mgr과 MDS 배포본이 순차적으로 롤링됩니다. MDS는 hot standby가 있어 전환이 수 초에 그쳤고, CephFS를 사용하는 워크로드 파드는 재시작 없이 그대로 유지되었습니다.

6. 조치 2 — 컨트롤 플레인 메트릭 노출

사후 분석 과정에서 더 불편했던 것은 etcd·scheduler·controller-manager 지표가 통째로 비어 있었다는 점입니다. 28시간 치를 조회해도 이 세 잡의 스크레이프 성공률이 0%였습니다. 장애 순간 컨트롤 플레인이 어떤 상태였는지 확인할 수단이 아예 없었던 셈입니다.

원인은 단순했습니다. kubeadm 기본값이 세 컴포넌트를 모두 루프백에만 바인딩하기 때문에, 노드 IP로 스크레이프하면 구조적으로 연결이 거부됩니다.

kube-controller-manager   --bind-address=127.0.0.1
kube-scheduler            --bind-address=127.0.0.1
etcd                      --listen-metrics-urls=http://127.0.0.1:2381

마스터 3대의 static pod 매니페스트를 한 대씩 수정했습니다. etcd가 포함되므로 반드시 한 대씩 진행하고, 다음 노드로 넘어가기 전에 쿼럼을 확인해야 합니다.

# 마스터 1대에서 실행 후 검증, 그 다음 노드로 이동
sudo sed -i 's|--bind-address=127.0.0.1|--bind-address=0.0.0.0|' \
  /etc/kubernetes/manifests/kube-controller-manager.yaml \
  /etc/kubernetes/manifests/kube-scheduler.yaml

sudo sed -i -E 's#(- --listen-metrics-urls=).*#\1http://0.0.0.0:2381#' \
  /etc/kubernetes/manifests/etcd.yaml

여기서 한 가지 함정이 있는데, 아래 etcd 이중 바인딩 사례에서 따로 다루겠습니다. 그리고 이 수정만으로는 kubeadm upgrade 시점에 매니페스트가 재생성되면서 모두 되돌아갑니다. kubeadm-config ConfigMap에도 같은 인자를 넣어야 영구적으로 유지됩니다.

controllerManager:
  extraArgs:
  - name: bind-address
    value: 0.0.0.0
scheduler:
  extraArgs:
  - name: bind-address
    value: 0.0.0.0
etcd:
  local:
    dataDir: /var/lib/etcd
    extraArgs:
    - name: listen-metrics-urls
      value: http://0.0.0.0:2381

이 ConfigMap은 업그레이드와 join 시점에만 읽히므로, 반영해도 실행 중인 컴포넌트에는 영향이 없고 노드 재기동도 발생하지 않습니다.

etcd 이중 바인딩과 스크레이프 오독

etcd가 기동하지 않고 마스터 노드가 NotReady로 빠짐

현상 — 첫 마스터에 위 수정을 적용한 직후 해당 노드가 NotReady가 되었습니다. 2379와 6443 포트가 모두 닫혔고, etcd 쿼럼은 2/3로 떨어졌습니다. 호스트 자체는 살아 있어 SSH와 kubelet 포트는 정상이었습니다.

원인 — 처음에 liveness probe를 배려한다는 이유로 루프백을 남긴 채 와일드카드를 덧붙였습니다. 그런데 0.0.0.0은 루프백을 이미 포함하므로 같은 주소를 두 번 바인딩하게 되어 etcd가 기동에 실패했습니다.

# 잘못된 설정
--listen-metrics-urls=http://127.0.0.1:2381,http://0.0.0.0:2381

# etcd 로그
{"level":"fatal","msg":"discovery failed",
 "error":"listen tcp 127.0.0.1:2381: bind: address already in use"}

해결 — 중복을 제거하고 와일드카드만 남겼습니다. 0.0.0.0이 루프백도 커버하므로 127.0.0.1:2381을 보는 liveness probe는 그대로 동작합니다. 수정 후 kubelet이 약 20초 만에 etcd를 재기동했고, 이어서 API 서버와 kubelet이 차례로 붙으면서 노드가 Ready로 복귀했습니다. etcd는 raft term 변화 없이 같은 인덱스로 깨끗하게 재합류했습니다.

sudo sed -i -E 's#(- --listen-metrics-urls=).*#\1http://0.0.0.0:2381#' \
  /etc/kubernetes/manifests/etcd.yaml

kubectl exec -n kube-system etcd-<master-node> -- etcdctl \
  --endpoints=https://192.168.x.101:2379,https://192.168.x.102:2379,https://192.168.x.103:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key endpoint health

이 작업 중 백업 파일을 /etc/kubernetes/manifests/ 안에 만들지 않도록 주의해야 합니다. kubelet이 그 디렉토리를 감시하므로 백업 파일까지 또 하나의 static pod로 읽어 중복 기동을 일으킵니다.

모든 스크레이프 실패를 클러스터 전역 장애로 오독

현상 — 장애 구간에 Prometheus 타깃이 대량으로 up=0이 되어, 마스터를 포함한 클러스터 전체가 끊긴 것처럼 보였습니다.

원인 — Prometheus 파드가 장애 노드 위에 있었습니다. 관측자가 장애 범위 안에 포함되면 “전부 죽었다”는 결과는 타깃이 아니라 관측자의 상태입니다. 여기에 query_range의 lookback 동작이 겹쳐, 스크레이프가 누락된 구간과 정상 구간을 구분할 수 없었습니다.

해결 — 클러스터 밖의 HAProxy 로그와 ARP 테이블을 독립 관측자로 사용해 범위를 다시 그렸습니다. 모니터링 스택이 감시 대상과 같은 장애 도메인에 있으면 그 스택의 데이터만으로는 범위를 확정할 수 없다는 점이 이번 분석의 가장 큰 교훈이었습니다.

축출 유예 60초와 컨트롤 플레인 메트릭 9/9

조치 이후에는 쿠버네티스 노드 순단 발생 시에도 스토리지 컨트롤 파드가 즉시 축출되지 않으며, 컨트롤 플레인 지표도 사후 분석이 가능한 수준으로 확보되었습니다.

항목 조치 전 조치 후
Rook 파드 축출 유예 5초 60초
etcd / scheduler / controller-manager 스크레이프 0 / 9 성공 9 / 9 성공
kubeadm upgrade 후 설정 유지 되돌아감 유지됨
etcd 쿼럼 3 / 3 3 / 3

변경 직후 뜻하지 않게 실전 검증도 이루어졌습니다. 마지막 마스터를 수정하면서 etcd 리더 선출이 일어났고, 그 여파로 노드 3대가 잠시 NotReady로 표시되었습니다. 기존 5초 설정이었다면 operator와 mgr, MDS가 그대로 축출되었을 상황입니다.

kubectl get pods -n rook-ceph

# 축출된 파드 없음 - AGE가 모두 toleration 변경 시점이거나 그 이전
rook-ceph-operator-...     1/1  Running  0  26m   # 설정 변경 시점
rook-ceph-mgr-a-...        3/3  Running  0  25m
rook-ceph-mds-myfs-a-...   2/2  Running  0  25m
rook-ceph-mon-a-...        2/2  Running  0  35d   # 무변동
rook-ceph-osd-0-...        2/2  Running  0  35d   # 무변동

Ceph 파드 축출은 한 건도 발생하지 않았고, 노드는 자동으로 Ready로 복귀했습니다. 최종 상태는 노드 6대 Ready, 비정상 파드 0, etcd 쿼럼 3/3, Ceph HEALTH_OK입니다.

다만 정직하게 남겨둘 부분이 있습니다. 노드가 왜 9초간 사라졌는지는 아직 확정하지 못했습니다. 이번 조치는 원인 제거가 아니라 피해 범위를 줄이는 완화책이며, 하이퍼바이저 계층의 이벤트 로그를 확보하기 전까지는 재발 가능성이 남아 있습니다.

참고

관련 포스트:

참고 문서: Kubernetes Taints and Tolerations · kubeadm ClusterConfiguration v1beta4 · etcd Monitoring · Rook Ceph Operator Helm Chart

Migrating WordPress from a Standalone LAMP Server to Kubernetes with Traefik

CentOS 7 단일 서버를 떠나며 세운 네 가지 목표

레거시 CentOS 7 + Apache + PHP 7.4 단일 서버에서 운영하던 사이트를 자체 관리형 클러스터로 옮긴 WordPress Kubernetes 마이그레이션 기록입니다. 대상 서버는 두 개 도메인을 서빙하고 있었고, DB는 이미 클러스터 내 MariaDB를 외부 LoadBalancer IP로 접속하고 있어 데이터베이스 자체는 새로 구축할 필요 없이 접속 경로만 전환하면 되는 상태였습니다.

이번 작업에서는 ① 진입점을 Traefik Ingress로 전환 ② MariaDB 접속을 ClusterIP로 전환 ③ 다중 파드 확장을 고려해 Rook CephFS(ReadWriteMany) 볼륨 채택 ④ PHP 7.4(EOL)에서 PHP 8.4로 업그레이드, 이 네 가지를 목표로 설계했습니다. 로컬 환경에 docker/podman이 없어 커스텀 이미지를 클러스터 안에서 직접 빌드해야 했고, 그 과정에서 GitLab Container Registry를 신규로 활성화하는 작업도 함께 진행했습니다.

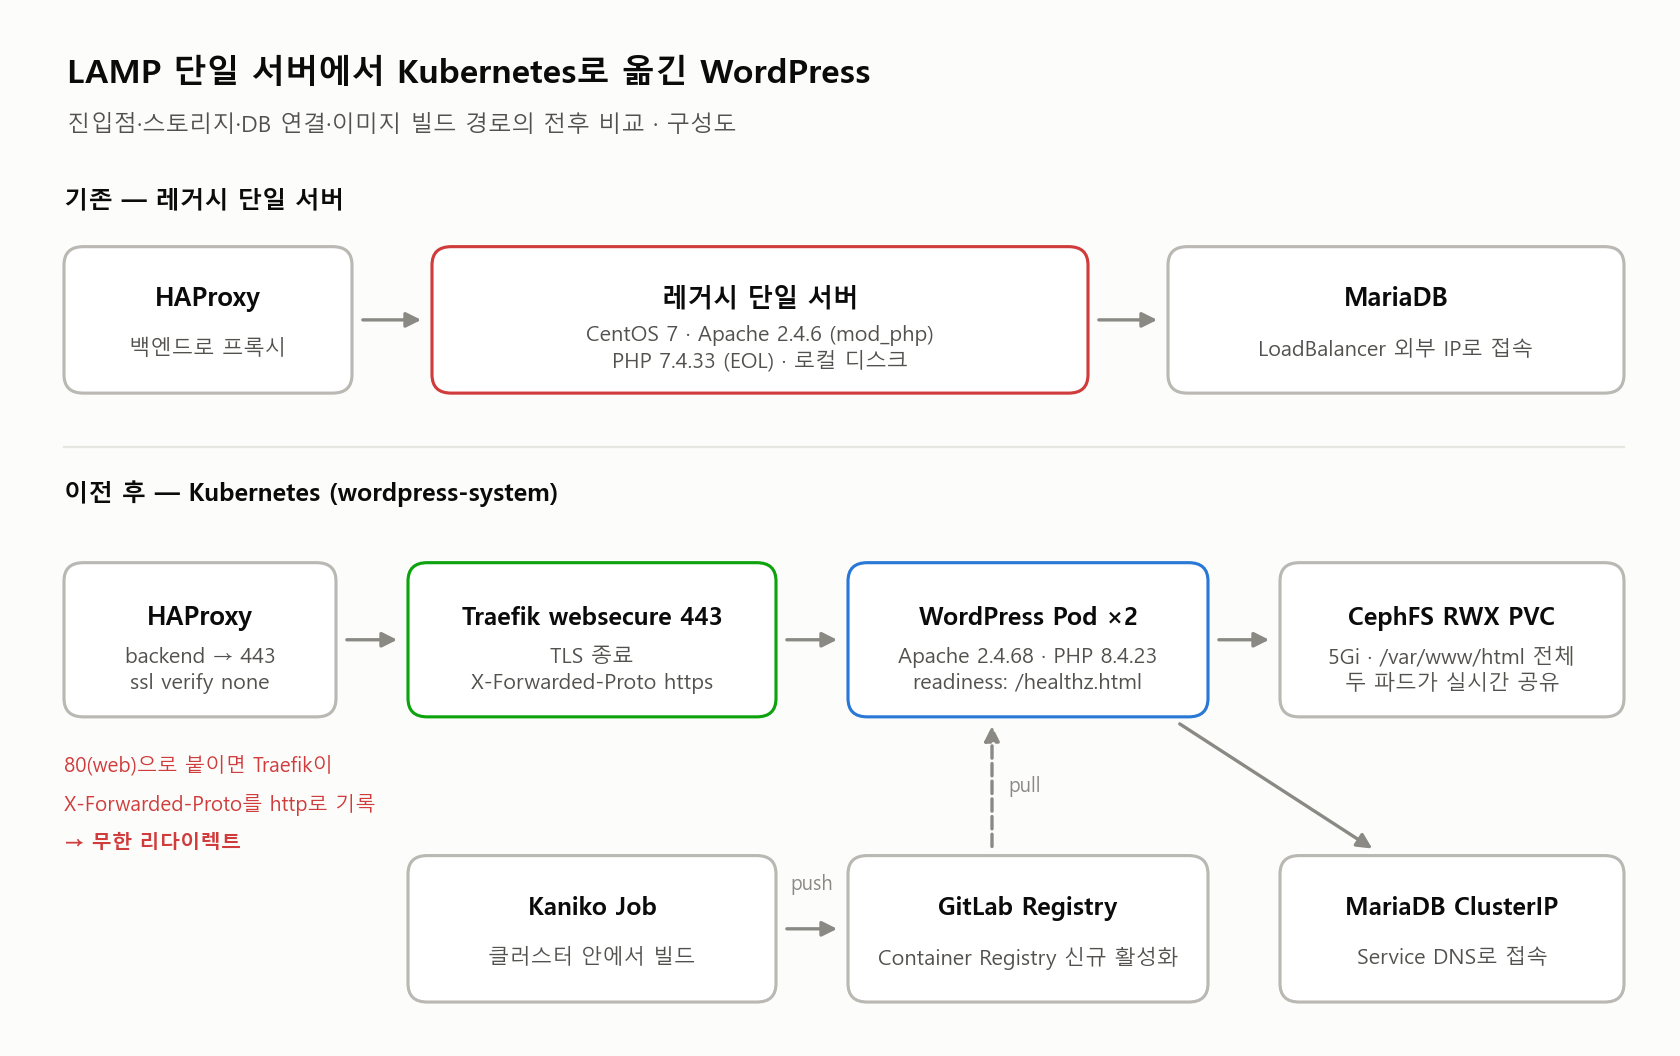
WordPress Kubernetes 마이그레이션 구성도로, CentOS 7 레거시 단일 서버 구성과 HAProxy에서 Traefik websecure 443, WordPress 파드 2개, CephFS RWX PVC, MariaDB ClusterIP로 이어지고 Kaniko와 GitLab Registry가 이미지를 공급하는 이전 후 구성을 비교합니다.
진입점은 Traefik 443으로, webroot는 CephFS RWX 볼륨으로, 이미지는 클러스터 안 Kaniko 빌드로 바뀐 전후 구성입니다.

환경

항목 기존 (192.168.x.x 레거시 서버) 신규 (Kubernetes)
OS / 웹서버 / PHP CentOS 7, Apache 2.4.6 (mod_php, mpm_prefork), PHP 7.4.33 Debian(컨테이너), Apache 2.4.68, PHP 8.4.23
진입점 HAProxy가 TLS 종료 후 백엔드로 프록시 Traefik Ingress (websecure 443)
DB 연결 MariaDB LoadBalancer 외부 IP MariaDB ClusterIP (Service DNS)
스토리지 로컬 디스크 단일 서버 Rook CephFS RWX PVC 5Gi, 파드 2개 공유
메일 발송 로컬 Postfix (direct-send) 이미지 내 Postfix 동일 구성
이미지 – GitLab Container Registry + Kaniko 빌드

WordPress Kubernetes 마이그레이션 설계와 이관

1. 소스 서버 조사 및 이관 설계

SSH로 레거시 서버에 직접 접속해 vhost 설정, wp-config.php, 활성 플러그인 목록, PHP 설정을 조사했습니다. DB 접속 정보(DB_HOST)가 이미 클러스터 내 MariaDB LoadBalancer 외부 IP로 되어 있다는 점을 확인했고, HAProxy IP 하나만 신뢰하도록 되어 있던 mod_rpaf 설정은 새 토폴로지에서는 의미가 없어 mod_remoteip + Pod 네트워크 대역으로 대체가 필요하다는 점도 함께 확인했습니다.

2. 스토리지 설계: webroot 전체를 RWX PVC로

WordPress는 FS_METHOD=direct로 동작해 .htaccess나 플러그인/코어 업데이트를 파일시스템에 직접 씁니다. 다중 파드 환경에서 모든 레플리카가 일관된 상태를 보게 하려면 wp-content만이 아니라 /var/www/html 전체를 공유 볼륨에 올려야 한다고 판단했습니다.

apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: wordpress-webroot
spec:
  accessModes: [ReadWriteMany]
  storageClassName: rook-cephfs
  resources:
    requests:
      storage: 5Gi

wp-config.php는 이 PVC 밖에 두었습니다. DB 접속 정보 등 비밀이 아닌 값은 ConfigMap으로, DB 비밀번호와 AUTH/SALT 키는 Secret으로 분리해 두 파일을 각각 subPath로 마운트하고, 본체 wp-config.php가 require_once로 Secret 쪽 파일을 불러오는 구조로 구성했습니다.

3. 커스텀 이미지 빌드: GitLab Container Registry + Kaniko

로컬 작업 환경에 docker/podman이 없었고, 클러스터도 이전까지 공개 이미지만 사용해 온 상태라 커스텀 이미지를 빌드할 경로가 필요했습니다. GitLab Container Registry가 비활성 상태였어서 이번에 신규로 활성화했습니다.

FROM wordpress:php8.4-apache

# 원본에 없던 zip 확장 추가
RUN apt-get update && apt-get install -y libzip-dev && docker-php-ext-install zip

# 원본과 동일한 Postfix(direct-send) 구성
RUN echo "postfix postfix/main_mailer_type select Internet Site" | debconf-set-selections && \
    DEBIAN_FRONTEND=noninteractive apt-get install -y postfix

# mod_rpaf 대체
RUN a2enmod remoteip headers rewrite expires
COPY security-headers.conf remoteip.conf /etc/apache2/conf-enabled/
CMD ["/usr/local/bin/start.sh"]

이미지는 로컬 빌드 없이 Kaniko Job으로 클러스터 안에서 빌드하고 바로 Registry에 푸시했습니다.

containers:
  - name: kaniko
    image: gcr.io/kaniko-project/executor:v1.23.2
    args:
      - --dockerfile=/workspace/Dockerfile
      - --context=dir:///workspace/
      - --destination=gitlab.sierracloud.dev:5050/infra/k8s-ops/wordpress:php8.4-2

4. 데이터 이관

PVC를 마운트하는 임시 헬퍼 파드를 띄우고 rsync로 레거시 서버의 /var/www/html을 통째로 옮겼습니다. 총 297MB, 13,822개 파일이었고 컷오버 직전에 증분 동기화를 한 번 더 실행해 다운타임을 최소화했습니다. 미사용 상태로 남아있던 두 번째 WordPress 설치본(운영 DB를 그대로 바라보지만 어떤 vhost에서도 서빙되지 않던 orphan 설치)은 이관 대상에서 제외했습니다.

rsync -az --exclude='wp-config.php' \
  -e 'ssh -i <migration-key>' \
  root@192.168.x.x:/var/www/html/ /mnt/webroot/

레지스트리·빌드·리버스 프록시에서 막힌 네 지점

GitLab Container Registry 활성화 중 nginx 전체 다운

현상: gitlab.rb에 registry_external_url을 추가하고 gitlab-ctl reconfigure를 실행하자 nginx가 기동에 실패했고, Registry뿐 아니라 GitLab 웹 UI 전체가 접속 불가 상태가 되었습니다.

원인: registry_nginx가 메인 사이트에 적용해 둔 커스텀 인증서 경로를 상속받지 않고, 존재하지 않는 기본 경로(/etc/gitlab/ssl/<fqdn>.crt)를 찾다가 nginx 설정 검증 자체가 실패했습니다.

해결: registry_nginx['ssl_certificate']/['ssl_certificate_key']를 메인 사이트와 동일한 인증서 경로로 명시적으로 지정한 뒤 재실행해 즉시 복구했습니다.

registry_external_url 'https://gitlab.sierracloud.dev:5050'
gitlab_rails['registry_enabled'] = true
registry_nginx['ssl_certificate'] = "/data/cert/sierracloud.dev/fullchain.pem"
registry_nginx['ssl_certificate_key'] = "/data/cert/sierracloud.dev/privkey.pem"

Kaniko 빌드 컨텍스트의 dangling symlink

현상: Dockerfile과 부속 설정 파일을 ConfigMap으로 만들어 Kaniko 빌드 컨텍스트로 바로 마운트했더니, COPY 단계에서 cannot operate on dangling symlink 에러로 빌드가 실패했습니다.

원인: Kubernetes ConfigMap 볼륨은 각 파일을 실제 파일이 아니라 ..data/<file>을 가리키는 심볼릭 링크로 마운트합니다. Kaniko의 COPY가 이 링크를 그대로 이미지에 복사하면서, 이미지 안에서는 가리키는 대상이 없는 깨진 링크가 되어버렸습니다.

해결: initContainer에서 cp -rL로 심볼릭 링크를 실제 파일 내용으로 역참조 복사한 emptyDir을 만들고, 이 디렉터리를 Kaniko의 빌드 컨텍스트로 사용하도록 변경했습니다.

initContainers:
  - name: prepare-context
    image: busybox:1.36
    command: ["sh", "-c", "cp -rL /configmap-src/. /workspace/"]

Really Simple Security가 리버스 프록시 뒤에서 무한 리다이렉트를 일으킴

현상: .htaccess의 HTTPS 강제 리다이렉트 규칙이 RewriteCond %{HTTPS} !=on 조건을 쓰고 있었는데, 이관 후에는 모든 요청이 계속 리다이렉트되어 파드가 readiness probe를 통과하지 못하고 CrashLoopBackOff 상태에 빠졌습니다.

원인: 원본 서버는 Apache가 직접 TLS를 종료했기 때문에 %{HTTPS}가 정확했지만, 이관 후에는 Traefik이 TLS를 종료하고 WordPress 컨테이너에는 평문 HTTP로 전달되어 %{HTTPS}가 항상 off로 평가되었습니다.

해결: 플러그인 소스를 직접 확인해, 리버스 프록시/로드밸런서 뒤에서 지원하는 방식인 RewriteCond %{HTTP:X-Forwarded-Proto} !https로 교체했습니다. wp-config.php에도 HTTP_X_FORWARDED_PROTO를 확인해 $_SERVER['HTTPS']를 보정하는 코드를 추가해 PHP 레벨의 is_ssl() 판단도 함께 맞췄습니다. 프로브 자체는 이 로직과 무관한 정적 파일(/healthz.html)로 분리해 안정성을 확보했습니다.

RewriteCond %{HTTP_USER_AGENT} !lscache_runner [NC]
RewriteCond %{HTTP:X-Forwarded-Proto} !https
RewriteCond %{REQUEST_URI} !^/healthz\.html$
RewriteRule ^(.*)$ https://%{HTTP_HOST}/$1 [R=301,L]

Traefik이 평문 HTTP 구간에서는 X-Forwarded-Proto를 신뢰하지 않음

현상: 위 수정 이후에도, HAProxy가 Traefik의 80(web) 엔트리포인트로 붙는 기존 패턴(다른 내부 서비스들과 동일한 구성)으로 연결하면 여전히 무한 리다이렉트가 재현되었습니다.

원인: Traefik은 보안상 클라이언트가 보낸 X-Forwarded-Proto 값을 그대로 신뢰하지 않고, 자신이 실제로 수신한 연결이 TLS인지 여부로 직접 값을 판단해 덮어씁니다. HAProxy와 Traefik 사이 구간이 평문 HTTP(80)이면 Traefik은 이 값을 항상 http로 기록합니다.

해결: HAProxy의 backend를 Traefik의 443(websecure) 엔트리포인트로 변경했습니다(ssl verify none). Traefik이 이 연결에서 직접 TLS를 종료하므로 X-Forwarded-Proto가 정확히 https로 설정됩니다. 마침 traefik 네임스페이스에 이미 로드되어 있던 *.sierracloud.dev 와일드카드 인증서가 Traefik의 기본 인증서로 쓰이고 있어서, 별도 인증서 작업 없이 그대로 유효한 인증서를 응답받을 수 있었습니다.

두 파드의 RWX 볼륨 공유와 접근 경로 검증

WordPress Kubernetes 마이그레이션 이후의 최종 상태를 다음과 같이 확인했습니다.

$ kubectl get pods -n wordpress-system -l app=wordpress
NAME                         READY   STATUS    RESTARTS   AGE
wordpress-xxxxxxxxxx-xxxxx   1/1     Running   0          91m
wordpress-xxxxxxxxxx-yyyyy   1/1     Running   0          91m

두 파드가 동일 PVC(RWX)를 실시간으로 공유하는지도 직접 검증했습니다. 한 파드에서 파일을 쓰고 다른 파드에서 즉시 동일한 내용을 읽어, 별도 볼륨이 아니라 완전히 같은 볼륨임을 확인했습니다.

  • 내부망 DNS(도메인 → Traefik IP 직접) 경로로 로그인 페이지, REST API, 실제 게시글 permalink까지 정상 응답 확인
  • 외부에서는 CDN을 경유해 HAProxy → Traefik → 파드로 이어지는 경로로 동일하게 정상 렌더링 확인
  • HAProxy IP로 CDN을 거치지 않고 직접 접근하면 403이 반환되는 것도 확인 — origin을 직접 노출하지 않도록 걸어둔 기존 접근 제어가 그대로 유지되고 있다는 뜻이라 정상 동작으로 판단했습니다

참고

관련 포스트:

참고 문서: Traefik — EntryPoints Forwarded Headers · Kaniko (GoogleContainerTools) · GitLab Container Registry Administration

Kubernetes MariaDB Failover with Rook Ceph

Galera 없이 RWO PVC만으로 복구되는가

Kubernetes MariaDB Failover 검증은 단일 MariaDB Pod가 실행 중인 worker node에서 다른 node로 이동할 때, Rook Ceph RBD 볼륨을 다시 연결하고 데이터베이스 서비스를 복구할 수 있는지 확인한 과정입니다. 별도의 Galera cluster를 구성하지 않고 기존 Deployment와 ReadWriteOnce PVC가 제공하는 장애 복구 범위를 검증하였습니다.

이번 작업에서는 MariaDB 매니페스트와 runtime 설정을 비교하고, 시스템 테이블 업그레이드와 물리 백업을 수행하였습니다. 또한 LoadBalancer 접근 대역을 제한한 뒤 Pod 이동, PVC 재부착, SQL 실행과 서비스 복구 시간까지 단계별로 확인하였습니다.

검증 결과 clean failover에서는 MariaDB Pod가 다른 worker node에 배치되고 기존 데이터를 사용하여 정상적으로 기동하였습니다. 다만 갑작스러운 node 전원 장애는 Pod toleration과 volume fencing 시간이 추가되므로, 이번 결과는 계획된 유지보수 상황의 복구 기준으로 해석해야 합니다.

환경

구성 요소 검증 환경 역할
Kubernetes v1.33 계열, multi control-plane Pod 재스케줄 및 Service 제공
MariaDB 10.11 LTS, single replica Deployment 애플리케이션 데이터베이스
Rook Ceph RBD StorageClass, 10Gi RWO PVC node 간 영구 볼륨 재부착
MetalLB LoadBalancer Service, TCP 3306 클러스터 외부 내부망 연결

MariaDB에는 1Gi memory request와 2Gi limit를 지정하고 InnoDB buffer pool은 512MiB로 설정하였습니다. 점검 전 PVC 여유 공간과 Ceph cluster의 HEALTH_OK 상태를 확인하였습니다. 이 구성은 추가 database replica 없이 Ceph의 storage 내구성과 Kubernetes의 Pod 재스케줄 기능을 활용합니다.

Kubernetes MariaDB Failover 준비와 시험

1. 매니페스트와 운영 상태 확인

먼저 Git에 저장된 PVC, ConfigMap, Deployment, Service를 실제 cluster object와 비교하였습니다. Deployment는 RWO volume의 동시 attach를 피하기 위해 Recreate 전략을 사용하고 있었으며 PVC는 Bound 상태였습니다. Pod, node, Ceph 상태와 최근 event를 함께 확인하여 점검 전에 진행 중인 장애가 없는지도 검증하였습니다.

kubectl get nodes
kubectl get pods -n mariadb-system -o wide
kubectl get pvc mariadb-pv-claim -n mariadb-system -o wide
kubectl get cephcluster -n rook-ceph -o wide
kubectl diff -f manifests/mariadb/mariadb.yaml

Pod의 Running 상태만 확인하지 않고 MariaDB version, InnoDB 설정, 연결 수와 filesystem 사용량을 함께 점검하였습니다. SQL 검사로 시스템 테이블과 실제 적용 변수를 확인해야 매니페스트와 runtime 사이의 차이를 발견할 수 있습니다.

2. 업그레이드 전 물리 백업

시스템 테이블을 변경하기 전에 mariadb-backup으로 전체 data directory의 streaming physical backup을 생성하였습니다. backup stream은 클러스터 외부 경로에서 압축하고 완료 메시지, gzip 무결성, 파일 크기와 SHA-256 checksum을 확인하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" \
  mariadb-backup --backup --stream=xbstream --user=root' \
  | gzip -1 > /secure-backup/mariadb-pre-upgrade.xb.gz

gzip -t /secure-backup/mariadb-pre-upgrade.xb.gz
sha256sum /secure-backup/mariadb-pre-upgrade.xb.gz

Ceph replica는 disk와 OSD 장애에 대한 내구성을 제공하지만 잘못된 SQL이나 시스템 테이블 변경을 되돌리는 backup은 아닙니다. 따라서 storage 상태가 정상이더라도 database upgrade 전에는 독립적인 backup이 필요합니다.

3. MariaDB 시스템 테이블 업그레이드

점검 과정에서 MariaDB binary와 data directory의 시스템 테이블 형식이 일치하지 않는 문제를 확인하였습니다. mysql.user view와 mysql.event, mysql.proc, mysql.column_stats에서 column definition 오류가 발생하였습니다. 기존 upgrade marker로 인해 일반 검사가 완료 상태로 판단하였으므로 backup을 확인한 뒤 --force 옵션을 적용하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" mariadb-upgrade -uroot --force'

업그레이드 후 문제 테이블을 다시 검사하여 모두 OK 상태인 것을 확인하였습니다. application schema의 table 개수는 이전과 동일하였으며 startup log에서도 기존 definition 오류가 재발하지 않았습니다.

4. LoadBalancer 접근 소스 제한

MariaDB LoadBalancer는 클러스터 외부의 내부망 애플리케이션 서버가 접속하기 위해 유지하였습니다. 모든 source를 허용하지 않도록 loadBalancerSourceRanges에 접근 가능한 CIDR만 지정하였습니다. 아래 문서용 CIDR은 적용 환경에서 허용할 내부 대역으로 변경해야 합니다.

spec:
  type: LoadBalancer
  loadBalancerSourceRanges:
    - 192.0.2.0/24
  ports:
    - name: mariadb
      port: 3306
      targetPort: 3306

적용 전 client dry-run과 server-side diff로 Service 이외의 resource가 변경되지 않는지 확인하였습니다. 적용 후에는 source range, LoadBalancer VIP, EndpointSlice와 cluster 내부 database 연결을 검증하였습니다. NodePort가 별도 경로로 노출될 수 있으므로 routed network가 있다면 node firewall과 상위 network ACL도 함께 확인해야 합니다.

5. Clean failover 시험

node 전체를 종료하면 같은 node의 다른 workload에도 영향을 줄 수 있습니다. 이번 시험에서는 영향 범위를 MariaDB로 제한하기 위해 현재 node를 cordon하고 MariaDB Pod만 재생성하였습니다. 다음 명령은 backup과 영향 범위를 확인한 유지보수 환경에서 실행해야 합니다.

kubectl cordon <worker-node-a>
kubectl delete pod <mariadb-pod> -n mariadb-system --wait=false
kubectl get pods -n mariadb-system -l app=mariadb -o wide --watch
kubectl get volumeattachment -o wide
kubectl uncordon <worker-node-a>

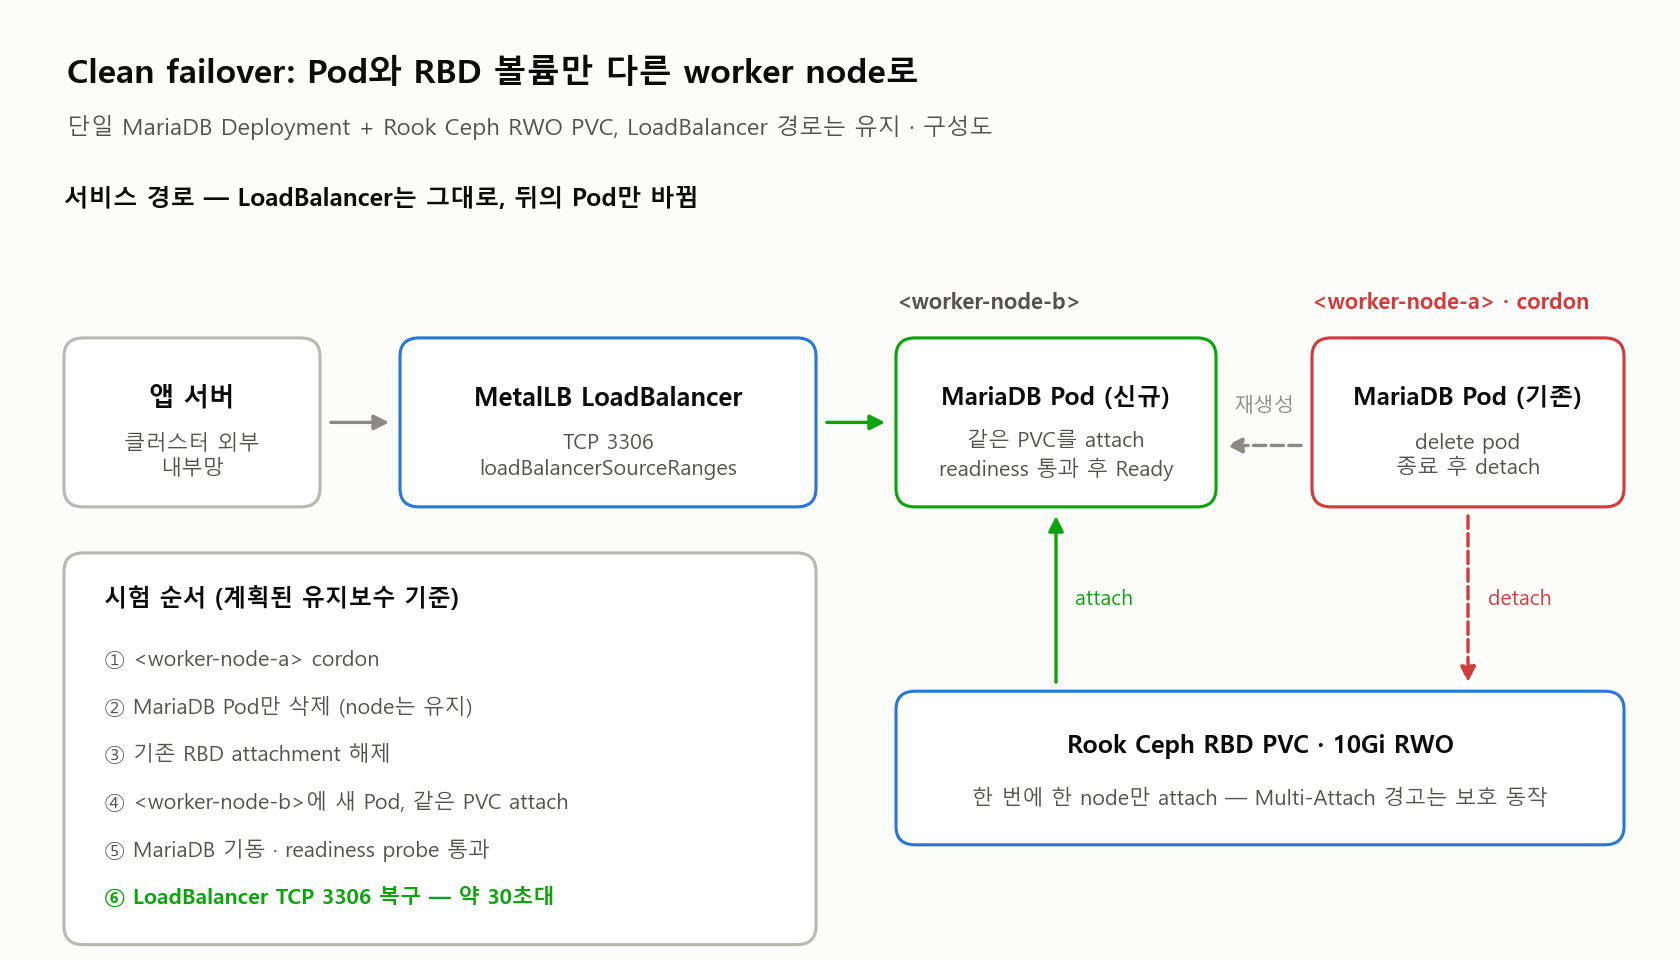
LoadBalancer TCP 3306을 짧은 간격으로 확인하여 서비스 중단과 복구 시점을 기록하였습니다. 새 Pod는 <worker-node-b>에 배치되었으며 기존 RBD attachment가 해제된 후 같은 PVC를 연결하였습니다. container 시작과 readiness probe가 완료된 뒤 LoadBalancer 접속도 다시 성공하였습니다.

Kubernetes MariaDB Failover 구성도로, cordon한 worker node의 MariaDB Pod를 삭제하면 Rook Ceph RBD PVC가 detach된 뒤 다른 worker node의 새 Pod에 attach되고 MetalLB LoadBalancer TCP 3306 경로가 약 30초대에 복구되는 순서를 보여 줍니다.
LoadBalancer 경로는 그대로 두고 Pod와 RWO 볼륨만 다른 worker node로 옮긴 clean failover 순서입니다.

6. 복구 후 데이터베이스 검증

새 node에서 MariaDB가 Ready 상태가 된 뒤 version, system table, application schema, active connection과 startup log를 다시 검사하였습니다. TCP port만 확인하지 않고 실제 SQL query와 Ceph health, VolumeAttachment 대상 node까지 함께 비교하였습니다.

CHECK TABLE mysql.user;
CHECK TABLE mysql.event;
CHECK TABLE mysql.proc;
CHECK TABLE mysql.column_stats;

SELECT VERSION();
SELECT 1 AS read_test;

검증 완료 후 원래 node를 uncordon하여 scheduler가 다시 사용할 수 있도록 복원하였습니다. MariaDB Pod는 새 node에서 계속 실행되었으며 불필요한 추가 재시작은 발생하지 않았습니다.

failover 시험에서 드러난 네 가지 현상

시스템 테이블 형식 불일치

현상: MariaDB 접속은 가능했지만 system view와 statistics table 오류가 반복되었고 Event Scheduler 초기화도 실패하였습니다.

원인: container image의 MariaDB patch version은 변경되었지만 data directory의 일부 system table과 privilege가 현재 binary 형식으로 정리되지 않았습니다. 기존 upgrade marker로 인해 자동 검사는 추가 작업이 필요하지 않다고 판단하였습니다.

해결: physical backup을 확보한 뒤 mariadb-upgrade --force를 실행하고 system table을 재검사하였습니다. 모든 table이 OK 상태가 되었고 이후 startup에서도 같은 오류는 없었습니다.

RBD Multi-Attach 경고

현상: 새 Pod가 다른 worker node에 생성된 직후 volume이 이전 Pod에서 사용 중이라는 Multi-Attach warning이 한 차례 발생하였습니다.

원인: ReadWriteOnce RBD volume의 이전 attachment 정리와 새 attachment 요청 사이에 짧은 시간 차이가 있었습니다. 이는 두 node가 같은 block volume을 동시에 사용하지 못하도록 보호하는 정상적인 동작입니다.

해결: 이전 Pod가 종료되고 CSI controller가 attachment를 정리할 때까지 기다렸으며 잠시 후 attach가 자동으로 성공하였습니다. 이전 node의 상태를 확인하지 않고 VolumeAttachment를 강제로 삭제하면 data corruption 위험이 있으므로 피해야 합니다.

TCP 점검으로 증가한 Aborted Connections

현상: failover 측정 후 Aborted_connects 값과 unauthenticated connection warning이 증가하였습니다.

원인: TCP port monitor가 MariaDB protocol authentication을 수행하지 않고 연결 직후 종료했기 때문입니다.

해결: 측정 종료 후 증가가 멈추는지 확인하였습니다. 상시 monitoring에는 단순 TCP connect 대신 권한이 제한된 health check 계정으로 ping 또는 query를 실행하는 방식이 적합합니다.

Clean failover와 실제 node 장애의 차이

현상: clean failover는 약 30초대에 완료되었지만 실제 node 장애도 같은 시간에 복구된다고 단정할 수 없습니다.

원인: 비정상 장애에서는 Kubernetes가 NotReady 또는 Unreachable 상태를 판단하고 Pod toleration이 만료될 때까지 기다립니다. 기존 node의 volume attachment가 남아 있다면 CSI fencing과 detach에도 시간이 필요합니다.

해결: 이번 결과는 계획된 유지보수 상황의 RTO로 기록하였습니다. 갑작스러운 전원 장애는 수 분 이상의 RTO를 예상하고 별도 점검에서 node shutdown과 MetalLB 경로 전환을 포함하여 검증해야 합니다.

계획된 이동은 약 30초대, 전원 장애는 별도 검증

Kubernetes MariaDB Failover 시험 결과, 단일 MariaDB Deployment와 Rook Ceph RWO PVC 구성에서도 계획된 Pod 이동 후 다른 worker node에서 데이터베이스를 정상적으로 기동할 수 있었습니다. 기존 데이터, system table, application schema, SQL query와 Ceph health가 모두 정상임을 확인하였습니다.

검증 항목 결과
다른 worker node에 Pod 배치 성공
기존 RBD PVC 재부착 성공
MariaDB 기동 및 SQL 실행 정상
LoadBalancer 서비스 복구 약 30초대
갑작스러운 node 전원 장애 이번 시험 범위에서 제외

이번 Kubernetes MariaDB Failover 시험의 측정 시간에는 기존 Pod 종료, RBD detach와 attach, container 시작, MariaDB 기동과 readiness probe 통과가 포함됩니다. 실제 복구 시간은 image cache, node 부하, Ceph 상태와 transaction recovery 양에 따라 달라질 수 있습니다.

현재 workload 규모에서는 Galera cluster의 추가 memory와 storage 소비보다 단일 instance, Ceph RBD, 정기 physical backup과 source-restricted LoadBalancer 조합이 적합하다고 판단하였습니다. 향후 RTO와 RPO 요구가 강화되면 asynchronous replica 또는 Galera와 database proxy 도입을 다시 검토할 수 있습니다.

storage replica는 backup을 대체하지 않습니다. 정기 backup, checksum 검증, 별도 위치 보관과 restore test를 함께 운영해야 node 장애뿐 아니라 운영 실수와 데이터 손상에도 대응할 수 있습니다.

참고

관련 포스트:

참고 문서: Kubernetes Service · MariaDB Upgrade · MariaDB Backup · Rook Ceph Block Storage

Ceph MDS Pod Anti-Affinity Troubleshoot

drain 이후 한 노드로 몰리는 MDS 파드

Kubernetes 클러스터에서 노드 업그레이드나 drain 작업을 수행할 때, Ceph MDS Pod Anti-Affinity 설정이 없으면 MDS 파드 두 개가 동일한 워커 노드에 집중 배치되는 문제가 발생할 수 있습니다. 이 글에서는 node drain 후 MDS 파드가 한 노드에 몰린 상황을 확인하고, CephFilesystem 리소스에 podAntiAffinity 규칙을 적용하여 MDS 파드를 분산 배치하는 과정을 정리합니다. 이어서 함께 발생한 mgr crash 알람 처리 방법도 설명합니다.

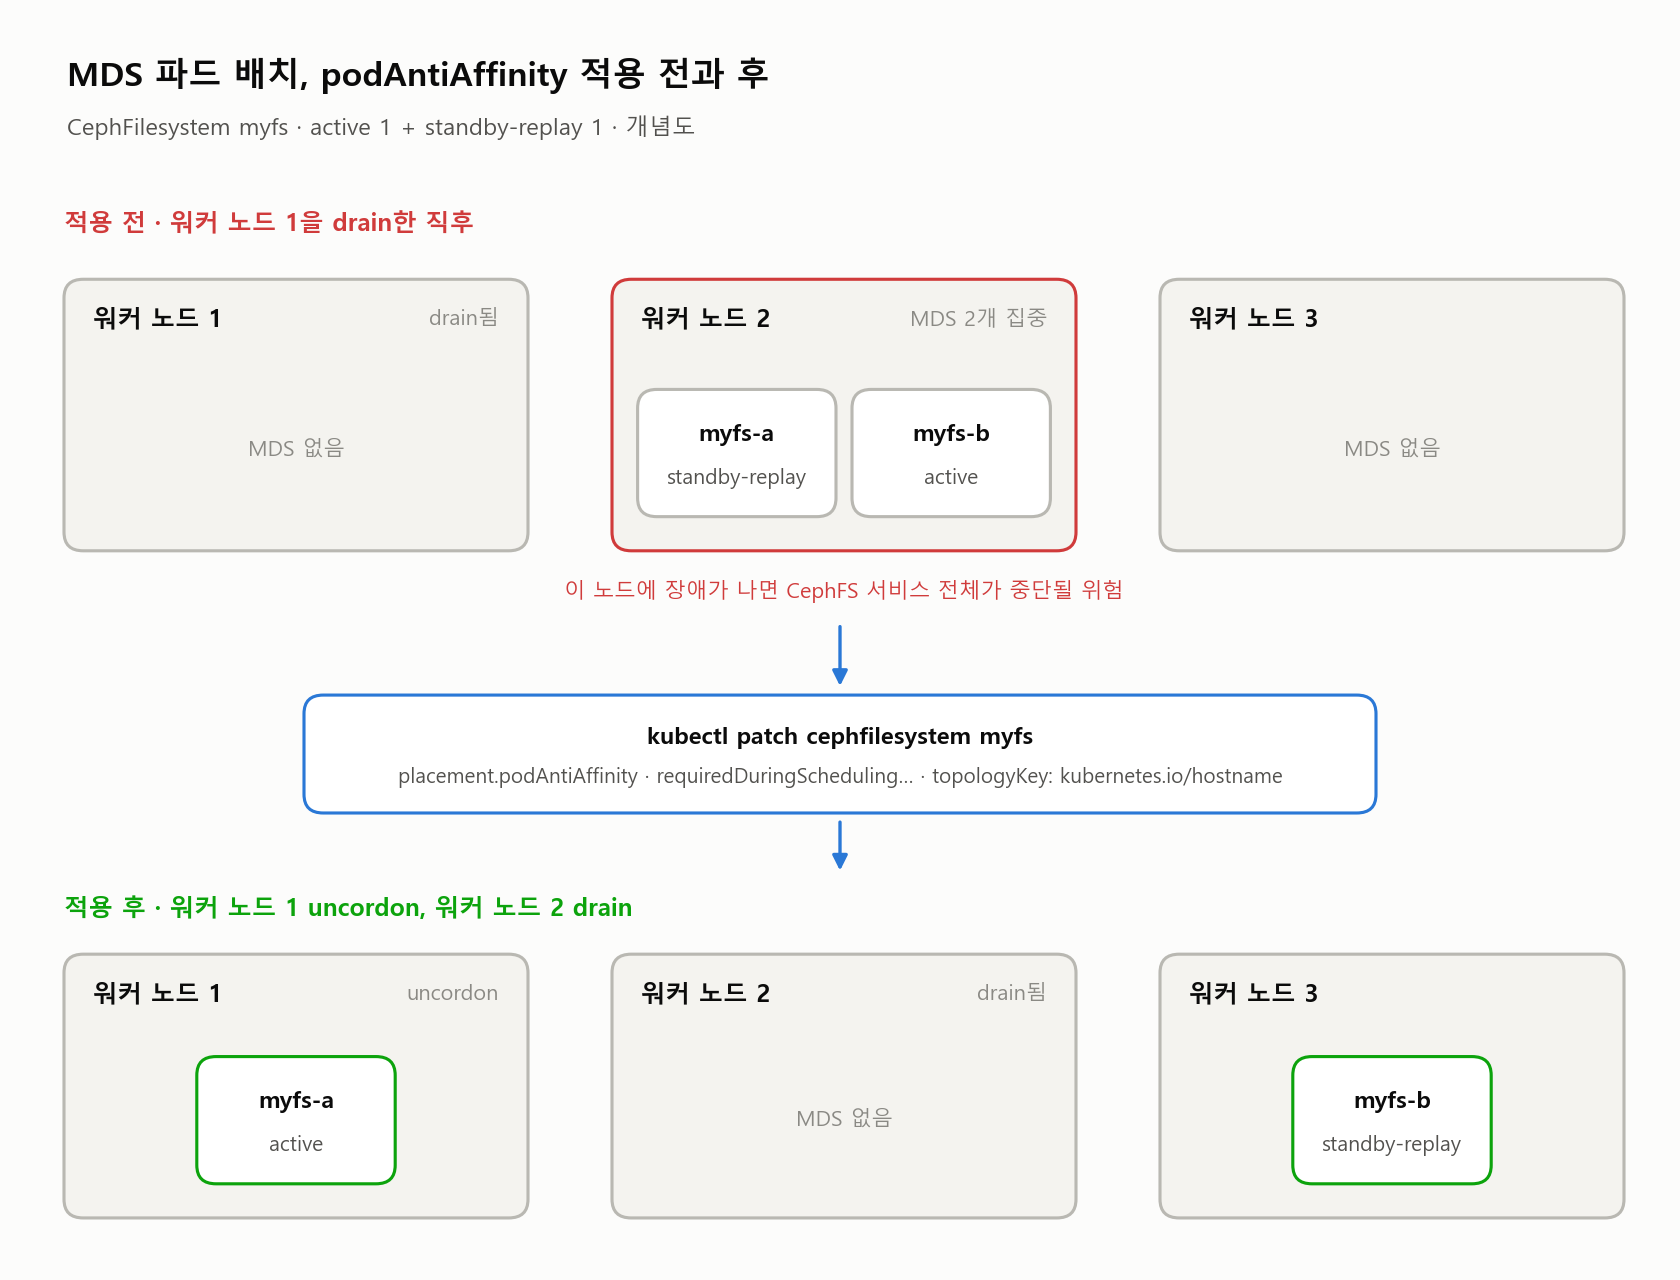
Ceph MDS Pod Anti-Affinity 적용 전에는 MDS 파드 두 개가 워커 노드 2에 몰려 있고, CephFilesystem 패치 후에는 active와 standby-replay가 서로 다른 워커 노드로 나뉘는 배치를 비교한 개념도
podAntiAffinity 적용 후에는 drain 중에도 active와 standby-replay MDS가 서로 다른 노드에 배치됩니다.

문제 상황

워커 노드 1번에 대해 drain을 수행한 후 Ceph 상태를 확인하면 HEALTH_WARN이 발생하고, MDS 파드 2개가 모두 워커 노드 2번에서 기동 중임을 확인할 수 있습니다.

# ceph 상태 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    id:     xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
    health: HEALTH_WARN
            4 mgr modules have recently crashed

  services:
    mon: 3 daemons, quorum a,b,c (age 10h)
    mgr: b(active, since 5M), standbys: a
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up (since 10h), 3 in (since 18M)

# MDS pod 위치 확인 — 두 파드 모두 <worker-node-2>에 집중
<admin-user>@<master-node>:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-77d484dc4-jddf9  2/2  Running  0  18s  172.16.x.x  <worker-node-2>  <none>  <none>
rook-ceph-mds-myfs-b-bd6ddc59b-l2b4t  2/2  Running  0  18s  172.16.x.x  <worker-node-2>  <none>  <none>

원인 분석

ceph fs status에서 확인하면 active MDS와 standby-replay MDS 모두 정상 동작 중이지만, 두 파드가 같은 노드에 배치되어 있어 해당 노드에 장애가 발생하면 CephFS 서비스 전체가 중단될 위험이 있습니다. Anti-Affinity 규칙이 설정되어 있지 않으면 Kubernetes 스케줄러가 가용 자원이 충분한 노드에 임의로 배치하기 때문에 이런 현상이 발생합니다.

# cephFS 상태 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-b  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-a  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)

Ceph MDS Pod Anti-Affinity 적용

CephFilesystem 리소스에 podAntiAffinity를 설정하면 동일 레이블의 MDS 파드가 같은 노드에 배치되지 않도록 강제할 수 있습니다. requiredDuringSchedulingIgnoredDuringExecution을 사용하면 조건을 만족하지 못할 경우 파드가 아예 스케줄링되지 않으므로 강하게 분산을 보장합니다.

# CephFilesystem에 podAntiAffinity 패치 적용
<admin-user>@<master-node>:~$ kubectl -n rook-ceph patch cephfilesystem myfs --type='merge' -p '
spec:
  metadataServer:
    placement:
      podAntiAffinity:
        requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values: ["rook-ceph-mds"]
            - key: rook_file_system
              operator: In
              values: ["myfs"]
          topologyKey: kubernetes.io/hostname
'
cephfilesystem.ceph.rook.io/myfs patched

패치 후 kubectl -n rook-ceph get cephfilesystem myfs -o yaml에서 spec.metadataServer.placement.podAntiAffinity 항목이 반영되었는지 확인합니다.

워커 노드 2번 drain으로 분산 배치 검증

워커 노드 1번을 uncordon하고 워커 노드 2번을 drain하면 MDS 파드가 Ceph MDS Pod Anti-Affinity 규칙에 따라 서로 다른 노드(worker-01, worker-03)에 분산 배치됩니다.

# Anti-Affinity 적용 후 MDS 파드 분산 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-58846844d6-nd5mk  2/2  Running  0  53s  172.16.x.x  <worker-node-1>  <none>  <none>
rook-ceph-mds-myfs-b-6b4d9476cb-q6b6p  2/2  Running  0  38s  172.16.x.x  <worker-node-3>  <none>  <none>

# cephFS 상태 정상 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-a  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-b  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)

mgr crash 알람 처리

MDS 분산 이후에도 4 mgr modules have recently crashed 알람이 남아 있을 수 있습니다. MDS 이슈와는 무관하게 mgr 파드가 재시작되며 남은 crash 이력이므로, ceph mgr stat에서 available: true이면 서비스는 정상입니다. ceph crash archive-all로 이력을 정리하면 알람이 해소됩니다.

# mgr 상태 정상 확인 (available: true)
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph mgr stat
{
    "epoch": 476,
    "available": true,
    "active_name": "b",
    "num_standby": 1
}

# crash 이력 목록 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash ls
ID                                                                ENTITY  NEW
2025-12-26T09:01:17.354121Z_c76c6eaf-4bf7-4cf9-a9ec-f646fe857b76  mgr.b    *
2025-12-26T09:01:32.345473Z_4dfd271c-3d5b-4c89-88cf-13ba096f327b  mgr.b    *
2025-12-26T09:01:47.357321Z_0f938fb6-4c50-4b58-815d-5990fbe4bbb7  mgr.b    *
2025-12-26T09:02:02.329492Z_43d344a7-b71f-442e-a664-1852dda3a3f3  mgr.b    *

# crash 이력 아카이브 후 HEALTH_OK 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash archive-all
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    health: HEALTH_OK
  services:
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up, 3 in

node drain / uncordon 작업 중 일시적으로 mon quorum 이탈이나 rebalancing이 발생할 수 있으나, 일정 시간 후 재확인하면 HEALTH_OK 상태로 복구됩니다.

참고

Ceph 관련 운영 내용은 아래 포스트도 참고하시기 바랍니다.

참고 문서: Rook CephFilesystem CRD 공식 문서 · Kubernetes Pod Anti-Affinity 공식 문서