drain 이후 한 노드로 몰리는 MDS 파드
Kubernetes 클러스터에서 노드 업그레이드나 drain 작업을 수행할 때, Ceph MDS Pod Anti-Affinity 설정이 없으면 MDS 파드 두 개가 동일한 워커 노드에 집중 배치되는 문제가 발생할 수 있습니다. 이 글에서는 node drain 후 MDS 파드가 한 노드에 몰린 상황을 확인하고, CephFilesystem 리소스에 podAntiAffinity 규칙을 적용하여 MDS 파드를 분산 배치하는 과정을 정리합니다. 이어서 함께 발생한 mgr crash 알람 처리 방법도 설명합니다.
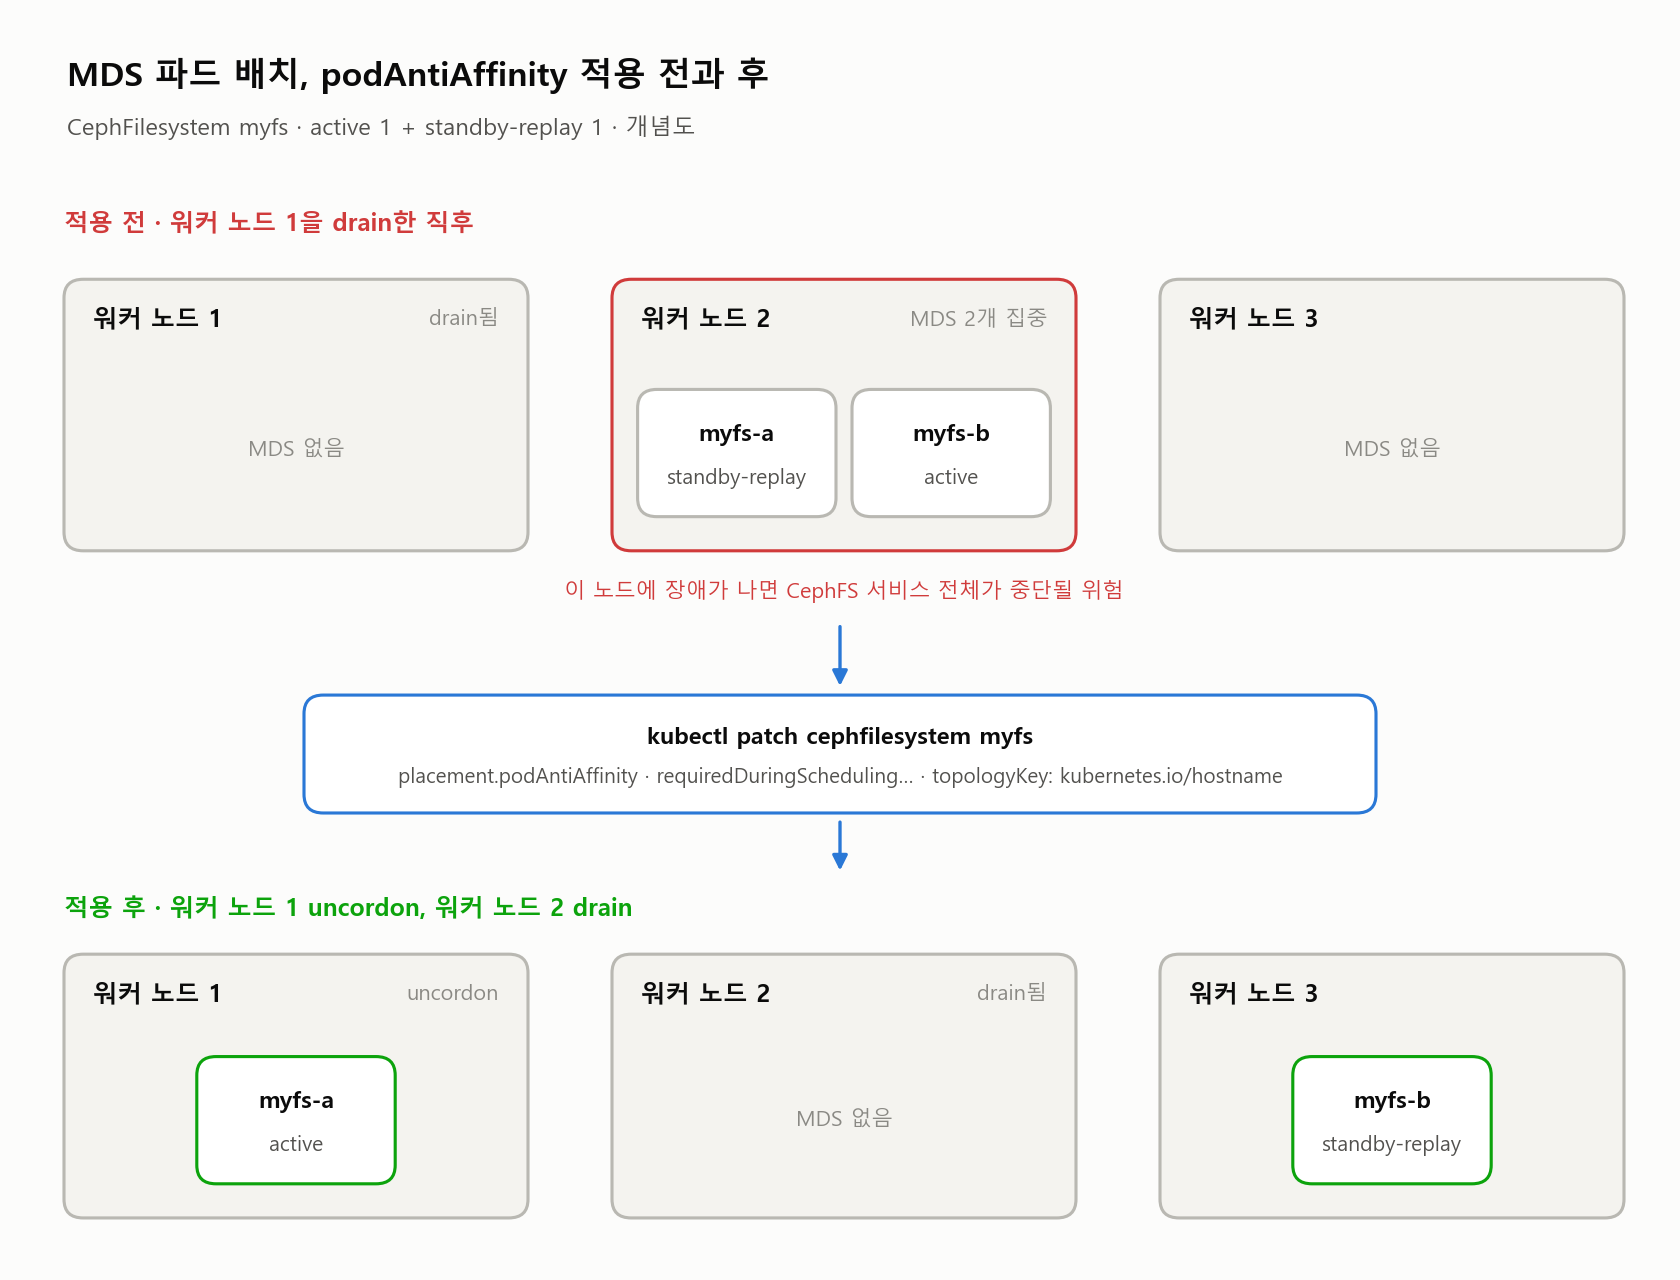
문제 상황
워커 노드 1번에 대해 drain을 수행한 후 Ceph 상태를 확인하면 HEALTH_WARN이 발생하고, MDS 파드 2개가 모두 워커 노드 2번에서 기동 중임을 확인할 수 있습니다.
# ceph 상태 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    id:     xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
    health: HEALTH_WARN
            4 mgr modules have recently crashed

  services:
    mon: 3 daemons, quorum a,b,c (age 10h)
    mgr: b(active, since 5M), standbys: a
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up (since 10h), 3 in (since 18M)

# MDS pod 위치 확인 — 두 파드 모두 <worker-node-2>에 집중
<admin-user>@<master-node>:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-77d484dc4-jddf9  2/2  Running  0  18s  172.16.x.x  <worker-node-2>  <none>  <none>
rook-ceph-mds-myfs-b-bd6ddc59b-l2b4t  2/2  Running  0  18s  172.16.x.x  <worker-node-2>  <none>  <none>
원인 분석
ceph fs status에서 확인하면 active MDS와 standby-replay MDS 모두 정상 동작 중이지만, 두 파드가 같은 노드에 배치되어 있어 해당 노드에 장애가 발생하면 CephFS 서비스 전체가 중단될 위험이 있습니다. Anti-Affinity 규칙이 설정되어 있지 않으면 Kubernetes 스케줄러가 가용 자원이 충분한 노드에 임의로 배치하기 때문에 이런 현상이 발생합니다.
# cephFS 상태 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-b  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-a  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)
Ceph MDS Pod Anti-Affinity 적용
CephFilesystem 리소스에 podAntiAffinity를 설정하면 동일 레이블의 MDS 파드가 같은 노드에 배치되지 않도록 강제할 수 있습니다. requiredDuringSchedulingIgnoredDuringExecution을 사용하면 조건을 만족하지 못할 경우 파드가 아예 스케줄링되지 않으므로 강하게 분산을 보장합니다.
# CephFilesystem에 podAntiAffinity 패치 적용
<admin-user>@<master-node>:~$ kubectl -n rook-ceph patch cephfilesystem myfs --type='merge' -p '
spec:
  metadataServer:
    placement:
      podAntiAffinity:
        requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values: ["rook-ceph-mds"]
            - key: rook_file_system
              operator: In
              values: ["myfs"]
          topologyKey: kubernetes.io/hostname
'
cephfilesystem.ceph.rook.io/myfs patched
패치 후 kubectl -n rook-ceph get cephfilesystem myfs -o yaml에서 spec.metadataServer.placement.podAntiAffinity 항목이 반영되었는지 확인합니다.
워커 노드 2번 drain으로 분산 배치 검증
워커 노드 1번을 uncordon하고 워커 노드 2번을 drain하면 MDS 파드가 Ceph MDS Pod Anti-Affinity 규칙에 따라 서로 다른 노드(worker-01, worker-03)에 분산 배치됩니다.
# Anti-Affinity 적용 후 MDS 파드 분산 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-58846844d6-nd5mk  2/2  Running  0  53s  172.16.x.x  <worker-node-1>  <none>  <none>
rook-ceph-mds-myfs-b-6b4d9476cb-q6b6p  2/2  Running  0  38s  172.16.x.x  <worker-node-3>  <none>  <none>

# cephFS 상태 정상 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-a  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-b  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)
mgr crash 알람 처리
MDS 분산 이후에도 4 mgr modules have recently crashed 알람이 남아 있을 수 있습니다. MDS 이슈와는 무관하게 mgr 파드가 재시작되며 남은 crash 이력이므로, ceph mgr stat에서 available: true이면 서비스는 정상입니다. ceph crash archive-all로 이력을 정리하면 알람이 해소됩니다.
# mgr 상태 정상 확인 (available: true)
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph mgr stat
{
    "epoch": 476,
    "available": true,
    "active_name": "b",
    "num_standby": 1
}

# crash 이력 목록 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash ls
ID                                                                ENTITY  NEW
2025-12-26T09:01:17.354121Z_c76c6eaf-4bf7-4cf9-a9ec-f646fe857b76  mgr.b    *
2025-12-26T09:01:32.345473Z_4dfd271c-3d5b-4c89-88cf-13ba096f327b  mgr.b    *
2025-12-26T09:01:47.357321Z_0f938fb6-4c50-4b58-815d-5990fbe4bbb7  mgr.b    *
2025-12-26T09:02:02.329492Z_43d344a7-b71f-442e-a664-1852dda3a3f3  mgr.b    *

# crash 이력 아카이브 후 HEALTH_OK 확인
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash archive-all
<admin-user>@<master-node>:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    health: HEALTH_OK
  services:
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up, 3 in
node drain / uncordon 작업 중 일시적으로 mon quorum 이탈이나 rebalancing이 발생할 수 있으나, 일정 시간 후 재확인하면 HEALTH_OK 상태로 복구됩니다.
참고
Ceph 관련 운영 내용은 아래 포스트도 참고하시기 바랍니다.
- Ceph OSD down 알람 처리 — 불필요한 OSD 제거 및 클러스터 복구
- Ceph 구축 — Rook-Ceph 초기 구축 가이드
- Ceph Storage Class를 활용한 WordPress/MySQL Pod 생성
참고 문서: Rook CephFilesystem CRD 공식 문서 · Kubernetes Pod Anti-Affinity 공식 문서