카테고리 보관물: Storage

Diagnosing a 9-Second Node Blackout: Rook Tolerations and Control Plane Metrics

개요

워커 노드 한 대가 약 9초 동안 네트워크에서 사라졌습니다. 그 쿠버네티스 노드 순단 하나가 스토리지 컨트롤 파드의 즉시 축출로 번졌고, 결국 상위 워크로드까지 영향을 받았습니다. 정작 처음 눈에 띈 증상은 Ceph 파드가 무더기로 재기동된 것이어서, 저장소 쪽 문제로 오인하기 쉬운 상황이었습니다.

이 글은 그 9초를 어떻게 특정했는지, 그리고 같은 일이 반복되어도 피해가 번지지 않도록 적용한 두 가지 조치를 정리한 운영 기록입니다. 관측 도구 자체가 장애 노드 위에 있을 때 생기는 판단 착오와, 그것을 걷어내기 위해 클러스터 바깥의 관측자를 동원한 과정이 핵심입니다.

환경

구성 요소 내용
Kubernetes v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
컨테이너 런타임 Docker + cri-dockerd
CNI / LB Calico, MetalLB (L2 모드)
스토리지 Rook-Ceph v1.13.10 (mon 3, OSD 3, MDS active+standby)
API 로드밸런서 HAProxy (클러스터 외부 VM, 192.168.x.x:6443)
모니터링 kube-prometheus-stack
가상화 VMware (전 노드 VM)

단계별 절차

1. 최초 관측과 오진

Prometheus에서 장애 시각의 스크레이프 상태를 조회했더니 55개 타깃 중 26개가 같은 1분 구간에 up=0이었습니다. API 서버 3대 전부, kubelet 6대 전부가 포함되어 있어 처음에는 클러스터 전역 네트워크 장애로 판단했습니다.

kubectl exec -n rook-ceph deploy/rook-ceph-tools -- \
  curl -sG "http://<prometheus-svc>:9090/api/v1/query_range" \
  --data-urlencode 'query=up' \
  --data-urlencode "start=<epoch>" --data-urlencode "end=<epoch>" \
  --data-urlencode "step=15"

그런데 이 판단에는 결함이 있었습니다. Prometheus 파드 자체가 문제가 의심되는 워커 노드 위에서 동작하고 있었기 때문입니다. 관측자가 장애 대상 안에 있으면 “모든 타깃이 죽었다”는 결과는 타깃의 상태가 아니라 관측자의 상태를 반영합니다. 게다가 query_range는 직전 값을 최대 5분까지 끌어와 채우므로, 스크레이프가 아예 누락된 구간이 정상값 1로 보이기도 합니다.

2. 클러스터 바깥의 독립 관측자 확보

편향을 걷어내기 위해 클러스터 외부에 있는 HAProxy의 로그를 확인했습니다. HAProxy는 API 서버 3대를 TCP 체크로 상시 감시하고 있으므로, 물리망이나 마스터에 문제가 있었다면 반드시 흔적이 남습니다.

# API 백엔드는 하루 종일 DOWN 이력이 없었음
journalctl -t haproxy --since "YYYY-MM-DD 00:00:00" | grep -iE "DOWN|UP|no server"

Server www.example.com/app1 is DOWN, reason: Layer6 timeout, check duration: 2001ms.
backend 'www.example.com' has no server available!
Server www.example.com/app1 is UP, reason: Layer6 check passed, check duration: 1ms.

결과는 명확했습니다. 6443 백엔드는 DOWN 기록이 한 건도 없었고 NIC 에러·드롭·carrier 카운터도 모두 0이었습니다. 즉 물리망과 마스터 3대는 사건 내내 정상이었습니다. 유일한 이벤트는 Ingress 컨트롤러 백엔드가 9초 동안 Layer6 타임아웃을 낸 것뿐이었습니다.

3. ARP 테이블로 MetalLB L2 소유자 특정

그 백엔드 주소는 MetalLB가 L2로 광고하는 LoadBalancer IP입니다. L2 모드에서는 speaker 하나가 해당 IP를 소유하므로, 그 speaker가 있는 노드가 사라지면 IP도 함께 사라집니다. HAProxy의 ARP 테이블에서 소유자를 바로 확인할 수 있었습니다.

ip neigh show | grep -E "192.168.x."

192.168.x.112 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # worker-node
192.168.x.120 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # LoadBalancer IP - 동일 MAC

LoadBalancer IP의 MAC이 특정 워커 노드의 MAC과 동일했습니다. 여기에 kube-controller-manager 로그가 같은 시각 그 노드의 파드를 축출한 기록이 더해지면서, 서로 독립된 두 관측자가 같은 노드를 지목하게 되었습니다.

taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-operator-..."
taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-mgr-a-..."
taint_eviction.go:111] "Deleting pod" controller="taint-eviction-controller" pod="rook-ceph/rook-ceph-mds-myfs-b-..."

4. 게스트 내부에는 증거가 없음을 확인

노드가 네트워크에서 사라졌다면 게스트 안에도 흔적이 남아야 합니다. 그런데 어느 지표에도 흔적이 없었습니다.

확인 항목 결과
node_network_carrier_changes_total 전 노드 불변 — 링크 플랩 없음
node_network_up 1 유지
node_boot_time_seconds 불변 — 노드 재부팅 없음
kubelet process_start_time_seconds 불변 — kubelet 재시작 없음
calico-node / kube-proxy / CoreDNS 재시작 0회
HAProxy NIC 카운터 error / dropped / carrier 모두 0

링크는 끊기지 않았는데 네트워크에서는 사라졌고, 물리망과 다른 VM은 멀쩡했습니다. 이 조합은 게스트 계층이 아니라 그 바깥, 즉 하이퍼바이저 계층의 순간적인 정지를 시사합니다. 다만 해당 계층의 이벤트 로그에 접근하지 못해 근본 원인 확정까지는 이르지 못했다는 점을 분명히 해 둡니다. 스냅샷이나 백업 스케줄은 없다는 것이 확인되어, 정기 작업 가설은 배제되었습니다.

5. 조치 1 — Rook toleration 완화

9초짜리 순단이 큰 사고가 된 직접적인 이유는 Rook이 자신의 파드에 붙이는 축출 유예 시간이 5초였기 때문입니다. 노드에 unreachable 테인트가 붙자마자 operator·mgr·MDS가 즉시 축출되어 재배치되었습니다.

다행히 데이터 경로인 mon과 OSD에는 이 설정이 적용되지 않습니다. 이들은 쿠버네티스 기본값 300초를 쓰기 때문에 축출되지 않았고, 그래서 Ceph 자체는 HEALTH_OK를 유지했습니다. 유예 시간을 60초로 올렸습니다.

# operator가 관리하는 데몬(mgr, MDS, exporter, crashcollector)에 적용
kubectl set env deploy/rook-ceph-operator -n rook-ceph \
  ROOK_UNREACHABLE_NODE_TOLERATION_SECONDS=60

# operator와 tools 자신의 toleration은 설치 매니페스트가 소유하므로 별도 패치
for d in rook-ceph-operator rook-ceph-tools; do
  kubectl patch deploy -n rook-ceph $d --type=json \
    -p='[{"op":"replace","path":"/spec/template/spec/tolerations/0/tolerationSeconds","value":60}]'
done

이 변경은 operator 파드를 재기동시키고, 이어서 mgr과 MDS 배포본이 순차적으로 롤링됩니다. MDS는 hot standby가 있어 전환이 수 초에 그쳤고, CephFS를 사용하는 워크로드 파드는 재시작 없이 그대로 유지되었습니다.

6. 조치 2 — 컨트롤 플레인 메트릭 노출

사후 분석 과정에서 더 불편했던 것은 etcd·scheduler·controller-manager 지표가 통째로 비어 있었다는 점입니다. 28시간 치를 조회해도 이 세 잡의 스크레이프 성공률이 0%였습니다. 장애 순간 컨트롤 플레인이 어떤 상태였는지 확인할 수단이 아예 없었던 셈입니다.

원인은 단순했습니다. kubeadm 기본값이 세 컴포넌트를 모두 루프백에만 바인딩하기 때문에, 노드 IP로 스크레이프하면 구조적으로 연결이 거부됩니다.

kube-controller-manager   --bind-address=127.0.0.1
kube-scheduler            --bind-address=127.0.0.1
etcd                      --listen-metrics-urls=http://127.0.0.1:2381

마스터 3대의 static pod 매니페스트를 한 대씩 수정했습니다. etcd가 포함되므로 반드시 한 대씩 진행하고, 다음 노드로 넘어가기 전에 쿼럼을 확인해야 합니다.

# 마스터 1대에서 실행 후 검증, 그 다음 노드로 이동
sudo sed -i 's|--bind-address=127.0.0.1|--bind-address=0.0.0.0|' \
  /etc/kubernetes/manifests/kube-controller-manager.yaml \
  /etc/kubernetes/manifests/kube-scheduler.yaml

sudo sed -i -E 's#(- --listen-metrics-urls=).*#\1http://0.0.0.0:2381#' \
  /etc/kubernetes/manifests/etcd.yaml

여기서 한 가지 함정이 있는데, 아래 트러블슈팅에서 따로 다루겠습니다. 그리고 이 수정만으로는 kubeadm upgrade 시점에 매니페스트가 재생성되면서 모두 되돌아갑니다. kubeadm-config ConfigMap에도 같은 인자를 넣어야 영구적으로 유지됩니다.

controllerManager:
  extraArgs:
  - name: bind-address
    value: 0.0.0.0
scheduler:
  extraArgs:
  - name: bind-address
    value: 0.0.0.0
etcd:
  local:
    dataDir: /var/lib/etcd
    extraArgs:
    - name: listen-metrics-urls
      value: http://0.0.0.0:2381

이 ConfigMap은 업그레이드와 join 시점에만 읽히므로, 반영해도 실행 중인 컴포넌트에는 영향이 없고 노드 재기동도 발생하지 않습니다.

트러블슈팅

etcd가 기동하지 않고 마스터 노드가 NotReady로 빠짐

현상 — 첫 마스터에 위 수정을 적용한 직후 해당 노드가 NotReady가 되었습니다. 2379와 6443 포트가 모두 닫혔고, etcd 쿼럼은 2/3로 떨어졌습니다. 호스트 자체는 살아 있어 SSH와 kubelet 포트는 정상이었습니다.

원인 — 처음에 liveness probe를 배려한다는 이유로 루프백을 남긴 채 와일드카드를 덧붙였습니다. 그런데 0.0.0.0은 루프백을 이미 포함하므로 같은 주소를 두 번 바인딩하게 되어 etcd가 기동에 실패했습니다.

# 잘못된 설정
--listen-metrics-urls=http://127.0.0.1:2381,http://0.0.0.0:2381

# etcd 로그
{"level":"fatal","msg":"discovery failed",
 "error":"listen tcp 127.0.0.1:2381: bind: address already in use"}

해결 — 중복을 제거하고 와일드카드만 남겼습니다. 0.0.0.0이 루프백도 커버하므로 127.0.0.1:2381을 보는 liveness probe는 그대로 동작합니다. 수정 후 kubelet이 약 20초 만에 etcd를 재기동했고, 이어서 API 서버와 kubelet이 차례로 붙으면서 노드가 Ready로 복귀했습니다. etcd는 raft term 변화 없이 같은 인덱스로 깨끗하게 재합류했습니다.

sudo sed -i -E 's#(- --listen-metrics-urls=).*#\1http://0.0.0.0:2381#' \
  /etc/kubernetes/manifests/etcd.yaml

kubectl exec -n kube-system etcd-<master-node> -- etcdctl \
  --endpoints=https://192.168.x.101:2379,https://192.168.x.102:2379,https://192.168.x.103:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key endpoint health

이 작업 중 백업 파일을 /etc/kubernetes/manifests/ 안에 만들지 않도록 주의해야 합니다. kubelet이 그 디렉토리를 감시하므로 백업 파일까지 또 하나의 static pod로 읽어 중복 기동을 일으킵니다.

모든 스크레이프 실패를 클러스터 전역 장애로 오독

현상 — 장애 구간에 Prometheus 타깃이 대량으로 up=0이 되어, 마스터를 포함한 클러스터 전체가 끊긴 것처럼 보였습니다.

원인 — Prometheus 파드가 장애 노드 위에 있었습니다. 관측자가 장애 범위 안에 포함되면 “전부 죽었다”는 결과는 타깃이 아니라 관측자의 상태입니다. 여기에 query_range의 lookback 동작이 겹쳐, 스크레이프가 누락된 구간과 정상 구간을 구분할 수 없었습니다.

해결 — 클러스터 밖의 HAProxy 로그와 ARP 테이블을 독립 관측자로 사용해 범위를 다시 그렸습니다. 모니터링 스택이 감시 대상과 같은 장애 도메인에 있으면 그 스택의 데이터만으로는 범위를 확정할 수 없다는 점이 이번 분석의 가장 큰 교훈이었습니다.

결과 확인

조치 이후 쿠버네티스 노드 순단이 발생해도 스토리지 컨트롤 파드가 즉시 축출되지 않으며, 컨트롤 플레인 지표도 사후 분석이 가능한 수준으로 확보되었습니다.

항목 조치 전 조치 후
Rook 파드 축출 유예 5초 60초
etcd / scheduler / controller-manager 스크레이프 0 / 9 성공 9 / 9 성공
kubeadm upgrade 후 설정 유지 되돌아감 유지됨
etcd 쿼럼 3 / 3 3 / 3

변경 직후 뜻하지 않게 실전 검증도 이루어졌습니다. 마지막 마스터를 수정하면서 etcd 리더 선출이 일어났고, 그 여파로 노드 3대가 잠시 NotReady로 표시되었습니다. 기존 5초 설정이었다면 operator와 mgr, MDS가 그대로 축출되었을 상황입니다.

kubectl get pods -n rook-ceph

# 축출된 파드 없음 - AGE가 모두 toleration 변경 시점이거나 그 이전
rook-ceph-operator-...     1/1  Running  0  26m   # 설정 변경 시점
rook-ceph-mgr-a-...        3/3  Running  0  25m
rook-ceph-mds-myfs-a-...   2/2  Running  0  25m
rook-ceph-mon-a-...        2/2  Running  0  35d   # 무변동
rook-ceph-osd-0-...        2/2  Running  0  35d   # 무변동

Ceph 파드 축출은 한 건도 발생하지 않았고, 노드는 자동으로 Ready로 복귀했습니다. 최종 상태는 노드 6대 Ready, 비정상 파드 0, etcd 쿼럼 3/3, Ceph HEALTH_OK입니다.

다만 정직하게 남겨둘 부분이 있습니다. 노드가 왜 9초간 사라졌는지는 아직 확정하지 못했습니다. 이번 조치는 원인 제거가 아니라 피해 범위를 줄이는 완화책이며, 하이퍼바이저 계층의 이벤트 로그를 확보하기 전까지는 재발 가능성이 남아 있습니다.

참고

관련 포스트:

참고 문서: Kubernetes Taints and Tolerations · kubeadm ClusterConfiguration v1beta4 · etcd Monitoring · Rook Ceph Operator Helm Chart

Kubernetes MariaDB Failover with Rook Ceph

개요

Kubernetes MariaDB Failover는 단일 MariaDB Pod가 실행 중인 worker node에서 다른 node로 이동할 때, Rook Ceph RBD 볼륨을 다시 연결하고 데이터베이스 서비스를 복구할 수 있는지 확인한 과정입니다. 별도의 Galera cluster를 구성하지 않고 기존 Deployment와 ReadWriteOnce PVC가 제공하는 장애 복구 범위를 검증하였습니다.

이번 작업에서는 MariaDB 매니페스트와 runtime 설정을 비교하고, 시스템 테이블 업그레이드와 물리 백업을 수행하였습니다. 또한 LoadBalancer 접근 대역을 제한한 뒤 Pod 이동, PVC 재부착, SQL 실행과 서비스 복구 시간까지 단계별로 확인하였습니다.

검증 결과 clean failover에서는 MariaDB Pod가 다른 worker node에 배치되고 기존 데이터를 사용하여 정상적으로 기동하였습니다. 다만 갑작스러운 node 전원 장애는 Pod toleration과 volume fencing 시간이 추가되므로, 이번 결과는 계획된 유지보수 상황의 복구 기준으로 해석해야 합니다.

환경

구성 요소 검증 환경 역할
Kubernetes v1.33 계열, multi control-plane Pod 재스케줄 및 Service 제공
MariaDB 10.11 LTS, single replica Deployment 애플리케이션 데이터베이스
Rook Ceph RBD StorageClass, 10Gi RWO PVC node 간 영구 볼륨 재부착
MetalLB LoadBalancer Service, TCP 3306 클러스터 외부 내부망 연결

MariaDB에는 1Gi memory request와 2Gi limit를 지정하고 InnoDB buffer pool은 512MiB로 설정하였습니다. 점검 전 PVC 여유 공간과 Ceph cluster의 HEALTH_OK 상태를 확인하였습니다. 이 구성은 추가 database replica 없이 Ceph의 storage 내구성과 Kubernetes의 Pod 재스케줄 기능을 활용합니다.

단계별 절차

1. 매니페스트와 운영 상태 확인

먼저 Git에 저장된 PVC, ConfigMap, Deployment, Service를 실제 cluster object와 비교하였습니다. Deployment는 RWO volume의 동시 attach를 피하기 위해 Recreate 전략을 사용하고 있었으며 PVC는 Bound 상태였습니다. Pod, node, Ceph 상태와 최근 event를 함께 확인하여 점검 전에 진행 중인 장애가 없는지도 검증하였습니다.

kubectl get nodes
kubectl get pods -n mariadb-system -o wide
kubectl get pvc mariadb-pv-claim -n mariadb-system -o wide
kubectl get cephcluster -n rook-ceph -o wide
kubectl diff -f manifests/mariadb/mariadb.yaml

Pod의 Running 상태만 확인하지 않고 MariaDB version, InnoDB 설정, 연결 수와 filesystem 사용량을 함께 점검하였습니다. SQL 검사로 시스템 테이블과 실제 적용 변수를 확인해야 매니페스트와 runtime 사이의 차이를 발견할 수 있습니다.

2. 업그레이드 전 물리 백업

시스템 테이블을 변경하기 전에 mariadb-backup으로 전체 data directory의 streaming physical backup을 생성하였습니다. backup stream은 클러스터 외부 경로에서 압축하고 완료 메시지, gzip 무결성, 파일 크기와 SHA-256 checksum을 확인하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" \
  mariadb-backup --backup --stream=xbstream --user=root' \
  | gzip -1 > /secure-backup/mariadb-pre-upgrade.xb.gz

gzip -t /secure-backup/mariadb-pre-upgrade.xb.gz
sha256sum /secure-backup/mariadb-pre-upgrade.xb.gz

Ceph replica는 disk와 OSD 장애에 대한 내구성을 제공하지만 잘못된 SQL이나 시스템 테이블 변경을 되돌리는 backup은 아닙니다. 따라서 storage 상태가 정상이더라도 database upgrade 전에는 독립적인 backup이 필요합니다.

3. MariaDB 시스템 테이블 업그레이드

점검 과정에서 MariaDB binary와 data directory의 시스템 테이블 형식이 일치하지 않는 문제를 확인하였습니다. mysql.user view와 mysql.event, mysql.proc, mysql.column_stats에서 column definition 오류가 발생하였습니다. 기존 upgrade marker로 인해 일반 검사가 완료 상태로 판단하였으므로 backup을 확인한 뒤 --force 옵션을 적용하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" mariadb-upgrade -uroot --force'

업그레이드 후 문제 테이블을 다시 검사하여 모두 OK 상태인 것을 확인하였습니다. application schema의 table 개수는 이전과 동일하였으며 startup log에서도 기존 definition 오류가 재발하지 않았습니다.

4. LoadBalancer 접근 소스 제한

MariaDB LoadBalancer는 클러스터 외부의 내부망 애플리케이션 서버가 접속하기 위해 유지하였습니다. 모든 source를 허용하지 않도록 loadBalancerSourceRanges에 접근 가능한 CIDR만 지정하였습니다. 아래 문서용 CIDR은 적용 환경에서 허용할 내부 대역으로 변경해야 합니다.

spec:
  type: LoadBalancer
  loadBalancerSourceRanges:
    - 192.0.2.0/24
  ports:
    - name: mariadb
      port: 3306
      targetPort: 3306

적용 전 client dry-run과 server-side diff로 Service 이외의 resource가 변경되지 않는지 확인하였습니다. 적용 후에는 source range, LoadBalancer VIP, EndpointSlice와 cluster 내부 database 연결을 검증하였습니다. NodePort가 별도 경로로 노출될 수 있으므로 routed network가 있다면 node firewall과 상위 network ACL도 함께 확인해야 합니다.

5. Clean failover 시험

node 전체를 종료하면 같은 node의 다른 workload에도 영향을 줄 수 있습니다. 이번 시험에서는 영향 범위를 MariaDB로 제한하기 위해 현재 node를 cordon하고 MariaDB Pod만 재생성하였습니다. 다음 명령은 backup과 영향 범위를 확인한 유지보수 환경에서 실행해야 합니다.

kubectl cordon <worker-node-a>
kubectl delete pod <mariadb-pod> -n mariadb-system --wait=false
kubectl get pods -n mariadb-system -l app=mariadb -o wide --watch
kubectl get volumeattachment -o wide
kubectl uncordon <worker-node-a>

LoadBalancer TCP 3306을 짧은 간격으로 확인하여 서비스 중단과 복구 시점을 기록하였습니다. 새 Pod는 <worker-node-b>에 배치되었으며 기존 RBD attachment가 해제된 후 같은 PVC를 연결하였습니다. container 시작과 readiness probe가 완료된 뒤 LoadBalancer 접속도 다시 성공하였습니다.

6. 복구 후 데이터베이스 검증

새 node에서 MariaDB가 Ready 상태가 된 뒤 version, system table, application schema, active connection과 startup log를 다시 검사하였습니다. TCP port만 확인하지 않고 실제 SQL query와 Ceph health, VolumeAttachment 대상 node까지 함께 비교하였습니다.

CHECK TABLE mysql.user;
CHECK TABLE mysql.event;
CHECK TABLE mysql.proc;
CHECK TABLE mysql.column_stats;

SELECT VERSION();
SELECT 1 AS read_test;

검증 완료 후 원래 node를 uncordon하여 scheduler가 다시 사용할 수 있도록 복원하였습니다. MariaDB Pod는 새 node에서 계속 실행되었으며 불필요한 추가 재시작은 발생하지 않았습니다.

트러블슈팅

시스템 테이블 형식 불일치

현상: MariaDB 접속은 가능했지만 system view와 statistics table 오류가 반복되었고 Event Scheduler 초기화도 실패하였습니다.

원인: container image의 MariaDB patch version은 변경되었지만 data directory의 일부 system table과 privilege가 현재 binary 형식으로 정리되지 않았습니다. 기존 upgrade marker로 인해 자동 검사는 추가 작업이 필요하지 않다고 판단하였습니다.

해결: physical backup을 확보한 뒤 mariadb-upgrade --force를 실행하고 system table을 재검사하였습니다. 모든 table이 OK 상태가 되었으며 이후 startup에서도 동일한 오류가 발생하지 않았습니다.

RBD Multi-Attach 경고

현상: 새 Pod가 다른 worker node에 생성된 직후 volume이 이전 Pod에서 사용 중이라는 Multi-Attach warning이 한 차례 발생하였습니다.

원인: ReadWriteOnce RBD volume의 이전 attachment 정리와 새 attachment 요청 사이에 짧은 시간 차이가 있었습니다. 이는 두 node가 같은 block volume을 동시에 사용하지 못하도록 보호하는 정상적인 동작입니다.

해결: 이전 Pod가 종료되고 CSI controller가 attachment를 정리할 때까지 기다렸으며 잠시 후 attach가 자동으로 성공하였습니다. 이전 node의 상태를 확인하지 않고 VolumeAttachment를 강제로 삭제하면 data corruption 위험이 있으므로 피해야 합니다.

TCP 점검으로 증가한 Aborted Connections

현상: failover 측정 후 Aborted_connects 값과 unauthenticated connection warning이 증가하였습니다.

원인: TCP port monitor가 MariaDB protocol authentication을 수행하지 않고 연결 직후 종료했기 때문입니다.

해결: 측정 종료 후 증가가 멈추는지 확인하였습니다. 상시 monitoring에는 단순 TCP connect 대신 권한이 제한된 health check 계정으로 ping 또는 query를 실행하는 방식이 적합합니다.

Clean failover와 실제 node 장애의 차이

현상: clean failover는 약 30초대에 완료되었지만 실제 node 장애도 같은 시간에 복구된다고 단정할 수 없습니다.

원인: 비정상 장애에서는 Kubernetes가 NotReady 또는 Unreachable 상태를 판단하고 Pod toleration이 만료될 때까지 기다립니다. 기존 node의 volume attachment가 남아 있다면 CSI fencing과 detach에도 시간이 필요합니다.

해결: 이번 결과는 계획된 유지보수 상황의 RTO로 기록하였습니다. 갑작스러운 전원 장애는 수 분 이상의 RTO를 예상하고 별도 점검에서 node shutdown과 MetalLB 경로 전환을 포함하여 검증해야 합니다.

결과 확인

Kubernetes MariaDB Failover 시험 결과, 단일 MariaDB Deployment와 Rook Ceph RWO PVC 구성에서도 계획된 Pod 이동 후 다른 worker node에서 데이터베이스를 정상적으로 기동할 수 있었습니다. 기존 데이터, system table, application schema, SQL query와 Ceph health가 모두 정상임을 확인하였습니다.

검증 항목 결과
다른 worker node에 Pod 배치 성공
기존 RBD PVC 재부착 성공
MariaDB 기동 및 SQL 실행 정상
LoadBalancer 서비스 복구 약 30초대
갑작스러운 node 전원 장애 이번 시험 범위에서 제외

측정 시간에는 기존 Pod 종료, RBD detach와 attach, container 시작, MariaDB 기동과 readiness probe 통과가 포함됩니다. 실제 복구 시간은 image cache, node 부하, Ceph 상태와 transaction recovery 양에 따라 달라질 수 있습니다.

현재 workload 규모에서는 Galera cluster의 추가 memory와 storage 소비보다 단일 instance, Ceph RBD, 정기 physical backup과 source-restricted LoadBalancer 조합이 적합하다고 판단하였습니다. 향후 RTO와 RPO 요구가 강화되면 asynchronous replica 또는 Galera와 database proxy 도입을 다시 검토할 수 있습니다.

storage replica는 backup을 대체하지 않습니다. 정기 backup, checksum 검증, 별도 위치 보관과 restore test를 함께 운영해야 node 장애뿐 아니라 운영 실수와 데이터 손상에도 대응할 수 있습니다.

참고

관련 포스트:

참고 문서: Kubernetes Service · MariaDB Upgrade · MariaDB Backup · Rook Ceph Block Storage

Ceph MDS Pod Anti-Affinity Troubleshoot

개요

Kubernetes 클러스터에서 노드 업그레이드나 drain 작업을 수행할 때, Ceph MDS Pod Anti-Affinity 설정이 없으면 MDS 파드 두 개가 동일한 워커 노드에 집중 배치되는 문제가 발생할 수 있습니다. 이 글에서는 node drain 후 MDS 파드가 한 노드에 몰린 상황을 확인하고, CephFilesystem 리소스에 podAntiAffinity 규칙을 적용하여 MDS 파드를 분산 배치하는 과정을 정리합니다. 이어서 함께 발생한 mgr crash 알람 처리 방법도 설명합니다.

문제 상황

워커 노드 1번에 대해 drain을 수행한 후 Ceph 상태를 확인하면 HEALTH_WARN이 발생하고, MDS 파드 2개가 모두 워커 노드 2번에서 기동 중임을 확인할 수 있습니다.

# ceph 상태 확인
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    id:     d874b4ea-8deb-4aa3-a3ac-e750180a6a5b
    health: HEALTH_WARN
            4 mgr modules have recently crashed

  services:
    mon: 3 daemons, quorum a,b,c (age 10h)
    mgr: b(active, since 5M), standbys: a
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up (since 10h), 3 in (since 18M)

# MDS pod 위치 확인 — 두 파드 모두 test-worker-02에 집중
test@test-master-01:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-77d484dc4-jddf9  2/2  Running  0  18s  172.16.x.x  test-worker-02  <none>  <none>
rook-ceph-mds-myfs-b-bd6ddc59b-l2b4t  2/2  Running  0  18s  172.16.x.x  test-worker-02  <none>  <none>

원인 분석

ceph fs status에서 확인하면 active MDS와 standby-replay MDS 모두 정상 동작 중이지만, 두 파드가 같은 노드에 배치되어 있어 해당 노드에 장애가 발생하면 CephFS 서비스 전체가 중단될 위험이 있습니다. Anti-Affinity 규칙이 설정되어 있지 않으면 Kubernetes 스케줄러가 가용 자원이 충분한 노드에 임의로 배치하기 때문에 이런 현상이 발생합니다.

# cephFS 상태 확인
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-b  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-a  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)

Ceph MDS Pod Anti-Affinity 적용

CephFilesystem 리소스에 podAntiAffinity를 설정하면 동일 레이블의 MDS 파드가 같은 노드에 배치되지 않도록 강제할 수 있습니다. requiredDuringSchedulingIgnoredDuringExecution을 사용하면 조건을 만족하지 못할 경우 파드가 아예 스케줄링되지 않으므로 강하게 분산을 보장합니다.

# CephFilesystem에 podAntiAffinity 패치 적용
test@test-master-01:~$ kubectl -n rook-ceph patch cephfilesystem myfs --type='merge' -p '
spec:
  metadataServer:
    placement:
      podAntiAffinity:
        requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values: ["rook-ceph-mds"]
            - key: rook_file_system
              operator: In
              values: ["myfs"]
          topologyKey: kubernetes.io/hostname
'
cephfilesystem.ceph.rook.io/myfs patched

패치 후 kubectl -n rook-ceph get cephfilesystem myfs -o yaml에서 spec.metadataServer.placement.podAntiAffinity 항목이 반영되었는지 확인합니다.

결과 확인

워커 노드 1번을 uncordon하고 워커 노드 2번을 drain하면 MDS 파드가 Ceph MDS Pod Anti-Affinity 규칙에 따라 서로 다른 노드(worker-01, worker-03)에 분산 배치됩니다.

# Anti-Affinity 적용 후 MDS 파드 분산 확인
test@test-master-01:~$ kubectl -n rook-ceph get pod -o wide | egrep 'mds'
rook-ceph-mds-myfs-a-58846844d6-nd5mk  2/2  Running  0  53s  172.16.x.x  test-worker-01  <none>  <none>
rook-ceph-mds-myfs-b-6b4d9476cb-q6b6p  2/2  Running  0  38s  172.16.x.x  test-worker-03  <none>  <none>

# cephFS 상태 정상 확인
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph fs status
myfs - 2 clients
====
RANK      STATE          MDS     ACTIVITY     DNS    INOS   DIRS   CAPS
 0        active        myfs-a  Reqs:  0 /s  35.9k  18.0k  4301      2
0-s   standby-replay   myfs-b  Evts:  0 /s  35.9k  18.0k  4301      0
MDS version: ceph version 18.2.2 reef (stable)

mgr crash 알람 처리

MDS 분산 이후에도 4 mgr modules have recently crashed 알람이 남아 있을 수 있습니다. 이는 MDS 이슈와 무관하게 mgr 파드가 재시작되며 발생한 crash 이력으로, ceph mgr stat에서 available: true이면 서비스는 정상입니다. ceph crash archive-all로 이력을 정리하면 알람이 해소됩니다.

# mgr 상태 정상 확인 (available: true)
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph mgr stat
{
    "epoch": 476,
    "available": true,
    "active_name": "b",
    "num_standby": 1
}

# crash 이력 목록 확인
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash ls
ID                                                                ENTITY  NEW
2025-12-26T09:01:17.354121Z_c76c6eaf-4bf7-4cf9-a9ec-f646fe857b76  mgr.b    *
2025-12-26T09:01:32.345473Z_4dfd271c-3d5b-4c89-88cf-13ba096f327b  mgr.b    *
2025-12-26T09:01:47.357321Z_0f938fb6-4c50-4b58-815d-5990fbe4bbb7  mgr.b    *
2025-12-26T09:02:02.329492Z_43d344a7-b71f-442e-a664-1852dda3a3f3  mgr.b    *

# crash 이력 아카이브 후 HEALTH_OK 확인
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph crash archive-all
test@test-master-01:~$ kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- ceph status
  cluster:
    health: HEALTH_OK
  services:
    mds: 1/1 daemons up, 1 hot standby
    osd: 3 osds: 3 up, 3 in

node drain / uncordon 작업 중 일시적으로 mon quorum 이탈이나 rebalancing이 발생할 수 있으나, 일정 시간 후 재확인하면 HEALTH_OK 상태로 복구됩니다.

참고

Ceph 관련 운영 내용은 아래 포스트도 참고하시기 바랍니다.

참고 문서: Rook CephFilesystem CRD 공식 문서 · Kubernetes Pod Anti-Affinity 공식 문서

ceph dashboard OSD alarm troubleshoot

개요

Rook-Ceph 운영 중 Ceph OSD down 알람 처리가 필요한 상황이 발생할 수 있습니다. Kubernetes 클러스터에서 Rook-Ceph를 운영하다 보면 대시보드에 OSD down 경고가 표시되는 경우가 있습니다. 이 글에서는 osd.3이 host 지정 없이 down 상태로 클러스터에 등록된 원인을 분석하고, 불필요한 OSD를 안전하게 제거하여 클러스터를 정상 상태로 복구하는 과정을 단계별로 정리합니다.

문제 상황

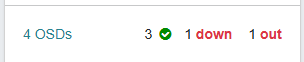
Ceph 대시보드에서 OSD 1 down 알람이 발생하였습니다.

Ceph 대시보드 OSD down 알람 경고 화면

ceph status를 확인하면 osd: 4 osds: 3 up으로 OSD 4개 중 3개만 정상 동작 중이며 HEALTH_WARN 상태입니다. 클러스터 용량(90 GiB) 대비 사용량(7.4 GiB)은 정상이며, 함께 표시된 mon b is low on available space는 Monitor 노드의 디스크 공간 문제로 OSD down 이슈와는 별개입니다.

bash-4.4$ ceph status
  cluster:
    id:     d874b4ea-8deb-4aa3-a3ac-e750180a6a5b
    health: HEALTH_WARN
            mon b is low on available space

  services:
    mon: 3 daemons, quorum a,b,c (age 4M)
    mgr: b(active, since 4M), standbys: a
    mds: 1/1 daemons up, 1 hot standby
    osd: 4 osds: 3 up (since 4M), 3 in (since 13M)

  data:
    volumes: 1/1 healthy
    pools: 5 pools, 113 pgs
    objects: 20.17k objects, 871 MiB
    usage: 7.4 GiB used, 83 GiB / 90 GiB avail
    pgs: 113 active+clean

bash-4.4$ ceph osd status
ID  HOST           USED  AVAIL  WR OPS  WR DATA  RD OPS  RD DATA  STATE
 0  <worker-node>  2515M  27.5G      0        0       1       90   exists,up
 1  <worker-node>  2511M  27.5G      0        0       0        0   exists,up
 2  <worker-node>  2544M  27.5G      0        0       1       16   exists,up
 3                     0      0      0        0       0        0   autoout,exists,new

원인 분석

ceph osd tree 결과를 보면 osd.3이 host 정보 없이 autoout, exists, new 상태로 등록되어 있습니다. 워커 노드 3대(<worker-node>/02/03)에 OSD가 각각 1개씩 정상 배치(osd.0~2)되어 있는 반면, osd.3은 노드에 연결되지 않은 채 클러스터에만 등록된 고아(orphan) 상태입니다. 노드 수보다 OSD 수가 많아진 경우 이런 현상이 발생할 수 있으며, 수동으로 제거해야 합니다.

bash-4.4$ ceph osd tree
ID  CLASS  WEIGHT   TYPE NAME            STATUS  REWEIGHT  PRI-AFF
-1         0.08789  root default
-3         0.02930      host <worker-node>
 0   ssd   0.02930          osd.0            up   1.00000  1.00000
-5         0.02930      host <worker-node>
 1   ssd   0.02930          osd.1            up   1.00000  1.00000
-7         0.02930      host <worker-node>
 2   ssd   0.02930          osd.2            up   1.00000  1.00000
 3            0               osd.3          down       0  1.00000

처리 절차

불필요한 OSD를 제거할 때는 반드시 CRUSH map 제거 → CephX 인증 키 삭제 → OSD 항목 삭제 순서로 진행합니다. 순서를 지키지 않으면 클러스터에 인증 키나 항목이 잔류하여 이후에도 알람이 발생할 수 있습니다.

# ① CRUSH map에서 제거 (이미 등록되지 않은 경우 아래 메시지가 출력되며 정상)
bash-4.4$ ceph osd crush remove osd.3
device 'osd.3' does not appear in the crush map

# ② CephX 인증 키 삭제
bash-4.4$ ceph auth del osd.3

# ③ OSD 항목 최종 삭제
bash-4.4$ ceph osd rm 3
removed osd.3
  • ceph osd crush remove: 데이터 배치 알고리즘인 CRUSH map에서 OSD를 제거합니다. 처음부터 CRUSH map에 등록되지 않았다면 “does not appear” 메시지가 출력되며 이는 정상입니다.
  • ceph auth del: 해당 OSD에 부여된 CephX 인증 키를 삭제합니다.
  • ceph osd rm: 클러스터 OSD 목록에서 항목을 최종 삭제합니다.

결과 확인

OSD 제거 후 ceph osd tree를 다시 확인하면 osd.3이 사라지고 워커 노드당 OSD 1개씩 총 3개가 정상 배치된 것을 확인할 수 있습니다. 이로써 Ceph OSD down 알람 처리가 완료되고 클러스터가 정상 상태로 복구되었습니다.

bash-4.4$ ceph osd tree
ID  CLASS  WEIGHT   TYPE NAME            STATUS  REWEIGHT  PRI-AFF
-1         0.08789  root default
-3         0.02930      host <worker-node>
 0   ssd   0.02930          osd.0            up   1.00000  1.00000
-5         0.02930      host <worker-node>
 1   ssd   0.02930          osd.1            up   1.00000  1.00000
-7         0.02930      host <worker-node>
 2   ssd   0.02930          osd.2            up   1.00000  1.00000

Ceph 관련 운영 내용은 아래 포스트도 참고하시기 바랍니다.

참고 문서: Rook Ceph OSD Management · Ceph OSD Operations (공식 문서)

ceph storage class 사용 wordpress, mysql pod 생성

개요

Rook-Ceph 구축 이후 Ceph StorageClass를 활용하면 Kubernetes Pod에서 PVC(PersistentVolumeClaim)를 통해 Ceph RBD(RADOS Block Device) 기반의 영구 볼륨을 동적으로 프로비저닝할 수 있습니다. Pod가 삭제되거나 재스케줄링되어도 데이터가 Ceph에 안전하게 보존됩니다.

이 글에서는 Ceph RBD StorageClass를 생성하고, PVC가 포함된 MySQL과 WordPress Deployment를 배포하는 전체 절차를 정리합니다. MetalLB LoadBalancer를 통해 WordPress에 외부 IP가 할당되어 실제 서비스 접근까지 확인합니다. 이 구성은 Rook-Ceph 구축이 완료된 환경을 전제합니다.

사전 준비

이 절차를 진행하기 전에 다음 구성 요소가 준비되어 있어야 합니다.

  • Rook-Ceph 클러스터가 정상 기동 중 (ceph status에서 HEALTH_OK)
  • MetalLB가 구성되어 있고 LoadBalancer IP 풀이 설정된 상태
  • Rook 저장소 클론이 로컬에 존재 (rook/deploy/examples/ 디렉토리 필요)

Rook 예제 디렉토리에는 mysql.yaml, wordpress.yaml, csi/rbd/storageclass.yaml이 포함되어 있습니다. 이 파일들을 기반으로 StorageClass를 생성하고 WordPress와 MySQL을 배포합니다.

Ceph StorageClass 생성

Rook 저장소의 csi/rbd/storageclass.yaml을 적용하면 rook-ceph-block StorageClass가 생성됩니다. 이후 Pod에서 storageClassName: rook-ceph-block으로 PVC를 요청하면 Ceph RBD 볼륨이 자동으로 생성·마운트됩니다.

StorageClass의 reclaimPolicy: Delete는 PVC 삭제 시 볼륨도 함께 삭제됨을 의미합니다. 데이터를 보존해야 하는 경우 Retain으로 변경해야 합니다. allowVolumeExpansion: true로 설정되어 있어 운영 중에도 PVC의 용량을 늘릴 수 있습니다.

kubectl apply -f csi/rbd/storageclass.yaml

kubectl get storageclass
NAME              PROVISIONER                  RECLAIMPOLICY   VOLUMEBINDINGMODE   ALLOWVOLUMEEXPANSION
rook-ceph-block   rook-ceph.rbd.csi.ceph.com   Delete          Immediate           true
Ceph RBD StorageClass 적용 확인

MySQL Deployment 배포 (PVC 포함)

Service, PersistentVolumeClaim, Deployment가 포함된 MySQL manifest를 배포합니다. PVC가 생성되면 Rook CSI 드라이버가 Ceph 클러스터에 RBD 이미지를 자동으로 생성하고, kubelet이 해당 볼륨을 Pod에 마운트합니다. PVC Status가 Bound이면 Ceph RBD 볼륨이 정상 마운트된 것입니다.

MySQL Deployment의 환경변수(MYSQL_ROOT_PASSWORD 등)는 실제 운영 환경에서 Secret 리소스로 분리하는 것을 권장합니다. 또한 MySQL 데이터 디렉토리(/var/lib/mysql)를 PVC에 마운트하므로, Pod를 재시작하거나 노드가 변경되어도 데이터가 보존됩니다.

kubectl create -f mysql.yaml
service/wordpress-mysql created
persistentvolumeclaim/mysql-pv-claim created
deployment.apps/wordpress-mysql created

kubectl get pvc
NAME             STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS      AGE
mysql-pv-claim   Bound    pvc-6d458ff1-54bf-4f34-b010-a0f4b2a0966e  20Gi       RWO            rook-ceph-block   94s

WordPress Deployment 배포 (PVC 포함)

MySQL과 동일하게 Service, PVC, Deployment가 포함된 WordPress manifest를 배포합니다. WordPress는 업로드 파일 등을 /var/www/html에 저장하는데, 이 디렉토리가 PVC에 마운트되어 Pod 재시작 후에도 데이터가 유지됩니다. WordPress 서비스 타입은 LoadBalancer로 설정되어 MetalLB로부터 외부 IP를 할당받습니다.

kubectl create -f wordpress.yaml
service/wordpress created
persistentvolumeclaim/wp-pv-claim created
deployment.apps/wordpress created

kubectl get pod
NAME                               READY   STATUS    RESTARTS   AGE
wordpress-7cf5c5c8b-5cgqk          1/1     Running   0          42s
wordpress-mysql-6f99c59595-9vs7z   1/1     Running   0          4m8s

MetalLB로 외부 접근 확인

MetalLB가 구성된 환경에서는 WordPress Service에 외부 IP가 자동 할당됩니다. 해당 IP로 브라우저에서 접속하면 WordPress 설치 화면이 표시되며, Ceph 기반 영구 스토리지 구성이 완료된 것입니다.

이 구성에서 WordPress와 MySQL은 서로 다른 Ceph RBD PVC를 사용합니다. 스토리지 레이어가 Ceph로 추상화되어 있기 때문에, 향후 WordPress나 MySQL Pod를 다른 Worker 노드로 재스케줄링해도 동일한 데이터에 접근할 수 있습니다. PVC의 accessMode: ReadWriteOnce(RWO) 특성상 한 번에 한 Pod만 볼륨에 마운트할 수 있으며, 수평 확장이 필요한 경우에는 CephFS(RWX)를 사용해야 합니다.

kubectl get svc wordpress
NAME        TYPE           CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
wordpress   LoadBalancer   x.x.x.x         x.x.x.x       80:31494/TCP   27s

배포 결과 및 볼륨 확인

모든 리소스 배포 후 아래 명령어로 최종 상태를 확인합니다. PVC가 Bound, Pod가 Running, Service에 외부 IP가 할당된 것이 정상 상태입니다.

# PVC 상태 확인 (Bound이면 정상)
kubectl get pvc

# Pod 상태 확인
kubectl get pods

# WordPress Service 외부 IP 확인
kubectl get svc wordpress

# Ceph에서 실제 RBD 이미지 확인 (Toolbox Pod 내에서)
kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- bash
rbd ls replicapool

PVC가 Pending 상태에서 멈추는 경우 주요 원인으로는 Ceph 클러스터 상태 이상(HEALTH_WARN 이상), StorageClass 미적용, 또는 Rook CSI 드라이버 Pod 이상이 있습니다. kubectl describe pvc <pvc-name>으로 이벤트를 확인하고 조치합니다.

참고

관련 포스트:

참고 문서: Rook Ceph Block Storage 공식 문서 · Kubernetes Persistent Volumes 공식 문서

ceph 구축

개요

Rook은 Kubernetes용 스토리지 오케스트레이터로, Ceph 구축을 Kubernetes 네이티브 방식으로 자동화합니다. Rook-Ceph를 사용하면 Worker 노드에 연결된 Raw Disk를 기반으로 분산 오브젝트 스토리지를 구성하고, Kubernetes PersistentVolume(PV)을 동적으로 프로비저닝할 수 있습니다. Pod가 PersistentVolumeClaim(PVC)을 요청하면 Ceph RBD(Block Device) 또는 CephFS를 통해 영구 저장소가 자동으로 할당됩니다.

이 글에서는 Rook Operator를 배포하고 Ceph Cluster를 구성하는 전체 절차를 정리합니다. 최소 Worker 노드 3개와 각 노드에 파티션 또는 포맷이 되지 않은 Raw Disk가 필요합니다.

사전 준비 — Worker 노드 Raw Disk 확인

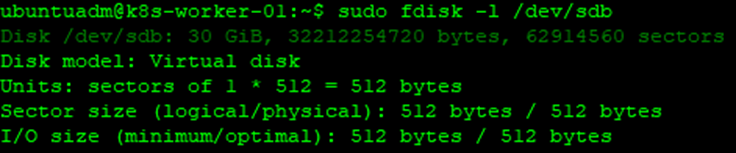
Ceph 스토리지는 각 Worker 노드에 할당된 초기화된(파티션/포맷 없는) Raw Disk를 OSD(Object Storage Daemon)로 사용합니다. 아래는 Worker 노드에 할당된 Raw Device 목록입니다.

OSD 외에도 Ceph는 여러 핵심 컴포넌트로 구성됩니다. MON(Monitor)은 클러스터 상태 맵을 관리하며 Quorum을 형성하기 위해 홀수(최소 3개)로 배포합니다. MGR(Manager)은 Ceph 대시보드와 메트릭 수집을 담당합니다. Rook Operator는 이 모든 컴포넌트를 Kubernetes CRD로 선언적으로 관리합니다.

Worker 노드에 할당된 raw device 목록

Rook Operator 배포

Rook 공식 저장소에서 특정 버전을 클론한 뒤, CRD(Custom Resource Definition), 공통 리소스, Operator를 순서대로 배포합니다. Operator Pod가 정상 기동된 것을 확인한 뒤 Ceph Cluster를 배포합니다.

crds.yaml은 CephCluster, CephBlockPool 등 Rook이 사용하는 커스텀 리소스 타입을 등록합니다. common.yaml은 RBAC, ServiceAccount 등 공통 리소스를 생성하며, operator.yaml은 Rook Operator Deployment를 배포합니다. Operator는 rook-ceph 네임스페이스에서 실행되며, 이후 적용되는 CephCluster CR을 감지하여 Ceph 컴포넌트를 자동으로 생성합니다.

git clone --single-branch --branch v1.10.10 https://github.com/rook/rook.git
cd rook/deploy/examples

kubectl create -f crds.yaml -f common.yaml -f operator.yaml

# Operator Pod 기동 확인
kubectl -n rook-ceph logs -l app=rook-ceph-operator -f

Ceph Cluster 배포

cluster.yaml을 적용하면 Rook Operator가 OSD, MON, MGR 등 Ceph 컴포넌트를 자동으로 생성합니다. 초기 배포 시 Raw Disk를 OSD로 포맷하는 작업이 포함되어 있어 5~10분 정도 소요될 수 있습니다.

기본 cluster.yaml은 클러스터 내 모든 Raw Disk를 자동으로 검색하여 OSD로 사용합니다. 특정 디바이스만 사용하려면 spec.storage.nodes에서 노드별로 사용할 디바이스를 명시해야 합니다. spec.mon.count: 3으로 MON을 3개 배포하여 Quorum을 유지하고, Worker 노드가 3개 미만이면 allowMultiplePerNode: true를 설정해야 합니다.

kubectl create -f cluster.yaml

# 배포 진행 상태 모니터링
kubectl -n rook-ceph get pods -w

Pod 상태 확인

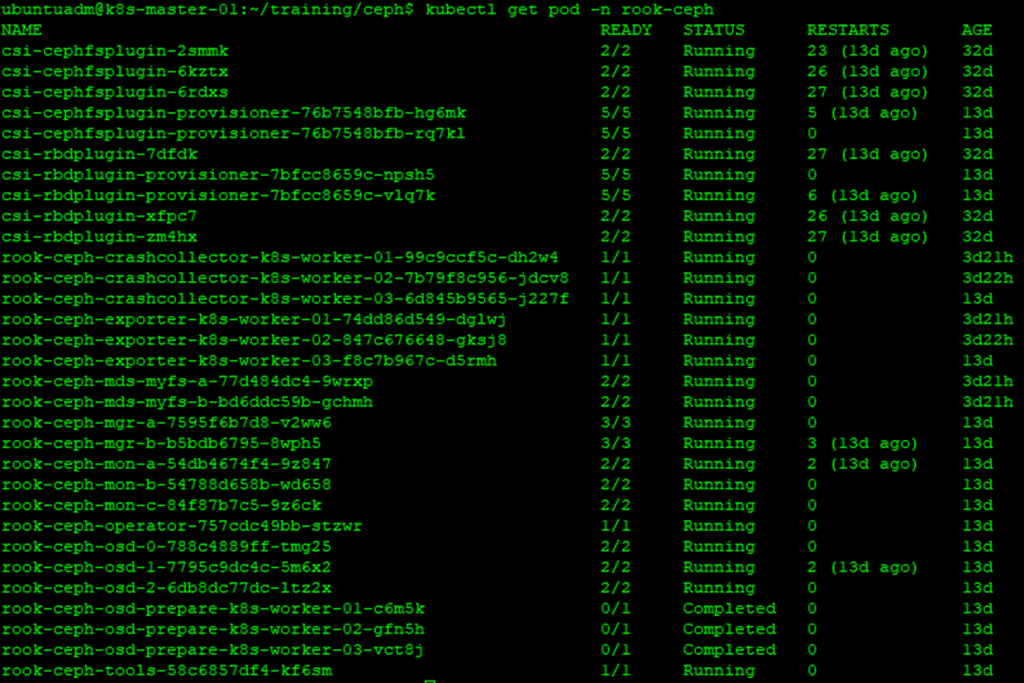
Ceph 구축이 완료되면 rook-ceph 네임스페이스에 OSD, MON, MGR Pod가 Running 상태로 기동됩니다. OSD Pod 수는 사용 가능한 Raw Disk 수와 일치하며, MON은 3개(또는 설정값), MGR은 1개(액티브) + 1개(스탠바이)가 기동됩니다.

Ceph 구축 완료 후 rook-ceph 네임스페이스 Pod 상태

Ceph 클러스터 상태 확인

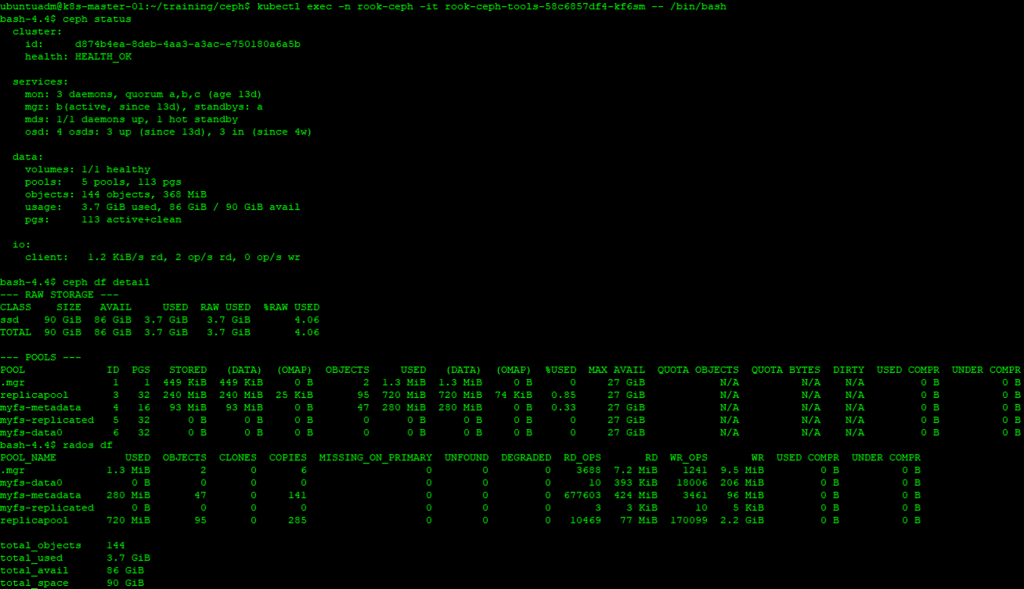
Rook Toolbox Pod를 배포하면 ceph status, ceph osd tree 등 Ceph 관리 명령어를 직접 실행할 수 있습니다. ceph status 출력에서 HEALTH_OK가 표시되면 Ceph 구축이 정상 완료된 것입니다.

HEALTH_WARN이 표시되는 경우 주요 원인으로는 OSD 개수가 PG(Placement Group) 비율에 맞지 않는 경우, CLOCK_SKEW(노드 간 시간 차이), 또는 OSD가 아직 초기화 중인 경우가 있습니다. ceph health detail 명령어로 구체적인 경고 내용을 확인하고 조치합니다.

Toolbox Pod에서 ceph status 확인 결과
# Toolbox 배포 (Rook 예제 디렉토리에서)
kubectl create -f toolbox.yaml

# Toolbox Pod에 접속
kubectl -n rook-ceph exec -it deploy/rook-ceph-tools -- bash

# Ceph 클러스터 상태 확인
ceph status
ceph osd tree

참고

관련 포스트:

참고 문서: Rook Quickstart 공식 문서 · Ceph 공식 소개 문서