Amazon Linux 2023 서버에 2026년 11월 2일 dnf upgrade를 적용한 뒤, Windows AD와 연동하던 Keycloak LDAPS 연결이 실패한 기록입니다. LDAP(389)로 바꾸면 연결이 정상이었고, 636 포트가 열려 있는 것도 확인한 상태였습니다.
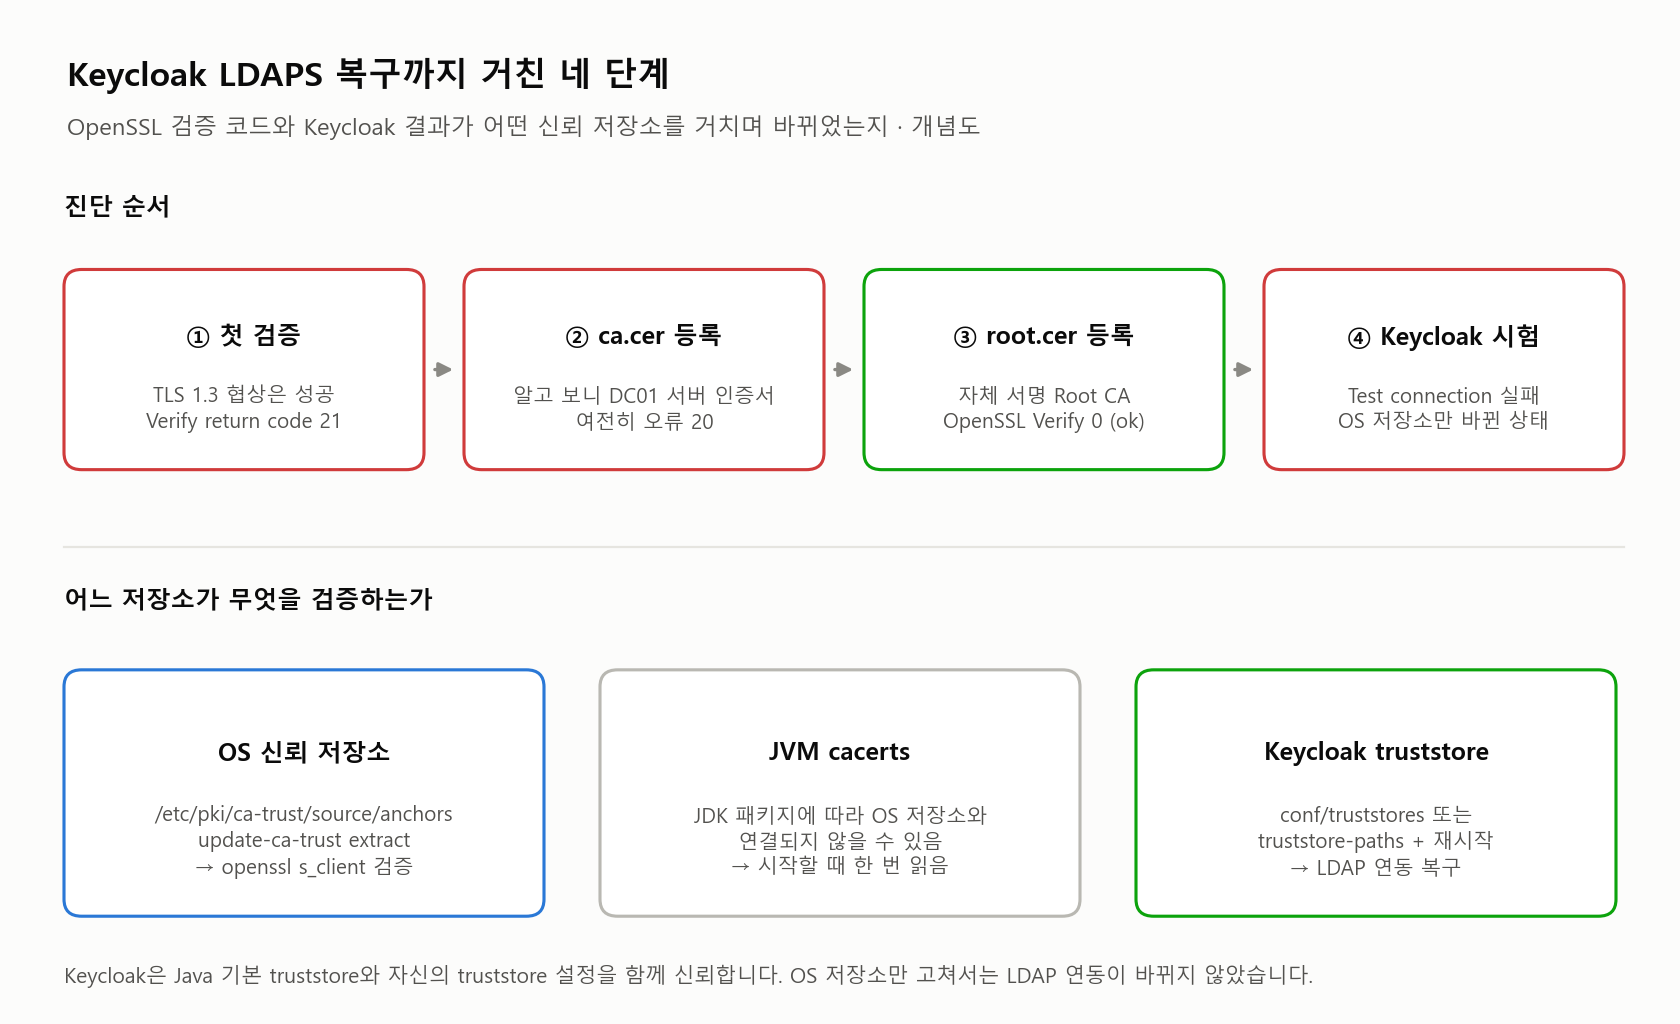
점검하면서 걸린 곳은 두 군데였습니다. OS 신뢰 저장소에 AD의 Root CA가 없었고, 처음 등록한 파일은 CA가 아니라 서버 인증서였습니다. OS에서 검증이 통과한 뒤에도 Keycloak은 자신의 truststore에 Root CA를 넣고 재시작한 뒤에야 연결됐습니다.
업그레이드가 정확히 무엇을 바꿨는지는 확인하지 못했습니다. 그 부분은 글 끝에 따로 적었습니다.
환경
구성 요소
내용
OS
Amazon Linux 2023 (2026-11-02 dnf upgrade 적용)
Keycloak
26.3.3, 서버에 직접 설치(컨테이너 아님)
LDAP 서버
Windows Active Directory, AD의 사설 CA(example-DC01-CA)가 발급한 서버 인증서
Keycloak LDAP 설정
ldaps://DC01.example.local:636, StartTLS Off, Use Truststore SPI Always
포트가 열려 있어도 LDAPS는 따로 확인해야 하는 이유
389는 평문 LDAP입니다. LDAPS(636)는 연결 직후 TLS 핸드셰이크와 인증서 검증을 한 번 더 거칩니다. TCP 연결과 389 동작은 그 앞 단계까지만 보증합니다.
Keycloak 설정을 건드리기 전에, Keycloak이 동작하는 서버에서 OpenSSL로 TLS 협상과 인증서 검증을 나눠 보았습니다.
# 출력 일부 발췌
verify error:num=20:unable to get local issuer certificate
verify error:num=21:unable to verify the first certificate
New, TLSv1.3, Cipher is TLS_AES_256_GCM_SHA384
Verify return code: 21 (unable to verify the first certificate)
TLS 1.3과 TLS_AES_256_GCM_SHA384 협상은 성공했으므로 프로토콜이나 cipher 호환성 문제는 아니었습니다. 서버 인증서는 CN=DC01.example.local이고 발급자는 사설 CA인 example-DC01-CA였습니다. 2026-09-24부터 2027-09-24까지인 유효기간도 문제가 없었습니다.
AD는 체인 없이 서버 인증서 한 장만 보내고 있었습니다. Keycloak 서버가 발급자 CA를 미리 알고 있지 않으면 검증을 끝낼 수 없는 구조입니다.
2. 이름은 ca.cer인데 서버 인증서였다
AD에서 내보낸 파일 두 개 중 example-dc01-ca.cer를 먼저 OS 신뢰 저장소에 넣었습니다. update-ca-trust extract를 실행한 뒤에도 오류 20(unable to get local issuer certificate)은 그대로였습니다. 두 파일의 subject와 issuer를 비교하자 이유가 드러났습니다.
example-dc01-ca.cer는 이름과 달리 DC01의 서버 인증서였습니다. 실제 CA는 subject와 issuer가 같은 자체 서명 인증서, 즉 example-dc01-root.cer 쪽이었습니다. 신뢰 저장소에는 서버 인증서가 아니라 그것을 발급한 CA를 넣어야 합니다.
CA 파일을 등록하기 전에 두 가지를 확인해 두면 같은 혼동을 피할 수 있습니다. Basic Constraints가 CA:TRUE인지 보고, 그 CA로 서버 인증서가 실제로 검증되는지 시험합니다.
# 출력 일부 발췌
Verified peername: DC01.example.local
Verify return code: 0 (ok)
OpenSSL 기준으로는 인증서 체인과 호스트명 검증이 모두 통과했습니다. 앞서 잘못 넣은 서버 인증서 파일은 anchors 디렉터리에서 빼 두는 편이 나중에 덜 헷갈립니다.
4. OS는 통과했는데 Keycloak은 여전히 실패
Keycloak 관리 콘솔의 User Federation(LDAP) 화면에서 Test connection과 Test authentication이 모두 실패했습니다. Keycloak은 Java로 동작하므로 OpenSSL과 같은 저장소를 보지 않습니다.
Keycloak 공식 문서에 따르면 Keycloak은 Java 기본 truststore의 인증서를 항상 신뢰합니다. 추가 인증서는 conf/truststores 디렉터리나 truststore-paths 옵션으로 넣습니다. JDK 패키지에 따라 Java 기본 truststore(cacerts)가 OS 신뢰 저장소와 별개의 파일일 수 있어서, OS 저장소를 고쳐도 JVM에 반영된다는 보장이 없습니다.
Keycloak이 쓰는 Java의 cacerts가 어디를 가리키는지는 아래처럼 확인할 수 있습니다. 서비스가 별도의 JAVA_HOME을 쓴다면 그 경로의 java로 바꿔서 봐야 합니다.
결과가 /etc/pki/ 아래를 가리키면 OS 저장소를 따르는 것이고, JDK 디렉터리 안의 파일이면 별도 저장소입니다. JVM은 시작할 때 truststore를 읽으므로 어느 쪽을 바꾸든 Keycloak을 재시작해야 반영됩니다.
Keycloak LDAPS 연결이 복구되기까지 거친 네 단계와, OS·JVM·Keycloak 신뢰 저장소가 각각 무엇을 검증하는지 정리한 그림입니다.
5. Keycloak truststore에 Root CA를 등록하고 재시작
Keycloak 26.3.3은 Quarkus 기반이라 추가로 신뢰할 인증서를 Keycloak 설정으로 관리합니다. 등록 방법은 두 가지이고, 이번에는 둘 다 적용했습니다. Root CA를 conf/truststores에 PEM으로 두고, keycloak.conf의 truststore-paths에도 같은 파일을 지정한 뒤 재시작했습니다. LDAPS 연결은 그 뒤에 복구됐습니다.
# 2) keycloak.conf에도 같은 파일을 지정
truststore-paths=/opt/keycloak/conf/truststores/example-dc01-root.pem
# 3) 두 설정을 반영하도록 재시작 (서비스 이름은 예시)
sudo systemctl restart keycloak
문서에 적힌 형식은 PEM과 PKCS12(.p12, .pfx, .pkcs12)입니다. 확장자가 .cer여도 내용이 PEM이면 그대로 쓸 수 있습니다. DER 형식이라면 openssl x509 -inform DER -in example-dc01-root.cer -out example-dc01-root.pem으로 바꿔 둡니다.
이미 truststore-paths를 쓰고 있다면 기존 값을 덮어쓰지 말고 경로를 추가해야 합니다. 서비스 이름과 설치 경로는 환경에 맞게 바꿔야 합니다.
두 방법을 함께 적용했기 때문에 어느 쪽이 결정적이었는지는 구분되지 않습니다. Keycloak 문서에 따르면 conf/truststores에 둔 인증서도 신뢰 대상이 됩니다. 그러니 같은 파일을 truststore-paths로 다시 지정한 것은 중복일 수 있습니다. 한쪽만 남겨도 연결이 유지되는지는 다음 점검 때 확인해 볼 만합니다.
업그레이드가 무엇을 바꿨는지는 확인하지 못했다
장애는 dnf upgrade 직후에 시작됐지만, 그 트랜잭션에 어떤 패키지가 들어 있었는지는 확인하지 않았습니다. 그래서 업그레이드가 문제를 만들었는지, 원래 있던 문제를 드러냈을 뿐인지 구분할 수 없습니다. 생각해 볼 수 있는 경로는 아래와 같고, 어느 쪽도 이번에 검증하지는 않았습니다.
예전에 keytool로 JDK의 cacerts에 직접 넣어 둔 CA가, JDK 패키지 업데이트로 파일이 교체되면서 사라졌을 수 있습니다.
Keycloak이 업그레이드 과정에서 재시작되면서, 그동안 메모리에 남아 있던 예전 truststore 대신 바뀐 파일을 새로 읽었을 수 있습니다.
AWS 보안 공지(CVE-2026-113470)에는 AL2023의 ca-certificates에서 eMudhra 루트를 제거하는 조치가 올라 있었습니다. 이번 문제는 사설 AD CA에 대한 신뢰였으므로 공개 CA 목록 변경과는 직접 관계가 없습니다. 다음에 같은 일이 생기면 업그레이드 트랜잭션부터 확인하려 합니다.
sudo dnf history
sudo dnf history info <ID>
rpm -qa | grep -Ei 'corretto|openjdk|ca-certificates|openssl'
정리
포트와 389는 LDAPS를 보증하지 않습니다. OpenSSL로 TLS 협상과 인증서 검증을 나눠 보면, 원인이 프로토콜인지 신뢰 체인인지 바로 갈립니다.
파일 이름보다 subject와 issuer를 봅니다. Root CA는 subject와 issuer가 같은 자체 서명 인증서입니다.
OS, JVM, Keycloak의 신뢰 저장소는 서로 다릅니다. Keycloak LDAPS 연결을 위해서는 Keycloak truststore에 Root CA를 두고 재시작해야 했습니다. Keycloak을 새 버전으로 옮길 때는 conf/truststores도 함께 옮겨야 합니다.
389로 돌아가거나 검증을 끄는 것은 해결이 아닙니다. StartTLS 없이 389를 쓰면 바인드 계정의 비밀번호가 평문으로 오갑니다.
2026년 10월 21일 PHP 프로젝트가 인증 없이 원격 코드 실행이 가능한 php2shell 취약점 두 건(CVE-2026-109618, CVE-2026-109619)을 고친 긴급 보안 릴리스를 냈습니다. Kubernetes에서 운영하는 WordPress가 영향을 받는지 확인해 보니, 파드 안의 PHP는 8.4.24였고 실행 방식은 Apache mod_php였습니다. 패치 대상인 데다, PHP가 위험도를 가장 높게 매긴 구성이었습니다.
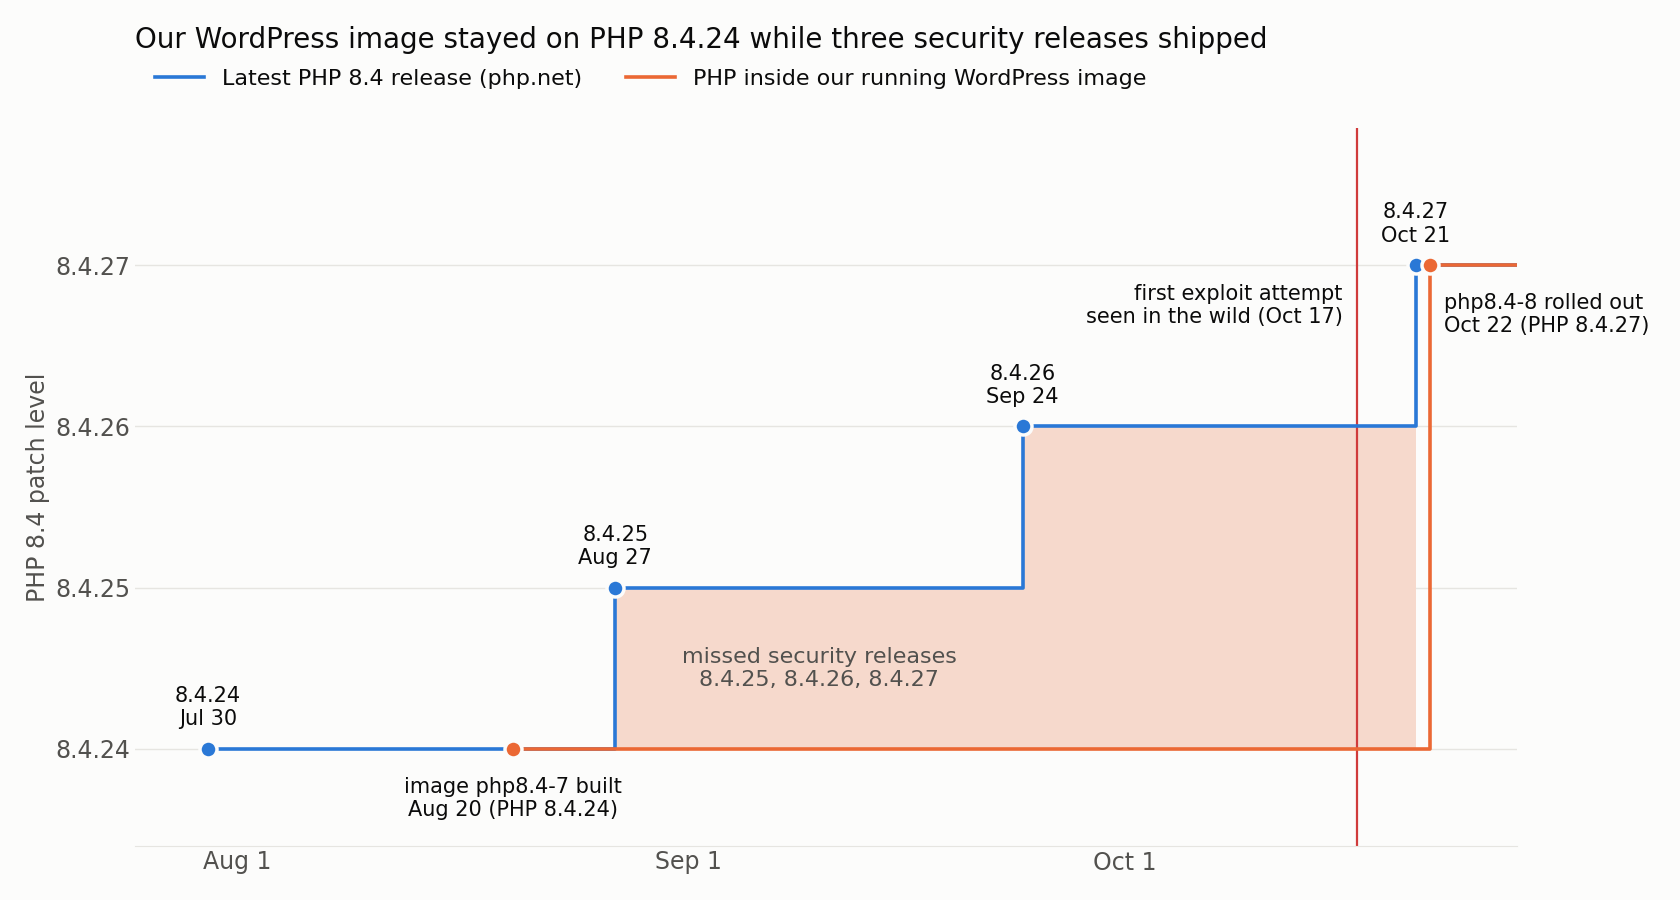
더 불편한 사실은 따로 있었습니다. 이 이미지는 8월 20일에 빌드된 뒤 그대로였고, 그사이 나온 8.4.25와 8.4.26 보안 릴리스도 들어 있지 않았습니다. 베이스 이미지는 상위에서 계속 갱신되고 있었지만 우리 이미지는 빌드한 순간의 PHP에 멈춰 있었습니다. 이 글은 취약 여부 판단, 침해 흔적 점검, 이미지 교체 전 이력 검토, 재빌드와 무중단 배포까지의 기록입니다.
환경
구성 요소
내용
Kubernetes
v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
WordPress
7.1.3, 파드 2개. 웹 루트 전체가 CephFS(RWX) 공유 볼륨
이미지 베이스
공식 wordpress:php8.4-apache (Debian 13)
웹 서버 / SAPI
Apache 2.4 + mod_php (mpm_prefork)
PHP
8.4.24 → 8.4.27
이미지 빌드
클러스터 안 Kaniko Job (v1.23.2), 사설 GitLab Container Registry
앞단
CloudFront → HAProxy → Traefik Ingress
워커 노드
allocatable 약 7.8 GiB, swap 없음
취약 여부를 판단한 근거
공지에서 확인한 두 가지 결함
PHP 보안 공지에 따르면 두 결함은 성격이 다릅니다. CVE-2026-109618은 메모리 부족(OOM) 처리 도중 반쯤 초기화된 요청 데이터를 정리 루틴이 유효한 값으로 다루는 문제입니다. CVE-2026-109619는 해제된 요청 상태가 남아 있다가 같은 워커가 처리하는 다음 요청에서 다시 쓰이는 문제입니다. 둘 다 CVSS v4.0 9.2이고, 수정 버전은 8.5.12, 8.4.27, 8.3.36, 8.2.35입니다.
판단에 결정적이었던 부분은 실행 방식별 위험도였습니다. 공지는 PHP-FPM, CGI, LiteSpeed 등 웹 요청을 처리하는 설치를 모두 영향 대상으로 보면서, mod_php를 가장 위험한 경우로 꼽았습니다. mod_php에서는 애플리케이션 코드가 실행되기 전에 요청 하나로 공격이 성립할 수 있어서, WordPress 코어와 플러그인을 최신으로 유지해도 막을 수 없습니다. 공개 나흘 전인 10월 17일부터 공격 시도가 관측됐다는 보고도 있었습니다.
실행 중인 파드에서 확인한 값
이미지 태그나 Dockerfile이 아니라 실제로 떠 있는 파드에서 확인했습니다. 태그 이름은 빌드 시점의 의도일 뿐이고, 공격을 받는 것은 지금 돌고 있는 바이너리이기 때문입니다.
공식 WordPress 이미지의 php8.4-apache 태그는 PHP 패치가 나올 때마다 상위에서 다시 빌드됩니다. 그래서 태그만 보면 늘 최신 PHP를 쓰는 것처럼 보입니다. 하지만 그 태그를 베이스로 우리가 빌드한 이미지는 빌드한 순간의 PHP를 담은 채 고정됩니다. 상위 태그가 몇 번 갱신되든, 다시 빌드하지 않으면 운영 파드에는 아무것도 들어오지 않습니다.
레지스트리에서 이미지 설정을 직접 읽어 보니 상황이 분명해졌습니다. 운영 중이던 php8.4-7은 8월 20일 빌드였고 환경 변수는 PHP_VERSION=8.4.24였습니다. 그 뒤 8월 27일 8.4.25, 9월 24일 8.4.26, 10월 21일 8.4.27이 나왔으니 보안 릴리스 세 번을 연달아 놓친 셈입니다. php2shell 취약점 공지가 아니었다면 이 차이는 계속 드러나지 않았을 것입니다.
운영 이미지의 PHP와 php.net 최신 8.4 패치의 차이. 음영 구간이 놓친 보안 릴리스이고, 빨간 선은 첫 공격 시도가 보고된 10월 17일입니다.
docker가 없는 환경에서도 이미지를 내려받지 않고 PHP 버전을 확인할 수 있습니다. 레지스트리 API로 매니페스트에서 이미지 설정(config) 블롭의 다이제스트를 찾고, 그 블롭 안의 환경 변수를 읽는 방식입니다. 상위 베이스가 패치를 담았는지와 우리가 푸시한 이미지에 무엇이 들어갔는지를 모두 이 방법으로 확인했습니다. 아래는 Docker Hub의 공식 이미지를 조회하는 예입니다.
공격 시도가 공개 전부터 관측됐으므로, 패치만 하고 끝내면 이미 들어온 것을 놓칠 수 있습니다. 첫 공격 시도가 보고된 10월 17일을 기준점으로 잡고 세 가지를 확인했습니다.
메모리 손상의 부산물이 로그에 남았는지
두 결함 모두 메모리 손상 계열이라, 공격이 실패하더라도 워커가 비정상 종료하거나 메모리 한도 초과 오류가 남을 가능성이 큽니다. 재기동 이전 컨테이너의 로그까지 포함해 10월 17일 이후 Apache와 PHP 로그를 검색했습니다.
for P in $(kubectl get pods -n wordpress -l app=wordpress -o name); do
  kubectl logs -n wordpress $P --previous 2>/dev/null
  kubectl logs -n wordpress $P
done | grep -iE "segmentation|exit signal|Allowed memory size|zend_mm|heap corruption"
결과는 0건이었습니다. 같은 기간의 PHP Fatal 오류는 wp-includes 아래 PHP 파일을 직접 호출하는 스캐너 요청에서만 나왔습니다. WordPress를 거치지 않고 내부 파일을 부르면 당연히 나는 오류이고, 메모리 계열과는 무관했습니다.
웹 루트에 새로 생긴 실행 파일이 있는지
웹 루트 전체가 공유 볼륨이라 한 파드에서 확인하면 두 파드에 같은 결과가 나옵니다. 처음에는 find -newermt로 최근 변경된 PHP 파일을 나열했는데, 플러그인 자동 업데이트로 바뀐 수천 개 파일에 묻혀 판단할 수 없었습니다. 디렉터리와 시간 단위로 묶어 세는 쪽이 훨씬 빨랐습니다.
플러그인 디렉터리의 묶음은 각 플러그인의 자동 업데이트 시각과 일치했고, WAF 디렉터리는 보안 플러그인이 규칙과 차단 기록을 저장하는 데이터 파일이었습니다. uploads의 16개는 같은 날 직접 올린 블로그 이미지와 그 썸네일로, file 명령으로 모두 PNG임을 확인했습니다. uploads 아래 PHP 확장자 파일은 플러그인이 디렉터리 목록 노출을 막으려고 만든 빈 index.php 두 개뿐이었습니다.
컨테이너 안에 남은 것이 있는지
마지막으로 볼륨 밖의 컨테이너 파일시스템과 /tmp, /dev/shm, 프로세스 목록을 확인했습니다. 10월 15일 이후 바뀐 파일은 컨테이너 기동 때 생기는 파일과 메일 스풀뿐이었고, 프로세스도 Apache와 Postfix 외에는 없었습니다.
이 점검은 로그와 파일 상태로 확인할 수 있는 범위에 한정됩니다. 컨테이너 로그는 재기동 이전 한 세대까지만 남아 있어 10월 17일 이전은 볼 수 없었고, 디스크에 흔적을 남기지 않는 침입까지 배제하지는 못합니다. 그래서 점검 결과와 관계없이 패치를 서둘렀습니다.
이미지를 바꾸기 전에 확인한 이력
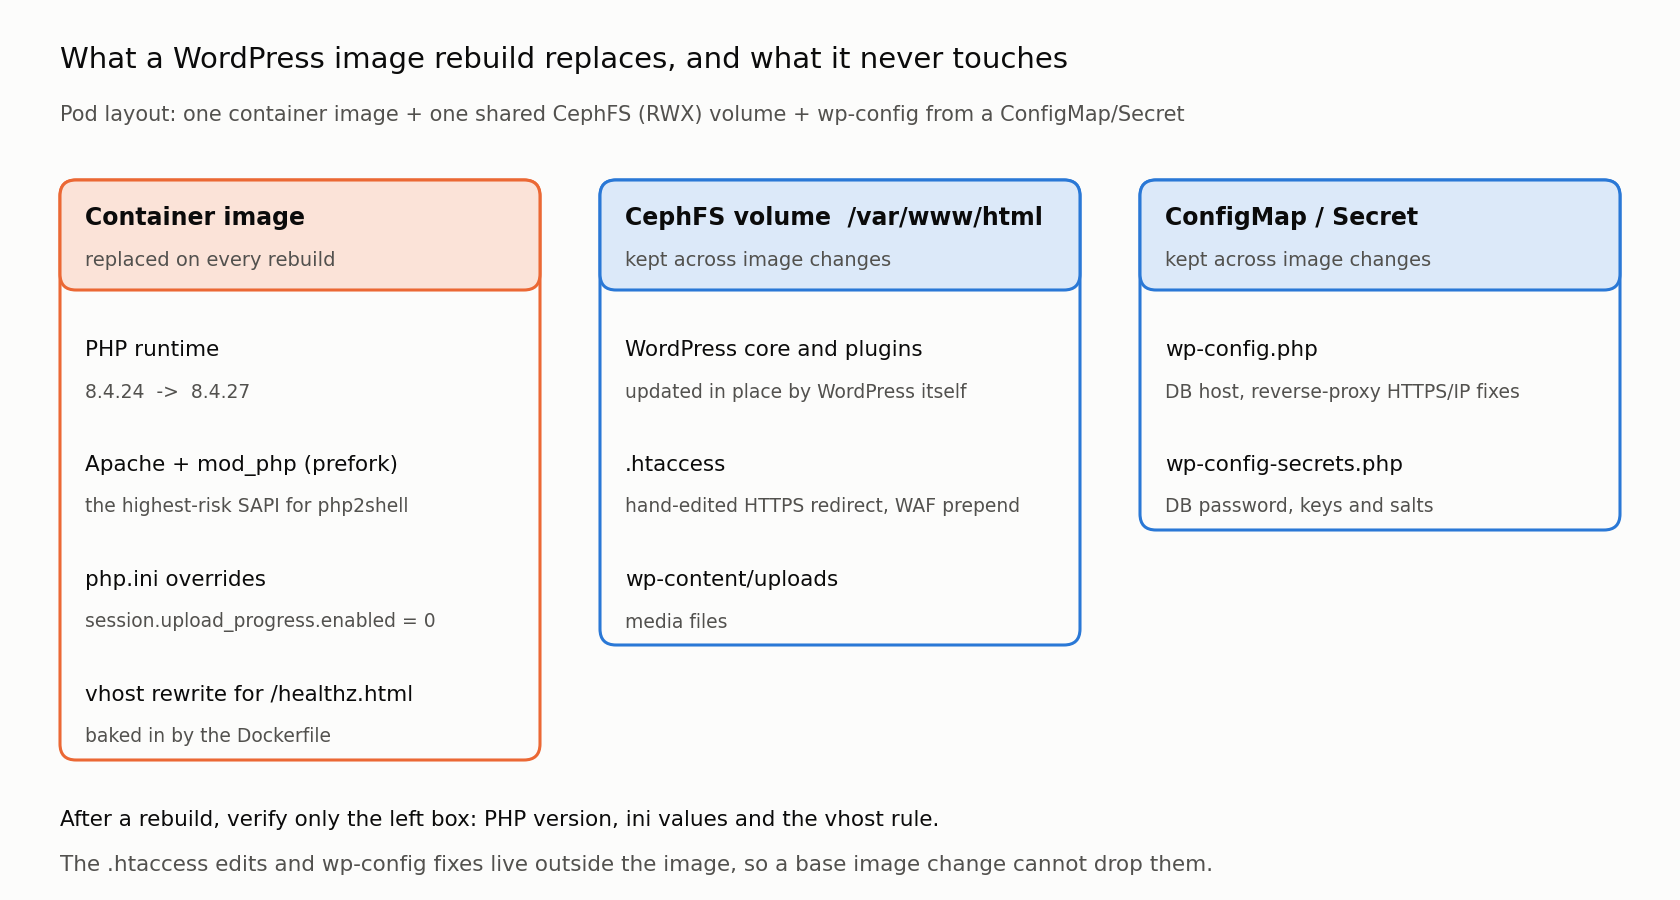
이 WordPress는 독립 서버에서 Kubernetes로 옮기면서 몇 군데를 손으로 고쳐 둔 상태입니다. 이미지를 교체할 때 그중 무엇이 사라질 수 있는지 먼저 따져 봤습니다. 기준은 단순합니다. 이미지 안에 있는 것은 재빌드로 바뀌고, 공유 볼륨과 ConfigMap에 있는 것은 그대로 남습니다.
WordPress 이미지 재빌드로 바뀌는 것(왼쪽)과 바뀌지 않는 것(가운데, 오른쪽).
이력 항목
위치
재빌드 영향
.htaccess의 HTTPS 리다이렉트 조건 수정 (X-Forwarded-Proto 기준)
공유 볼륨
없음
.htaccess의 보안 플러그인 WAF 연결 (<IfModule mod_php.c> 안의 auto_prepend_file)
공유 볼륨
없음. 같은 PHP 8 mod_php라 모듈 이름이 그대로 맞음
헬스체크 경로를 리다이렉트에서 빼는 vhost 규칙
이미지 (Dockerfile의 sed 주입)
있음. 새 베이스의 설정 파일 형식이 바뀌면 조용히 빠질 수 있어 배포 후 확인 필요
프록시 뒤 HTTPS 판별과 접속 IP 보정
ConfigMap (wp-config.php)
없음
php.ini 재정의 (memory_limit 256M 등)
이미지
같은 파일을 다시 넣으므로 유지
빌드 컨텍스트 ConfigMap
클러스터
저장소 파일과 비교해 다섯 파일 모두 일치
위험한 항목은 vhost 규칙 하나였습니다. Dockerfile이 기본 사이트 설정의 DocumentRoot 줄 뒤에 RewriteRule을 끼워 넣는 방식이라, 상위 이미지가 그 줄의 형식을 바꾸면 빌드는 성공하는데 규칙만 빠집니다. 다행히 readiness probe가 바로 이 경로를 보므로, 규칙이 빠지면 새 파드가 Ready가 되지 못하고 롤아웃이 멈춥니다.
확인 과정에서 빌드 Job 매니페스트가 저장소에 없다는 것도 드러났습니다. 이전 작업 때 한 번 만들어 쓰고 남기지 않은 탓에 이번에 다시 작성해야 했습니다. 이번 패치와 함께 저장소에 넣어, 다음 보안 릴리스 때는 태그만 올려 바로 쓸 수 있게 했습니다.
Kaniko로 다시 빌드하고 무중단으로 교체한 과정
1. 베이스 이미지를 버전 태그로 고정했습니다
기존 Dockerfile은 FROM wordpress:php8.4-apache였습니다. 버전이 드러나지 않는 태그라 어떤 베이스로 빌드했는지가 기록에 남지 않으므로, WordPress 버전까지 들어간 태그로 바꿨습니다. 푸시하는 쪽도 기존 관례였던 latest 동시 푸시를 없애고 버전 태그 하나만 남겼습니다.
# docker/wordpress/Dockerfile
FROM wordpress:7.1.3-php8.4-apache
바꾸기 전에 두 태그의 다이제스트를 비교했고, 둘 다 PHP 8.4.27을 담은 같은 amd64 매니페스트를 가리켰습니다. 다만 고정한다고 PHP 패치가 저절로 들어오는 것은 아닙니다. 이 태그 역시 PHP 패치 때마다 상위에서 다시 빌드되므로, 우리가 재빌드해야 반영된다는 점은 같습니다. 태그에 들어간 7.1.3도 런타임에는 영향이 없습니다. WordPress 코어는 공유 볼륨에 있고 WordPress가 스스로 업데이트하기 때문입니다.
2. 임시 완화 설정을 이미지에 함께 넣었습니다
공지는 두 가지 완화책을 제시합니다. CVE-2026-109619에는 session.upload_progress.enabled=0, CVE-2026-109618에는 memory_limit=-1과 낮은 post_max_size입니다. 업로드 진행률 기능은 WordPress가 쓰지 않으므로 끄는 데 부담이 없어, 패치와 별개로 계속 유지하기로 했습니다. 공지대로 ini_set()이나 .user.ini가 아니라 php.ini 단계에서 꺼야 효과가 있습니다.
memory_limit=-1은 적용하지 않았습니다. 이 클러스터의 워커는 swap 없이 allocatable 약 7.8 GiB로 운영되고, 노드 메모리 고갈로 kubelet이 멈춘 장애를 이미 두 번 겪었습니다. PHP의 메모리 상한을 없애면 요청 하나가 컨테이너 한도까지 메모리를 끌어갈 수 있으므로, 패치로 원인을 없애는 쪽을 택했습니다. post_max_size는 이미 공지 권고값인 8M이었습니다.
3. 메모리 여유가 가장 큰 노드에서 빌드했습니다
로컬에 docker가 없어 이미지는 클러스터 안의 Kaniko Job으로 빌드합니다. 빌드도 노드 메모리를 쓰므로 스케줄러의 requests 계산 대신 실제 여유를 먼저 봤습니다. Prometheus의 node_memory_MemAvailable_bytes 기준으로 워커 세 대의 여유는 2.43, 3.37, 4.70 GiB였고, 가장 넉넉한 노드에 Job을 고정했습니다.
initContainer를 따로 둔 이유는 ConfigMap 볼륨의 파일이 ..data/를 가리키는 심볼릭 링크이기 때문입니다. 이를 그대로 빌드 컨텍스트로 쓰면 Kaniko의 COPY가 깨진 링크를 이미지에 넣으므로, 실파일로 복사한 emptyDir을 넘깁니다. 빌드는 47초 만에 끝났고, 푸시된 이미지 설정에서 PHP_VERSION=8.4.27을 확인한 뒤 배포로 넘어갔습니다.
4. 이미지 태그 한 줄만 바꿔 롤링 업데이트했습니다
Deployment는 maxUnavailable: 0, maxSurge: 1이고 readiness probe가 헬스체크 경로를 봅니다. 앞서 말한 vhost 규칙이 빠졌다면 새 파드가 Ready가 되지 못하고 기존 파드가 계속 서비스하므로, 배포 방식 자체가 안전장치 역할을 합니다. kubectl diff로 변경이 이미지 태그 한 줄뿐인 것을 확인하고 적용했고, 두 파드 교체는 약 1분 만에 끝났습니다.
apply 출력에 Deployment뿐 아니라 wp-config가 든 ConfigMap과 PodDisruptionBudget도 configured로 찍혔습니다. 사전 diff에는 이미지 태그만 있었으므로, 의도하지 않은 변경이 들어갔는지 바로 확인했습니다.
원인은 last-applied-configuration 주석이었습니다. 해당 ConfigMap은 10월 초 DB 서버 이전 때 kubectl patch로 값을 바꿨는데, patch는 이 주석을 갱신하지 않습니다. 저장소 파일도 같은 값으로 고쳐 두었으므로 실제 데이터는 이미 일치했고, apply는 낡은 주석만 갱신했습니다. managedFields를 보면 이 사실이 그대로 드러납니다.
kubectl get cm wordpress-config -n wordpress -o json --show-managed-fields \
  | python3 -c 'import json,sys; [print(m["manager"], m["time"], json.dumps(m["fieldsV1"], separators=(",",":"))) for m in json.load(sys.stdin)["metadata"]["managedFields"]]'

kubectl-patch 2026-10-10T16:08:36Z {"f:data":{"f:wp-config.php":{}}}
kubectl-client-side-apply 2026-10-22T08:21:50Z {"f:data":{},"f:metadata":{"f:annotations":{".":{},"f:kubectl.kubernetes.io/last-applied-configuration":{}}}}
wp-config.php 필드의 소유자는 여전히 10월 10일의 kubectl-patch이고, 이번 apply가 가져간 것은 주석 필드뿐입니다. 저장소와 운영 중인 wp-config.php의 내용도 비교해 동일함을 확인했습니다. PDB 쪽은 spec이 8월 이후 그대로였고, 파드 교체에 따라 컨트롤러가 status를 갱신한 것이었습니다.
빌드 로그의 zip 경고
빌드 로그에 warning: zip (zip) is already loaded!가 찍혔습니다. 마이그레이션 때 원본 서버에 없던 zip 확장을 Dockerfile에서 직접 설치하도록 했는데, 공식 베이스 이미지에 zip이 이미 들어 있어서 나는 경고입니다. docker-php-ext-enable이 중복을 감지해 설정 파일을 하나만 남기므로 새 파드의 php -m에서도 경고가 없었고, 동작에는 영향이 없습니다. 다음 정리 때 Dockerfile에서 빼도 되는 단계입니다.
php2shell 취약점 조치 결과
항목
조치 전
조치 후
운영 파드의 PHP
8.4.24 (8월 20일 빌드 이미지)
8.4.27 (10월 22일 빌드 이미지)
session.upload_progress.enabled
1
0
베이스 이미지 태그
php8.4-apache
7.1.3-php8.4-apache
푸시 태그
php8.4-N + latest
php8.4-N만
빌드 Job 매니페스트
저장소에 없음
저장소에 보관
배포 후에는 두 파드 각각에서 PHP 버전, ini 값, vhost 규칙, Apache 모듈을 확인했습니다. 헬스체크, 메인 페이지, REST API, 로그인 페이지 모두 내부 경로와 외부 경로에서 200을 반환했고, 인증된 REST 조회로 플러그인이 모두 활성 상태인 것도 확인했습니다. 롤아웃 이후 PHP 오류 로그는 없었습니다.
검증하지 않은 것도 분명히 해 둡니다. 공개된 공격 코드를 이 사이트에 직접 실행해 보지는 않았고, 침해 흔적 점검은 10월 17일 이후 로그와 현재 파일 상태에 한정됩니다. 관리자 화면은 인증된 REST 조회까지만 확인했습니다.
이번 일에서 얻은 교훈은 php2shell 취약점 자체보다 운영 방식에 있었습니다. 컨테이너 이미지는 빌드한 순간의 런타임을 고정하므로, 베이스 태그가 아무리 부지런히 갱신돼도 재빌드하지 않으면 패치는 들어오지 않습니다. 이제 PHP 보안 공지가 나오면 레지스트리에서 베이스의 PHP_VERSION을 확인하고, 저장소에 둔 빌드 Job의 태그를 하나 올려 재빌드하는 것을 정해진 절차로 두었습니다.
노드 유지보수를 준비하다가 kubelet이 하루에 노드당 3만~8만 줄의 동일한 에러를 남기고 있는 것을 발견했습니다. 원인은 cri-dockerd 로그 로테이션 요청이 구조적으로 성공할 수 없는 구성에 있었습니다. kubelet은 컨테이너 로그가 임계값을 넘으면 로테이션을 요청하는데, cri-dockerd는 그 요청을 처리할 수 없어 10초마다 거부하고 kubelet은 10초마다 다시 요청했습니다.
이 글은 그 무한 재시도를 어떻게 측정하고 끊었는지, 그리고 같은 작업 창에서 함께 처리한 커널 롤링 재부팅 기록입니다. 재부팅 과정에서 문서에 “영구화 완료”로 적혀 있던 부팅 스크립트가 실은 한 번도 동작한 적이 없었다는 사실도 드러났는데, 그 쪽이 더 값진 수확이었습니다.
환경
구성 요소
내용
Kubernetes
v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
결과는 예상보다 컸습니다. 4대만 추려도 하루치 에러가 아래와 같았고, journald는 노드당 2.6~4.0 GB를 점유하고 있었습니다. 디스크가 50 GB인 노드에서 무시할 양이 아닙니다.
노드
24시간 에러 줄 수
컨테이너 로그
journald
<master-node-1>
34,548
110 M
2.6 G
<worker-node-1>
45,422
99 M
3.9 G
<worker-node-2>
79,940
245 M
4.0 G
<worker-node-3>
76,334
126 M
3.9 G
2. 에러 본문에서 원인이 그대로 드러났습니다
발생 빈도가 10초 간격이라는 점이 단서였습니다. 크기 기반 로테이션이라면 이렇게 잦을 수 없으므로 실제 메시지를 확인했습니다.
E1011 11:39:41 container_log_manager.go:266] "Failed to rotate log for container"
  err="failed to rotate log \"/var/log/pods/.../csi-snapshotter/0.log\":
       failed to reopen container log \"bcce9138ed39\":
       rpc error: code = Unknown desc = docker does not support reopening container log files"
  currentSize=65818371 maxSize=10485760
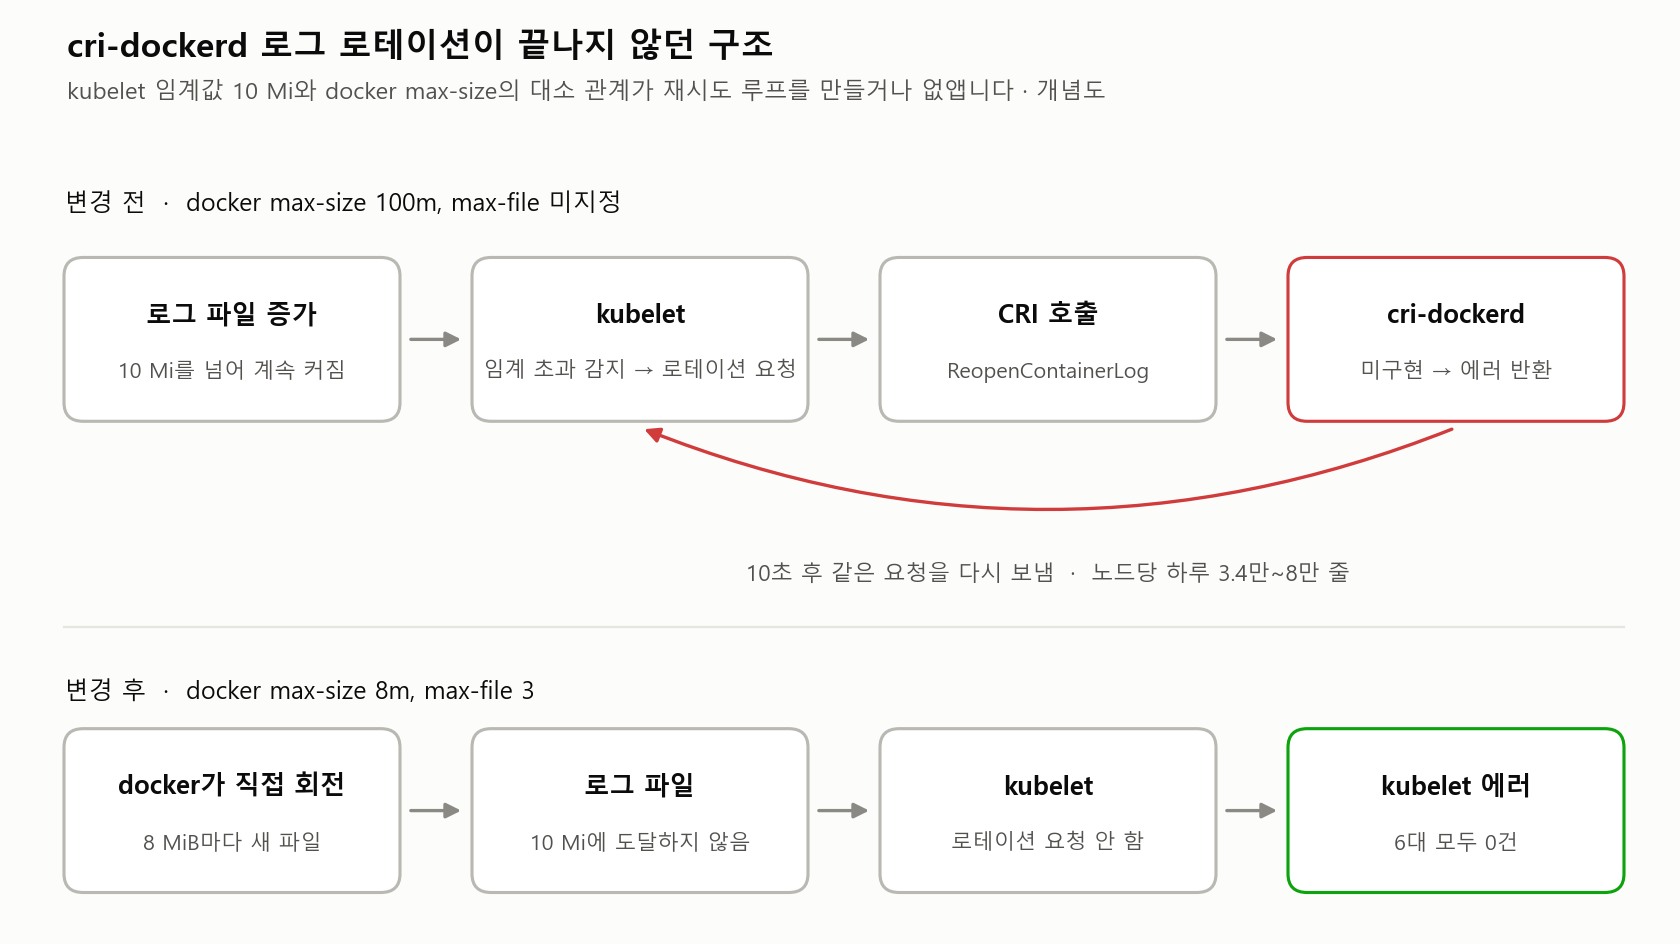
두 숫자가 전부를 설명합니다. maxSize=10485760은 kubelet의 containerLogMaxSize 기본값 10 Mi이고, currentSize는 62.8 MiB로 이미 그 임계를 한참 넘긴 상태입니다. kubelet은 임계를 넘은 파일을 발견하면 CRI의 ReopenContainerLog를 호출해 로테이션을 수행하는데, cri-dockerd는 이 RPC를 구현하지 않습니다.
즉 cri-dockerd 환경에서 kubelet이 보내는 로그 로테이션 요청은 영원히 성공할 수 없었고, kubelet은 그 요청을 10초마다 재시도하고 있었습니다. 파일이 임계 아래로 내려갈 일이 없으므로 이 루프는 컨테이너가 재생성될 때까지 멈추지 않습니다. 로그 용량 문제가 아니라 끝나지 않는 재시도가 본질이었습니다.
3. 로그 로테이션 주체를 docker로 넘겼습니다
기존 설정은 max-size가 100m이고 max-file이 없었습니다. json-file 드라이버에서 max-file을 생략하면 기본값이 1이므로 이력이 남지 않고, 100 MiB는 kubelet 임계값 10 Mi보다 훨씬 커서 위 루프를 항상 유발합니다.
해결 방향은 두 가지가 있었습니다. kubelet의 containerLogMaxSize를 키워 로테이션 시도 자체를 막는 방법과, docker의 상한을 kubelet 임계값보다 작게 두는 방법입니다. 후자를 택했습니다. 전자는 kubelet 설정을 바꿔야 하는데 그 값은 클러스터 전역 ConfigMap에서 내려오므로 변경 범위가 노드 밖으로 커집니다.
항목
변경 전
변경 후
max-size
100m
8m (kubelet 임계 10 Mi 미만)
max-file
미지정 (= 1, 이력 없음)
3
컨테이너당 상한
100 MiB
24 MiB
로그 파일이 8 MiB에서 회전하므로 10 Mi에 도달하는 일 자체가 없어지고, kubelet은 로테이션을 시도할 이유를 잃습니다. 실제 회전은 docker가 수행하며 직전 2세대가 남습니다. 결과적으로 cri-dockerd 로그 로테이션 경로는 더 이상 호출되지 않습니다.
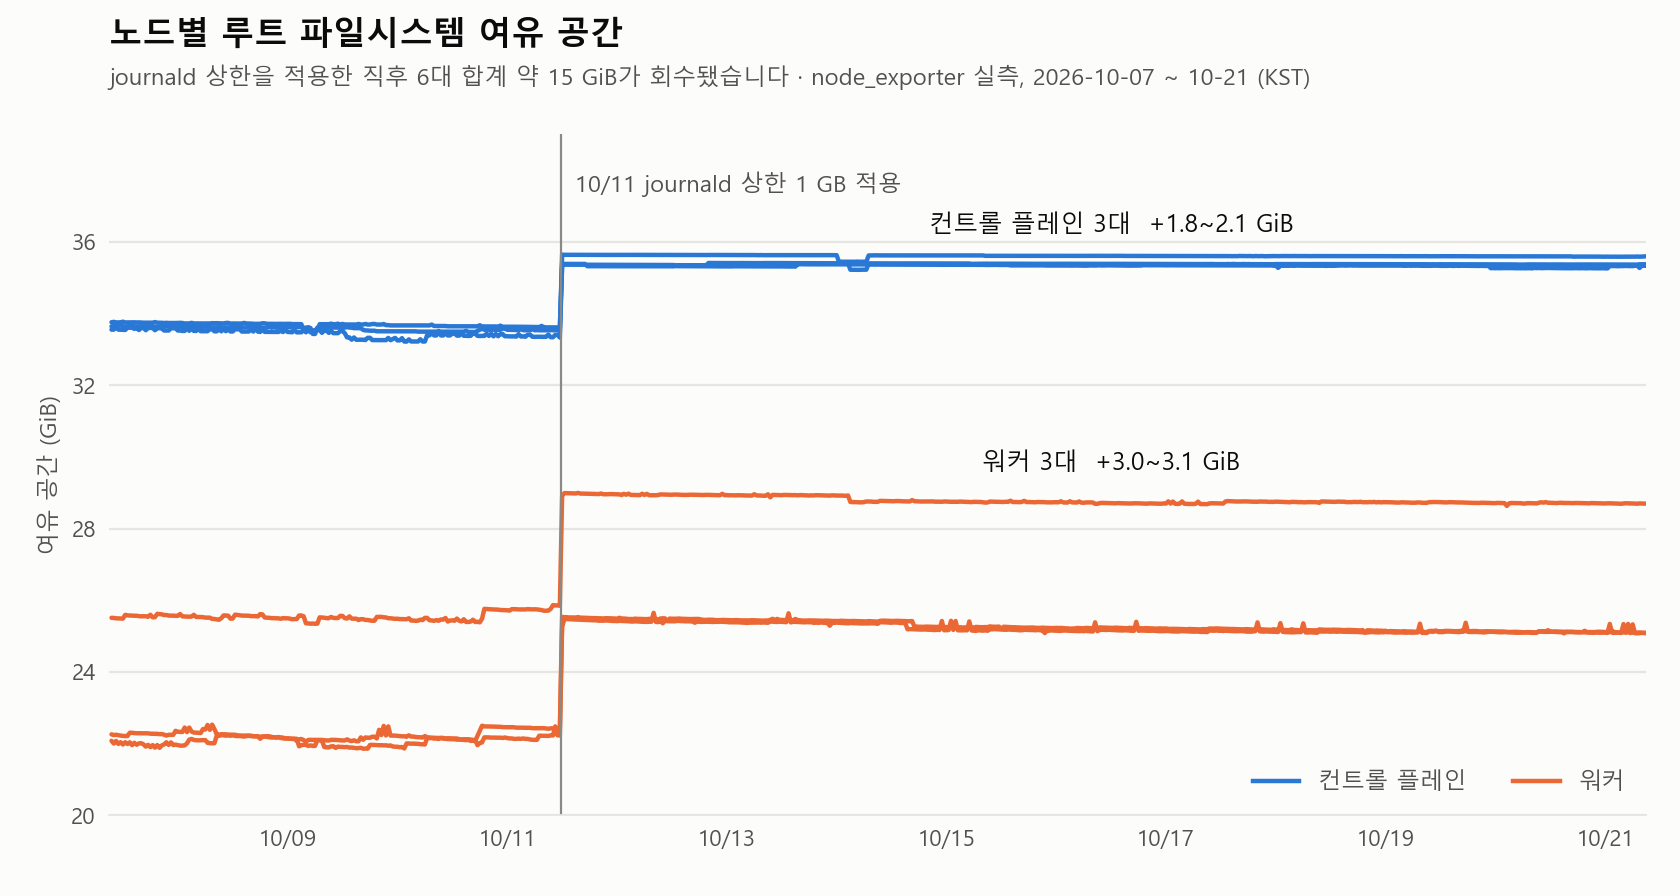
6대 합계로 약 15 GB를 회수했습니다. 노드당 여유 공간이 마스터는 34 → 36 GB, 워커는 23 → 26 GB로 늘었습니다.
journald 상한 적용 전후 노드별 루트 파일시스템 여유 공간. 10월 11일 정오 무렵 6대가 동시에 늘었고 합계는 약 15 GiB입니다(node_exporter 실측).
5. 롤링 재부팅으로 설정과 커널을 함께 반영했습니다
때마침 커널 드리프트가 쌓여 있었습니다. 6대 전부 6.8.0-146이 설치만 된 상태였고 1대만 그 커널로 가동 중이었습니다. 나머지 5대는 6.8.0-124로 돌고 있어, 다음 재부팅에서 커널이 바뀐다는 뜻입니다. 계획된 창에서 바꾸는 편이 장애 상황에서 마주치는 것보다 낫습니다.
마스터 3대 → 워커 3대 순으로 한 대씩 진행했습니다. 워커 구간은 OSD 하나가 내려가는 동안 Ceph가 리밸런싱을 시작하지 않도록 감쌌습니다.
kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph osd set noout   # 워커 구간 시작

kubectl drain <node> --ignore-daemonsets --delete-emptydir-data --timeout=600s
ssh <admin-user>@<node-ip> 'sudo systemctl reboot'

until kubectl get node <node> \
      -o jsonpath='{.status.conditions[?(@.type=="Ready")].status}' | grep -q True;
do sleep 10; done
kubectl uncordon <node>

kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph osd unset noout # 워커 구간 종료
노드마다 다음 게이트를 모두 통과한 뒤에만 다음 노드로 넘어갔습니다. 커널 버전, ceph 커널 모듈 적재, docker 로그 설정, kubelet·docker 활성 상태, 그리고 마스터는 etcd 쿼럼, 워커는 Ceph의 전체 PG가 active+clean으로 복귀했는지입니다.
노드
재부팅 전 커널
Ready 복귀
관찰
<master-node-1>
6.8.0-124
20초
rc.local 결함 발견
<master-node-2>
6.8.0-124
40초
rc.local 중복 기재 발견
<master-node-3>
6.8.0-124
40초
수정된 rc.local 실동작 확인
<worker-node-1>
6.8.0-146
20초
커널은 이미 최신, 설정 반영 목적
<worker-node-2>
6.8.0-124
30초
OSD PDB가 축출을 1회 지연
<worker-node-3>
6.8.0-124
80초
–
전체 약 40분이 걸렸고 서비스 중단은 없었습니다. Ingress 뒤의 웹 워크로드는 작업 내내 HTTP 200을 유지했습니다.
재부팅하면서 드러난 문제
부팅 스크립트가 매번 조용히 실패하고 있었습니다
현상 – 첫 마스터를 재부팅한 직후, ClusterIP를 HAProxy로 넘기는 DNAT 규칙이 0건이었습니다. 운영 문서에는 /etc/rc.local로 영구화했다고 적혀 있었고 파일도 실행 권한을 갖고 있었습니다.
systemctl status rc-local.service

  rc-local.service: Failed to execute /etc/rc.local: Exec format error
  Process: 822 ExecStart=/etc/rc.local start (code=exited, status=203/EXEC)
원인 – 파일에 shebang이 없었습니다. 실행 권한만으로는 systemd가 인터프리터를 결정할 수 없어 203/EXEC로 떨어집니다. 그 결과 “재부팅 영구화”라고 기록된 장치가 실은 한 번도 동작한 적이 없었습니다. 마스터를 재부팅한 적이 없어서 드러나지 않았을 뿐입니다.
해결 – shebang을 추가하고, 규칙을 넣기 전에 -C로 존재를 확인하도록 다시 썼습니다. 재실행해도 중복이 쌓이지 않습니다.
한 가지 덧붙이면 이 결함의 기능적 영향은 없었습니다. 규칙이 0건인 상태에서도 https://10.96.0.1:443/healthz가 HTTP 200을 반환했습니다. 정상 가동 중에는 kube-proxy가 ClusterIP를 처리하므로, 이 DNAT는 kube-proxy가 아직 준비되지 않은 control plane 조인 시점에만 필요합니다. 그래서 결함이 오래 숨어 있을 수 있었습니다.
같은 파일에 규칙이 중복 기재되어 있었습니다
현상 – 수정 후 서비스를 재시작했더니 한 노드는 규칙이 2건인데 다른 두 노드는 6건이 됐습니다.
원인 – 두 노드의 rc.local 안에 iptables 두 줄이 각각 두 번 적혀 있었습니다. 실행마다 4건이 삽입되던 셈입니다. 동일한 DNAT 규칙이 중복되면 첫 매칭만 평가되므로 기능상 무해하지만, 규칙 수로 상태를 판단할 수 없게 됩니다.
해결 – 중복 줄을 제거해 3대의 파일을 통일하고, 라이브 테이블에서도 체인별 1건만 남도록 정리했습니다. 위의 -C 검사가 재발을 막습니다.
CephFS 커널 모듈이 부팅 시 적재되지 않았습니다
현상 – 앞서 한 워커가 커널 교체와 함께 재부팅된 뒤, RWX 볼륨을 쓰는 워크로드가 마운트에 실패했습니다.
MountVolume.MountDevice failed ... an error (exit status 1) occurred
while running modprobe args: [ceph]
원인 – 모듈 파일은 새 커널 트리에 정상적으로 존재했고 수동 modprobe ceph도 성공했습니다. 모듈 부재가 아니라 부팅 시 자동 적재가 되지 않은 것이었습니다.
해결 – /etc/modules-load.d/ceph.conf로 영구화하고 6대 전부에 배포했습니다. 설정 파일이 존재한다는 사실만으로는 검증이 안 되므로, 모듈을 내린 뒤 적재 서비스를 재시작해 부팅을 재현했습니다.
sudo modprobe -r ceph                       # 사용 중이면 실패하는데 그건 정상
sudo systemctl restart systemd-modules-load
lsmod | grep '^ceph '                       # 적재돼 있어야 한다
이후 6대 재부팅 전부에서 자동 적재를 확인했습니다. 블록 스토리지(RBD)는 이 문제와 무관하며 CephFS를 쓰는 워크로드만 영향을 받습니다.
로그 로테이션 설정 적용 후에도 큰 파일이 남아 있었습니다
현상 – 재부팅을 마치고 확인했더니 8 MiB를 넘는 로그 파일이 노드당 1~3건 남아 있었습니다. 설정이 먹지 않은 것처럼 보였습니다.
원인 – 해당 파일들의 소유 컨테이너를 역추적하니 모두 exited 상태였고, 마지막 수정 시각이 재부팅 시점이었습니다. 구 100m 설정으로 돌던 컨테이너들의 잔존 로그였습니다. 더 커지지 않으며 docker가 해당 컨테이너를 정리할 때 함께 사라집니다.
확인 – 신규 컨테이너에 설정이 실제로 적용됐는지는 파일 크기가 아니라 컨테이너의 로그 설정을 직접 조회해 판단해야 합니다.
현상 – 6대를 모두 순회한 뒤 메모리 사용률이 한쪽으로 쏠렸습니다. 한 워커는 68 %인데 다른 워커는 25 %였습니다.
원인 – drain으로 옮겨진 파드는 노드가 복귀해도 자동으로 되돌아오지 않습니다. 순차 재부팅에서는 뒤에 처리한 노드의 파드가 앞서 복귀한 노드로 모이기 쉽습니다.
대응 – 기능 문제는 아니지만 노드 메모리 여유가 빠듯한 환경에서는 지켜볼 값입니다. 작업 직후 kubectl top nodes로 분포를 확인하고, 필요하면 해당 디플로이먼트를 재시작해 재배치를 유도하는 편이 안전합니다. 스케줄러가 선언된 requests를 기준으로 판단하므로, 실사용이 requests보다 큰 워크로드에서는 스케줄러의 여유 표시를 그대로 믿기 어렵습니다.
로그 로테이션 조치 결과
cri-dockerd 로그 로테이션 요청의 무한 재시도는 완전히 멈췄습니다. 재부팅 이후 수집 구간에서 6대 모두 해당 에러가 0건입니다.
journalctl -b -u kubelet --no-pager | grep -c "ReopenContainerLog"
# 6대 전부 0
항목
작업 전
작업 후
kubelet 로테이션 에러
노드당 하루 3.4만~8만 줄
0건
journald 점유
노드당 2.6~4.0 GB (상한 미설정)
노드당 약 950 MB (상한 1 GB)
컨테이너 로그 상한
100 MiB × 1세대
8 MiB × 3세대
커널
6대 중 5대가 6.8.0-124
6대 전부 6.8.0-146
디스크 여유
마스터 34 GB / 워커 23 GB
마스터 36 GB / 워커 26 GB
클러스터 상태도 함께 확인했습니다. 6대 전부 Ready이고 스케줄 가능 상태이며, etcd 3개 엔드포인트가 모두 정상, Ceph는 HEALTH_OK에 mon 3/3, OSD 3/3, 전체 PG active+clean입니다.
kubectl get nodes -o custom-columns=\
'NODE:.metadata.name,STATUS:.status.conditions[-1].status,KERNEL:.status.nodeInfo.kernelVersion'

kubectl get pods -A | grep -v Running | grep -v Completed
kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph -s
정리하면 이번 작업의 핵심은 두 가지입니다. 하나는 런타임이 지원하지 않는 기능을 요청하는 구성은 조용히 자원을 태운다는 점입니다. cri-dockerd 로그 로테이션 문제는 로테이션 주체를 docker로 옮겨 해결했습니다. 다른 하나는 부팅 시 동작하는 설정은 실제로 재부팅해 보기 전까지 검증된 것이 아니라는 점입니다. 이번에 드러난 rc.local 결함과 커널 모듈 자동 적재 문제 모두 재부팅 없이는 알 수 없었습니다.
확인하지 않은 범위도 남겨둡니다. kubelet의 containerLogMaxSize를 직접 조정하는 방식은 시도하지 않았고, max-size를 10 Mi 이상으로 되돌리면 같은 에러가 재발하는지도 실측하지 않았습니다. 동작 원리상 재발이 예상되지만 측정한 결과는 아닙니다.
같은 클러스터에서 3주 간격으로 두 번, 워커 노드 하나가 응답을 멈추고 그 여파로 데이터베이스가 중단됐습니다. 두 번째 사고를 파고들어 찾은 원인은 Ceph OSD 캐시 메모리 문제였습니다. OSD가 osd_memory_target 설정에 따라 노드당 3 GiB를 쓰는데도 리소스 선언은 전혀 없었고, 그 결과 노드 메모리가 수 시간에 걸쳐 말라가다 kubelet이 멈췄습니다.
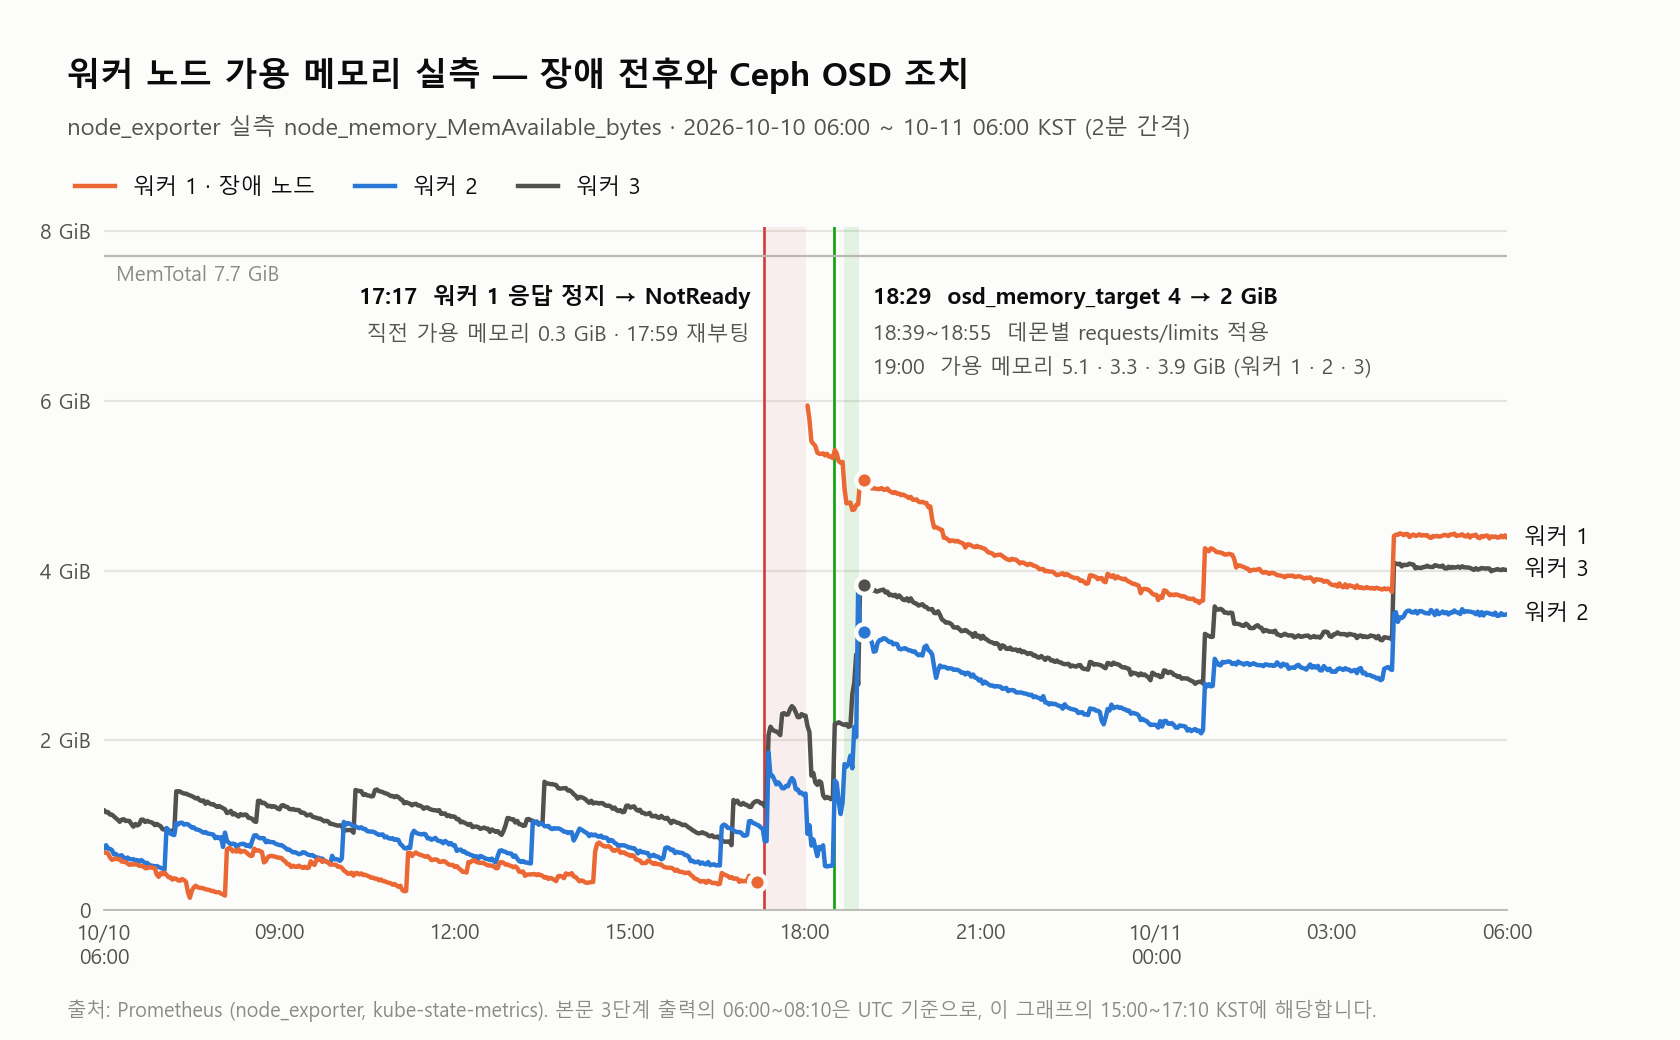
이 글은 그 연쇄를 추적한 과정과, osd_memory_target 조정 및 데몬별 requests/limits 선언으로 가용 메모리를 0.3 GiB에서 5.1 GiB까지 회복시킨 기록입니다. 중간에 Rook의 리소스 설정이 CR에 따라 무시되는 함정도 하나 만났습니다.
kubelet: "Failed to rotate log for container" err="... docker does not support reopening container log files"
         currentSize=41897845 maxSize=10485760     # calico-node 41 MB
         currentSize=61953310 maxSize=10485760     # mgr watch-active 62 MB
kubelet: "Housekeeping took longer than expected" expected="1s" actual="1.302s"
kubelet: (마지막 로그)

kernel:  libceph: osd0 down
kernel:  rbd: rbd0: encountered watch error: -107      # ENOTCONN
systemd-journald: Under memory pressure, flushing caches.
(이후 저널 완전 정지)
journald: Under memory pressure가 핵심 단서였습니다. 디스크는 55%로 여유가 있었으니 용량 문제가 아니었습니다.
3. 메모리 추이 확인
Prometheus에서 노드별 가용 메모리를 조회하니 장애 노드만 다른 양상이었습니다.
node_memory_MemAvailable_bytes  (총 7.7 GiB, swap 없음)

장애 노드   06:00=0.6  07:00=0.4  07:20=0.3  08:00=0.3  08:10=0.3 GiB   ← 수 시간째 4% 수준
다른 노드   0.5~1.5 GiB / 0.8~2.1 GiB
주목할 점은 OOM killer가 돌지 않았다는 것입니다. 특정 컨테이너가 한도를 넘은 게 아니라 시스템 전역 메모리가 말라 커널 reclaim이 thrash되면서 kubelet이 응답 불능에 빠진 것이었습니다. swap이 없어 완충이 전혀 없었습니다.
4. 범인 — 리소스 선언이 없는 OSD
파드별 메모리를 보니 OSD가 압도적이었습니다.
kubectl top pods -A --sort-by=memory | head -5

rook-ceph-osd-1    3088Mi
rook-ceph-osd-2    2972Mi
rook-ceph-osd-0    1232Mi    # 직전에 재시작되어 아직 안 자람
mariadb-galera-0   1494Mi
prometheus         806Mi
설정을 확인하니 세 가지가 동시에 문제였습니다.
ceph config get osd osd_memory_target            # 4294967296  (4 GiB, 기본값)
ceph config get osd osd_memory_target_autotune   # false       (노드 크기에 맞춰 조정 안 함)

kubectl get pods -n rook-ceph -l app=rook-ceph-osd \
  -o jsonpath='{.items[0].spec.containers[0].resources}'
# {}   ← requests / limits 둘 다 없음
allocatable이 7.8 GiB인 노드에서 OSD 하나가 4 GiB를 목표로 상한 없이 자랍니다. 여기에 DB와 모니터링 스택이 더해지면 수지가 맞지 않습니다.
더 나쁜 건 스케줄러가 이를 몰랐다는 점입니다. requests가 14~30%만 선언돼 있는데 실사용은 63~89%였습니다. 스케줄러 입장에선 노드가 비어 보여 계속 파드를 배치합니다.
5. 1단계 — osd_memory_target 축소 (무중단)
OSD가 스스로 bluestore 캐시를 줄이도록 하는 런타임 설정이라 재시작이 필요 없습니다.
원인 — Rook에서 MDS 데몬 배포는 CephFilesystem CR이 소유합니다. CephCluster의 resources가 지원하는 키는 mgr·mon·osd·prepareosd·crashcollector·exporter 등이고 mds는 포함되지 않아 조용히 무시됩니다.
전환 중 standby MDS가 교체되며 20초가량 HEALTH_WARN이 떴다가 복귀했고, CephFS를 쓰는 워크로드는 영향을 받지 않았습니다.
LimitRange 를 전역 기본값으로 착각
현상 — 리소스 선언이 없는 컨테이너가 95개나 돼서 LimitRange로 기본값을 주려 했는데, 한 네임스페이스에 선언하면 전체에 적용될 것으로 기대했습니다.
원인 — LimitRange는 네임스페이스 스코프이고 쿠버네티스에 전역 기본 LimitRange라는 개념 자체가 없습니다. server dry-run으로 확인했습니다.
LimitRange 있는 네임스페이스  → {"limits":{"memory":"256Mi"},"requests":{"cpu":"10m","memory":"64Mi"}}
LimitRange 없는 네임스페이스  → {}     (아무것도 주입되지 않음)
해결 — 대상 네임스페이스마다 오브젝트를 하나씩 둡니다. 같은 검증에서 함정을 하나 더 찾았습니다. limit만 선언하고 request를 빠뜨리면 request가 defaultRequest가 아니라 limit과 같은 값이 됩니다. requests가 부풀어 스케줄링이 막힐 수 있으니 항상 함께 선언해야 합니다.
워커 노드 한 대가 약 9초 동안 네트워크에서 사라졌습니다. 그 쿠버네티스 노드 순단 하나가 스토리지 컨트롤 파드의 즉시 축출로 번졌고, 결국 상위 워크로드까지 영향을 받았습니다. 정작 처음 눈에 띈 증상은 Ceph 파드가 무더기로 재기동된 것이어서, 저장소 쪽 문제로 오인하기 쉬운 상황이었습니다.
이 글은 그 9초를 어떻게 특정했는지, 그리고 같은 일이 반복되어도 피해가 번지지 않도록 적용한 두 가지 조치를 정리한 운영 기록입니다. 관측 도구 자체가 장애 노드 위에 있을 때 생기는 판단 착오와, 그것을 걷어내기 위해 클러스터 바깥의 관측자를 동원한 과정이 핵심입니다.
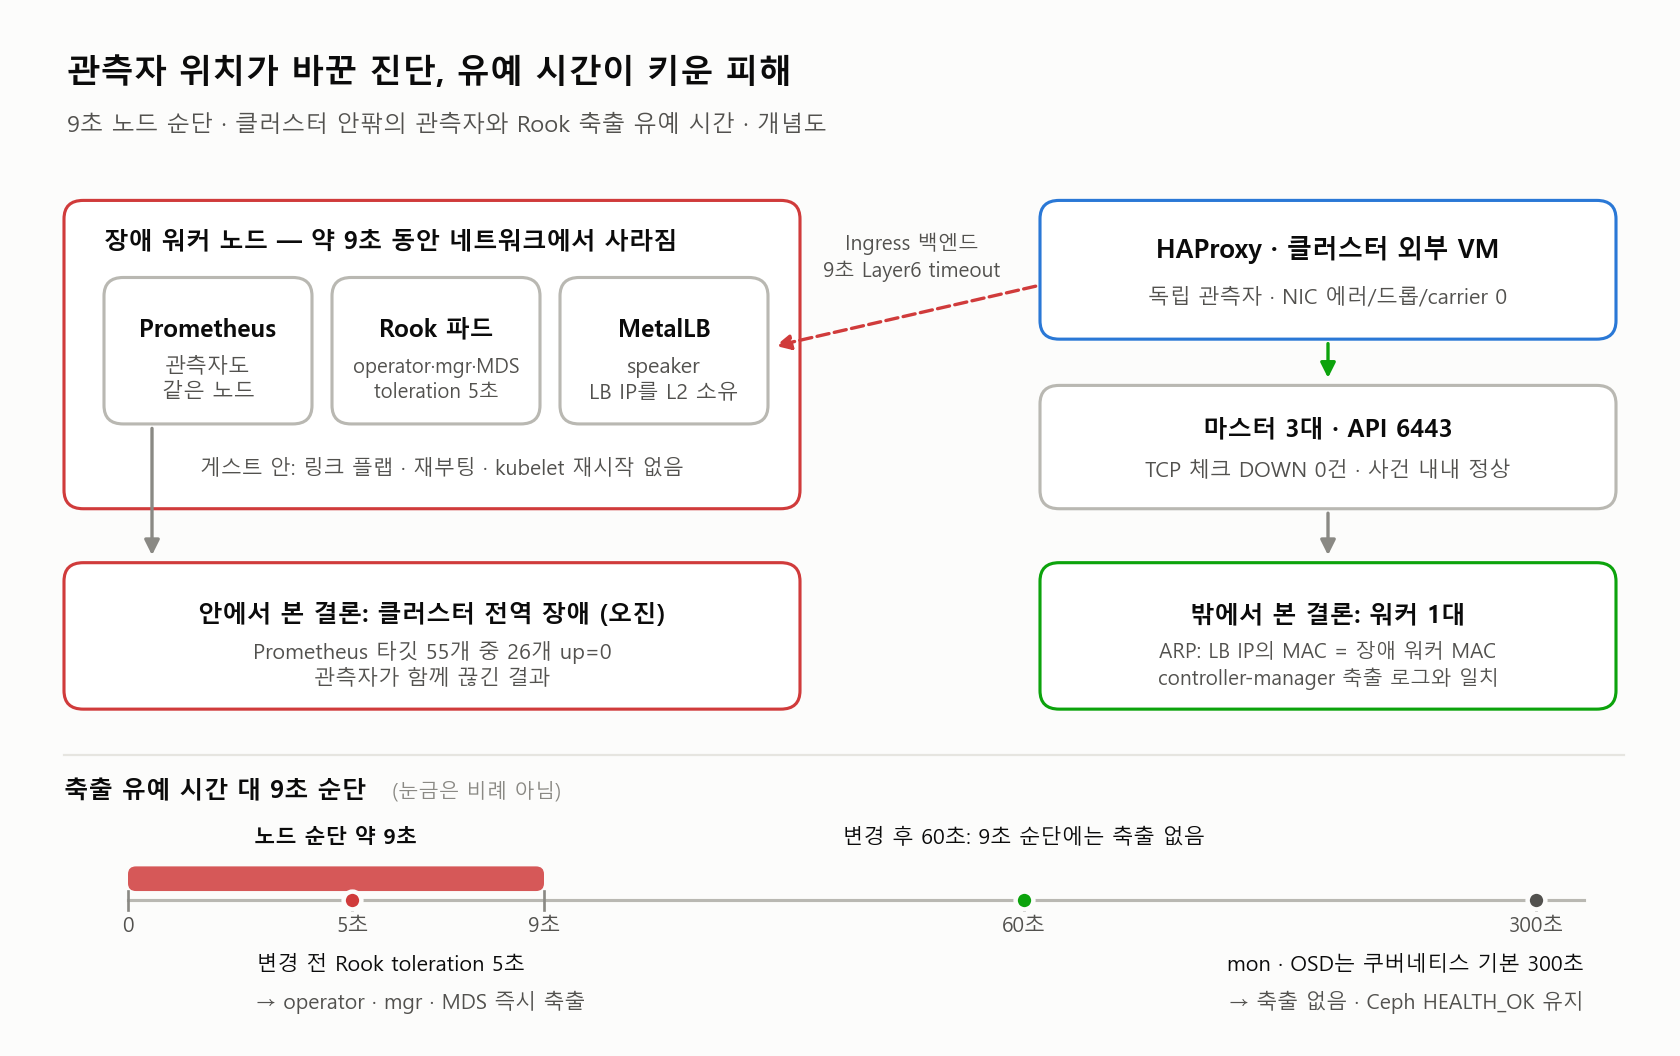
쿠버네티스 노드 순단 9초를 클러스터 안팎의 관측자가 다르게 본 구조와 축출 유예 시간의 차이입니다.
환경
구성 요소
내용
Kubernetes
v1.36.3 (kubeadm HA, control plane 3대 + worker 3대)
그런데 이 판단에는 결함이 있었습니다. Prometheus 파드 자체가 문제가 의심되는 워커 노드 위에서 동작하고 있었기 때문입니다. 관측자가 장애 대상 안에 있으면 “모든 타깃이 죽었다”는 결과는 타깃의 상태가 아니라 관측자의 상태를 반영합니다. 게다가 query_range는 직전 값을 최대 5분까지 끌어와 채우므로, 스크레이프가 아예 누락된 구간이 정상값 1로 보이기도 합니다.
2. 클러스터 바깥의 독립 관측자 확보
편향을 걷어내기 위해 클러스터 외부에 있는 HAProxy의 로그를 확인했습니다. HAProxy는 API 서버 3대를 TCP 체크로 상시 감시하고 있으므로, 물리망이나 마스터에 문제가 있었다면 반드시 흔적이 남습니다.
# API 백엔드는 하루 종일 DOWN 이력이 없었음
journalctl -t haproxy --since "YYYY-MM-DD 00:00:00" | grep -iE "DOWN|UP|no server"

Server www.example.com/app1 is DOWN, reason: Layer6 timeout, check duration: 2001ms.
backend 'www.example.com' has no server available!
Server www.example.com/app1 is UP, reason: Layer6 check passed, check duration: 1ms.
결과는 명확했습니다. 6443 백엔드는 DOWN 기록이 한 건도 없었고 NIC 에러·드롭·carrier 카운터도 모두 0이었습니다. 즉 물리망과 마스터 3대는 사건 내내 정상이었습니다. 유일한 이벤트는 Ingress 컨트롤러 백엔드가 9초 동안 Layer6 타임아웃을 낸 것뿐이었습니다.
3. ARP 테이블로 MetalLB L2 소유자 특정
그 백엔드 주소는 MetalLB가 L2로 광고하는 LoadBalancer IP입니다. L2 모드에서는 speaker 하나가 해당 IP를 소유하므로, 그 speaker가 있는 노드가 사라지면 IP도 함께 사라집니다. HAProxy의 ARP 테이블에서 소유자를 바로 확인할 수 있었습니다.
ip neigh show | grep -E "192.168.x."

192.168.x.112 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # worker-node
192.168.x.120 dev ens33 lladdr 00:0c:29:xx:xx:xx REACHABLE   # LoadBalancer IP - 동일 MAC
LoadBalancer IP의 MAC이 특정 워커 노드의 MAC과 동일했습니다. 여기에 kube-controller-manager 로그가 같은 시각 그 노드의 파드를 축출한 기록이 더해지면서, 서로 독립된 두 관측자가 같은 노드를 지목하게 되었습니다.
노드가 네트워크에서 사라졌다면 게스트 안에도 흔적이 남아야 합니다. 그런데 어느 지표에도 흔적이 없었습니다.
확인 항목
결과
node_network_carrier_changes_total
전 노드 불변 — 링크 플랩 없음
node_network_up
1 유지
node_boot_time_seconds
불변 — 노드 재부팅 없음
kubelet process_start_time_seconds
불변 — kubelet 재시작 없음
calico-node / kube-proxy / CoreDNS
재시작 0회
HAProxy NIC 카운터
error / dropped / carrier 모두 0
링크는 끊기지 않았는데 네트워크에서는 사라졌고, 물리망과 다른 VM은 멀쩡했습니다. 이 조합은 게스트 계층이 아니라 그 바깥, 즉 하이퍼바이저 계층의 순간적인 정지를 시사합니다. 다만 해당 계층의 이벤트 로그에 접근하지 못해 근본 원인 확정까지는 이르지 못했다는 점을 분명히 해 둡니다. 스냅샷이나 백업 스케줄은 없다는 것이 확인되어, 정기 작업 가설은 배제되었습니다.
5. 조치 1 — Rook toleration 완화
9초짜리 쿠버네티스 노드 순단 하나가 큰 사고가 된 직접적인 이유는 Rook이 자신의 파드에 붙이는 축출 유예 시간이 5초였기 때문입니다. 노드에 unreachable 테인트가 붙자마자 operator·mgr·MDS가 즉시 축출되어 재배치되었습니다.
다행히 데이터 경로인 mon과 OSD에는 이 설정이 적용되지 않습니다. 이들은 쿠버네티스 기본값 300초를 쓰기 때문에 축출되지 않았고, 그래서 Ceph 자체는 HEALTH_OK를 유지했습니다. 유예 시간을 60초로 올렸습니다.
# operator가 관리하는 데몬(mgr, MDS, exporter, crashcollector)에 적용
kubectl set env deploy/rook-ceph-operator -n rook-ceph \
  ROOK_UNREACHABLE_NODE_TOLERATION_SECONDS=60

# operator와 tools 자신의 toleration은 설치 매니페스트가 소유하므로 별도 패치
for d in rook-ceph-operator rook-ceph-tools; do
  kubectl patch deploy -n rook-ceph $d --type=json \
    -p='[{"op":"replace","path":"/spec/template/spec/tolerations/0/tolerationSeconds","value":60}]'
done
이 변경은 operator 파드를 재기동시키고, 이어서 mgr과 MDS 배포본이 순차적으로 롤링됩니다. MDS는 hot standby가 있어 전환이 수 초에 그쳤고, CephFS를 사용하는 워크로드 파드는 재시작 없이 그대로 유지되었습니다.
6. 조치 2 — 컨트롤 플레인 메트릭 노출
사후 분석 과정에서 더 불편했던 것은 etcd·scheduler·controller-manager 지표가 통째로 비어 있었다는 점입니다. 28시간 치를 조회해도 이 세 잡의 스크레이프 성공률이 0%였습니다. 장애 순간 컨트롤 플레인이 어떤 상태였는지 확인할 수단이 아예 없었던 셈입니다.
원인은 단순했습니다. kubeadm 기본값이 세 컴포넌트를 모두 루프백에만 바인딩하기 때문에, 노드 IP로 스크레이프하면 구조적으로 연결이 거부됩니다.
마스터 3대의 static pod 매니페스트를 한 대씩 수정했습니다. etcd가 포함되므로 반드시 한 대씩 진행하고, 다음 노드로 넘어가기 전에 쿼럼을 확인해야 합니다.
# 마스터 1대에서 실행 후 검증, 그 다음 노드로 이동
sudo sed -i 's|--bind-address=127.0.0.1|--bind-address=0.0.0.0|' \
  /etc/kubernetes/manifests/kube-controller-manager.yaml \
  /etc/kubernetes/manifests/kube-scheduler.yaml

sudo sed -i -E 's#(- --listen-metrics-urls=).*#\1http://0.0.0.0:2381#' \
  /etc/kubernetes/manifests/etcd.yaml
여기서 한 가지 함정이 있는데, 아래 etcd 이중 바인딩 사례에서 따로 다루겠습니다. 그리고 이 수정만으로는 kubeadm upgrade 시점에 매니페스트가 재생성되면서 모두 되돌아갑니다. kubeadm-config ConfigMap에도 같은 인자를 넣어야 영구적으로 유지됩니다.
이 ConfigMap은 업그레이드와 join 시점에만 읽히므로, 반영해도 실행 중인 컴포넌트에는 영향이 없고 노드 재기동도 발생하지 않습니다.
etcd 이중 바인딩과 스크레이프 오독
etcd가 기동하지 않고 마스터 노드가 NotReady로 빠짐
현상 — 첫 마스터에 위 수정을 적용한 직후 해당 노드가 NotReady가 되었습니다. 2379와 6443 포트가 모두 닫혔고, etcd 쿼럼은 2/3로 떨어졌습니다. 호스트 자체는 살아 있어 SSH와 kubelet 포트는 정상이었습니다.
원인 — 처음에 liveness probe를 배려한다는 이유로 루프백을 남긴 채 와일드카드를 덧붙였습니다. 그런데 0.0.0.0은 루프백을 이미 포함하므로 같은 주소를 두 번 바인딩하게 되어 etcd가 기동에 실패했습니다.
# 잘못된 설정
--listen-metrics-urls=http://127.0.0.1:2381,http://0.0.0.0:2381

# etcd 로그
{"level":"fatal","msg":"discovery failed",
 "error":"listen tcp 127.0.0.1:2381: bind: address already in use"}
해결 — 중복을 제거하고 와일드카드만 남겼습니다. 0.0.0.0이 루프백도 커버하므로 127.0.0.1:2381을 보는 liveness probe는 그대로 동작합니다. 수정 후 kubelet이 약 20초 만에 etcd를 재기동했고, 이어서 API 서버와 kubelet이 차례로 붙으면서 노드가 Ready로 복귀했습니다. etcd는 raft term 변화 없이 같은 인덱스로 깨끗하게 재합류했습니다.
이 작업 중 백업 파일을 /etc/kubernetes/manifests/ 안에 만들지 않도록 주의해야 합니다. kubelet이 그 디렉토리를 감시하므로 백업 파일까지 또 하나의 static pod로 읽어 중복 기동을 일으킵니다.
모든 스크레이프 실패를 클러스터 전역 장애로 오독
현상 — 장애 구간에 Prometheus 타깃이 대량으로 up=0이 되어, 마스터를 포함한 클러스터 전체가 끊긴 것처럼 보였습니다.
원인 — Prometheus 파드가 장애 노드 위에 있었습니다. 관측자가 장애 범위 안에 포함되면 “전부 죽었다”는 결과는 타깃이 아니라 관측자의 상태입니다. 여기에 query_range의 lookback 동작이 겹쳐, 스크레이프가 누락된 구간과 정상 구간을 구분할 수 없었습니다.
해결 — 클러스터 밖의 HAProxy 로그와 ARP 테이블을 독립 관측자로 사용해 범위를 다시 그렸습니다. 모니터링 스택이 감시 대상과 같은 장애 도메인에 있으면 그 스택의 데이터만으로는 범위를 확정할 수 없다는 점이 이번 분석의 가장 큰 교훈이었습니다.
축출 유예 60초와 컨트롤 플레인 메트릭 9/9
조치 이후에는 쿠버네티스 노드 순단 발생 시에도 스토리지 컨트롤 파드가 즉시 축출되지 않으며, 컨트롤 플레인 지표도 사후 분석이 가능한 수준으로 확보되었습니다.
항목
조치 전
조치 후
Rook 파드 축출 유예
5초
60초
etcd / scheduler / controller-manager 스크레이프
0 / 9 성공
9 / 9 성공
kubeadm upgrade 후 설정 유지
되돌아감
유지됨
etcd 쿼럼
3 / 3
3 / 3
변경 직후 뜻하지 않게 실전 검증도 이루어졌습니다. 마지막 마스터를 수정하면서 etcd 리더 선출이 일어났고, 그 여파로 노드 3대가 잠시 NotReady로 표시되었습니다. 기존 5초 설정이었다면 operator와 mgr, MDS가 그대로 축출되었을 상황입니다.
kubectl get pods -n rook-ceph

# 축출된 파드 없음 - AGE가 모두 toleration 변경 시점이거나 그 이전
rook-ceph-operator-...     1/1  Running  0  26m   # 설정 변경 시점
rook-ceph-mgr-a-...        3/3  Running  0  25m
rook-ceph-mds-myfs-a-...   2/2  Running  0  25m
rook-ceph-mon-a-...        2/2  Running  0  35d   # 무변동
rook-ceph-osd-0-...        2/2  Running  0  35d   # 무변동
Ceph 파드 축출은 한 건도 발생하지 않았고, 노드는 자동으로 Ready로 복귀했습니다. 최종 상태는 노드 6대 Ready, 비정상 파드 0, etcd 쿼럼 3/3, Ceph HEALTH_OK입니다.
다만 정직하게 남겨둘 부분이 있습니다. 노드가 왜 9초간 사라졌는지는 아직 확정하지 못했습니다. 이번 조치는 원인 제거가 아니라 피해 범위를 줄이는 완화책이며, 하이퍼바이저 계층의 이벤트 로그를 확보하기 전까지는 재발 가능성이 남아 있습니다.
WordPress 관리 화면의 플러그인 업데이트 알림 문구가 새 버전을 설치한 뒤에도 사라지지 않고 계속 다시 뜨는 문제를 처리한 기록입니다. 업데이트는 성공했다고 표시되는데 화면을 새로고침하면 같은 플러그인의 업데이트 알림이 다시 떠 있었습니다.
처음에는 Kubernetes로 이전하면서 생긴 파일 권한이나 스토리지 문제로 의심했습니다. 확인해 보니 서로 무관한 두 가지 원인이 겹쳐 있었고, 두 번째 원인은 이쪽 환경 문제가 아니라 배포된 플러그인 패키지 자체의 문제였습니다. 같은 증상을 겪는 경우 진단 순서를 줄일 수 있도록 정리합니다.
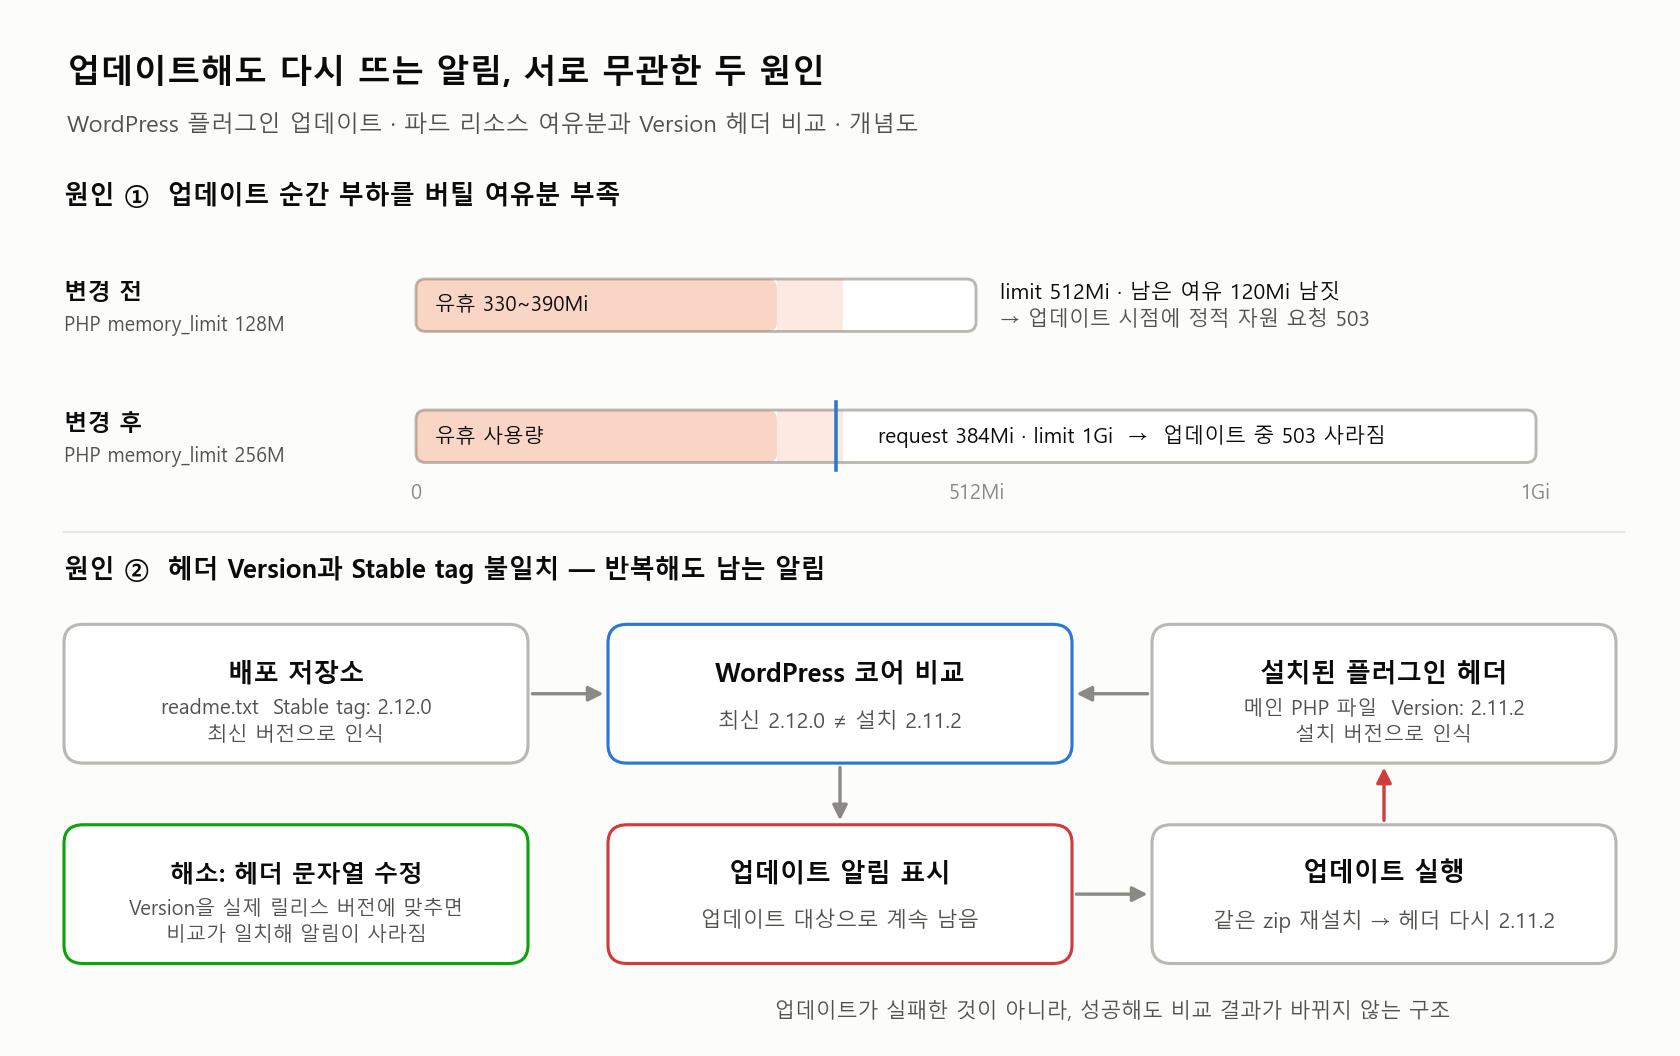
플러그인 업데이트 알림 표시가 반복된 두 원인: 리소스 여유분 부족과 Version 헤더 불일치.
환경
구성 요소
내용
플랫폼
Kubernetes 자체 관리형 클러스터
애플리케이션
WordPress (Apache + PHP 8.4, 커스텀 이미지)
스토리지
Rook CephFS (RWX), /var/www/html 전체 마운트
변경 전 리소스
request 100m / 256Mi, limit 500m / 512Mi
변경 전 PHP
memory_limit = 128M (이전 서버에서 그대로 승계)
원인 ① — 업데이트 작업을 버틸 리소스 여유분 부족
먼저 파드의 실제 사용량을 확인했습니다.
kubectl top pod -n wordpress-system
아무 작업도 하지 않는 유휴 상태에서 이미 330~390Mi를 사용하고 있었습니다. 활성화된 플러그인이 여러 개인데 지속형 오브젝트 캐시를 쓰지 않는 구성이라 기본 사용량 자체가 높은 상태였습니다. 그런데 메모리 limit은 512Mi였습니다.
플러그인 업데이트는 순간적으로 부하가 몰리는 작업입니다. ZipArchive로 압축을 풀고 Plugin_Upgrader가 파일을 교체하는 동안 메모리와 CPU를 함께 사용합니다. 남은 여유가 120Mi 남짓인 상태에서는 이 작업을 안정적으로 끝내기 어렵습니다. 실제로 업데이트를 시도한 시점에 무관한 정적 자원 요청이 503으로 실패한 것이 같은 시간대에 관측되었습니다.
PHP 쪽도 이전 서버에서 memory_limit = 128M을 그대로 가져온 상태였습니다. 컨테이너의 cgroup 제한과 별개로 PHP 프로세스 자체가 자기 한도에 먼저 걸릴 수 있는 값입니다.
PHP 설정이 이미지에 포함되어 있어 이미지를 다시 빌드해 태그를 올린 뒤 배포했습니다. 이후 업데이트 도중 503이 발생하는 현상은 사라졌습니다.
원인 ② — 업스트림 패키지의 버전 헤더 불일치
리소스를 확보한 뒤 업데이트는 깨끗하게 완료되었습니다. 그런데도 업데이트 알림은 여전히 다시 나타났습니다.
여기서부터는 이쪽 환경 문제가 아니었습니다. WordPress가 설치된 플러그인의 버전을 어디에서 읽는지 확인하면 원인이 드러납니다. WordPress 코어는 플러그인 메인 PHP 파일 상단의 헤더 주석에 적힌 Version: 값을 설치된 버전으로 인식합니다. readme.txt의 Stable tag가 아닙니다.
설치된 파일의 헤더와 readme.txt를 직접 비교했습니다.
# 플러그인 메인 파일의 헤더 확인
grep -m1 "Version:" wp-content/plugins/<plugin-dir>/<plugin>.php
# Version: 2.11.2        ← 설치된 버전으로 인식되는 값

# 같은 패키지의 readme.txt
grep -m1 "Stable tag:" wp-content/plugins/<plugin-dir>/readme.txt
# Stable tag: 2.12.0     ← 배포 저장소가 최신으로 인식하는 값
공식 배포 zip 안에서 두 값이 어긋나 있었습니다. 릴리스를 내면서 readme.txt의 Stable tag는 올렸는데 플러그인 파일의 헤더 주석은 이전 버전 문자열이 그대로 남아 있는 상태였습니다.
이 경우 알림은 구조적으로 사라질 수 없습니다. WordPress는 저장소가 알려주는 최신 버전과 헤더에서 읽은 설치 버전을 비교하는데, 업데이트를 아무리 반복해도 같은 헤더 문자열이 다시 설치되므로 두 값은 영원히 불일치합니다. 업데이트가 실패한 것이 아니라 성공해도 상태가 갱신되지 않는 것입니다.
공식 릴리스 내용으로 파일을 교체한 뒤 헤더의 버전 문자열만 실제 릴리스 버전에 맞게 직접 수정해 해소했습니다. 동작에는 영향이 없고 WordPress가 비교하는 문자열만 맞추는 일회성 조치입니다. 이 사례는 2026년 8월 시점에 특정 플러그인에서 관측한 것으로, 이후 배포본에서는 수정되었을 수 있습니다.
진단 순서
같은 증상을 만났을 때 확인 순서를 정리하면 다음과 같습니다.
단계
확인 내용
해당하면
1
kubectl top pod으로 유휴 사용량과 limit 사이 여유분
리소스 상향
2
업데이트 시점 전후의 503·타임아웃 로그
리소스 상향
3
설치된 플러그인의 헤더 Version: vs readme.txt의 Stable tag
업스트림 패키징 문제
4
파일 소유자·권한, 스토리지 쓰기 가능 여부
권한 문제
1~2단계가 정상인데 알림이 계속 반복된다면 3단계를 먼저 보시기를 권합니다. 권한이나 스토리지를 의심하며 시간을 쓰기 쉬운 지점인데, 헤더 한 줄만 비교하면 바로 판별됩니다.
리소스 반영과 알림 해소 확인
# 파드 리소스 반영 확인
kubectl get deploy -n wordpress-system wordpress \
  -o jsonpath='{.spec.template.spec.containers[0].resources}'

# 적용된 PHP memory_limit 확인
kubectl exec -n wordpress-system deploy/wordpress -- php -i | grep memory_limit

# 유휴 사용량과 limit 사이 여유분 재확인
kubectl top pod -n wordpress-system
리소스 상향 후 유휴 사용량 대비 여유가 확보되었고, 헤더 수정 후 관리 화면에 플러그인 업데이트 알림 문구가 더 이상 나타나지 않는 것을 확인했습니다.
정리
이전 작업에서 승계한 리소스 설정은 한 번 점검할 가치가 있습니다. 기존 서버에서 문제없이 돌던 값이라도 컨테이너 환경에서는 limit이 곧 하드 제한이라 여유분의 의미가 달라집니다. 특히 유휴 상태 사용량이 limit의 70%를 넘고 있다면 순간 부하를 견딜 여지가 거의 없는 상태입니다.
그리고 모든 증상이 내 환경 탓은 아닙니다. 이번처럼 배포된 패키지 자체의 메타데이터가 어긋난 경우, 인프라를 아무리 고쳐도 증상은 사라지지 않습니다. 재현되는 문제를 계속 자기 쪽에서만 찾고 있다면 업스트림이 보내온 것을 직접 열어보는 단계를 진단 순서에 넣어두는 편이 좋습니다.