태그 보관물: kubernetes

Upgrading Kubernetes Add-ons: Calico, MetalLB, and Traefik

v1.36 승급과 함께 올린 애드온 4종

클러스터를 v1.33에서 v1.36까지 올리면서 Kubernetes 애드온 업그레이드 순서도 함께 정해야 했습니다. 클러스터 코어만 올리면 끝나는 작업이라 생각했는데, 실제로는 CNI·로드밸런서·Ingress·메트릭 수집기를 각각 어느 시점에 어떤 버전으로 올릴지가 전체 일정과 무중단 여부를 결정했습니다.

이 글에서는 Calico, MetalLB, metrics-server의 버전 업그레이드와 Traefik 이중화 작업을 정리합니다. 특히 업스트림 표준 매니페스트를 그대로 적용했을 때 로컬 커스터마이즈가 조용히 사라지는 문제와, 그 과정에서 실측한 서비스 단절 시간에 초점을 맞췄습니다.

결과부터 말하면 애드온 업그레이드 구간은 전부 무중단이었습니다. 다만 그렇게 만들기 위해 사전에 확인해야 했던 항목이 네 가지 있었고, 그중 두 개는 kubectl diff 출력을 눈으로 확인해야만 발견되는 것이었습니다.

환경

자체 관리형 Kubernetes 클러스터입니다. 컨트롤플레인 3대와 워커 3대로 구성되어 있고, 컨테이너 런타임은 Docker + cri-dockerd입니다.

구성요소 업그레이드 전 업그레이드 후 방식
Kubernetes v1.33.7 v1.36.3 kubeadm, 마이너 3단계
Calico v3.30.7 v3.32.1 매니페스트, 2단계 경유
MetalLB v0.14.5 v0.16.0 매니페스트 + nodeSelector 재적용
metrics-server v0.7.1 v0.9.0 이미지만 교체
Traefik v3.7.5 (replica 1) v3.7.5 (replica 2) Helm values 변경
CoreDNS v1.12.0 v1.14.2 kubeadm 자동

MetalLB는 L2 모드로 운영 중이며 VIP 3개를 할당하고 있습니다. Ingress는 Traefik이 담당하고, Calico는 IPIP 모드에 자체 IPPool을 사용합니다. 노드 IP와 호스트명은 이 글에서 일반화해 표기합니다.

버전 범위에 맞춘 순서 설계와 애드온별 적용

1. 애드온 업그레이드 순서 설계

가장 먼저 결정한 것은 순서였습니다. 애드온마다 지원하는 Kubernetes 버전 범위가 다르기 때문에, 아무 시점에나 올리면 중간 상태가 공식 테스트 매트릭스 밖으로 나갑니다.

Calico의 경우 v3.31은 Kubernetes 1.32~1.35를, v3.32는 1.34~1.36을 테스트합니다. 그래서 v3.30.7에서 v3.32.1로 한 번에 올리지 않고 두 단계로 나눴습니다.

K8s 1.33 상태 → Calico v3.31.6 적용   (1.32~1.35 지원)
K8s 1.34, 1.35 업그레이드
K8s 1.35 상태 → Calico v3.32.1 적용   (1.34~1.36 지원)
K8s 1.36 업그레이드

이렇게 하면 모든 중간 상태가 지원 범위 안에 들어옵니다. MetalLB와 metrics-server는 Kubernetes 버전 의존성이 느슨해서 클러스터 업그레이드를 모두 마친 뒤 마지막에 올렸습니다.
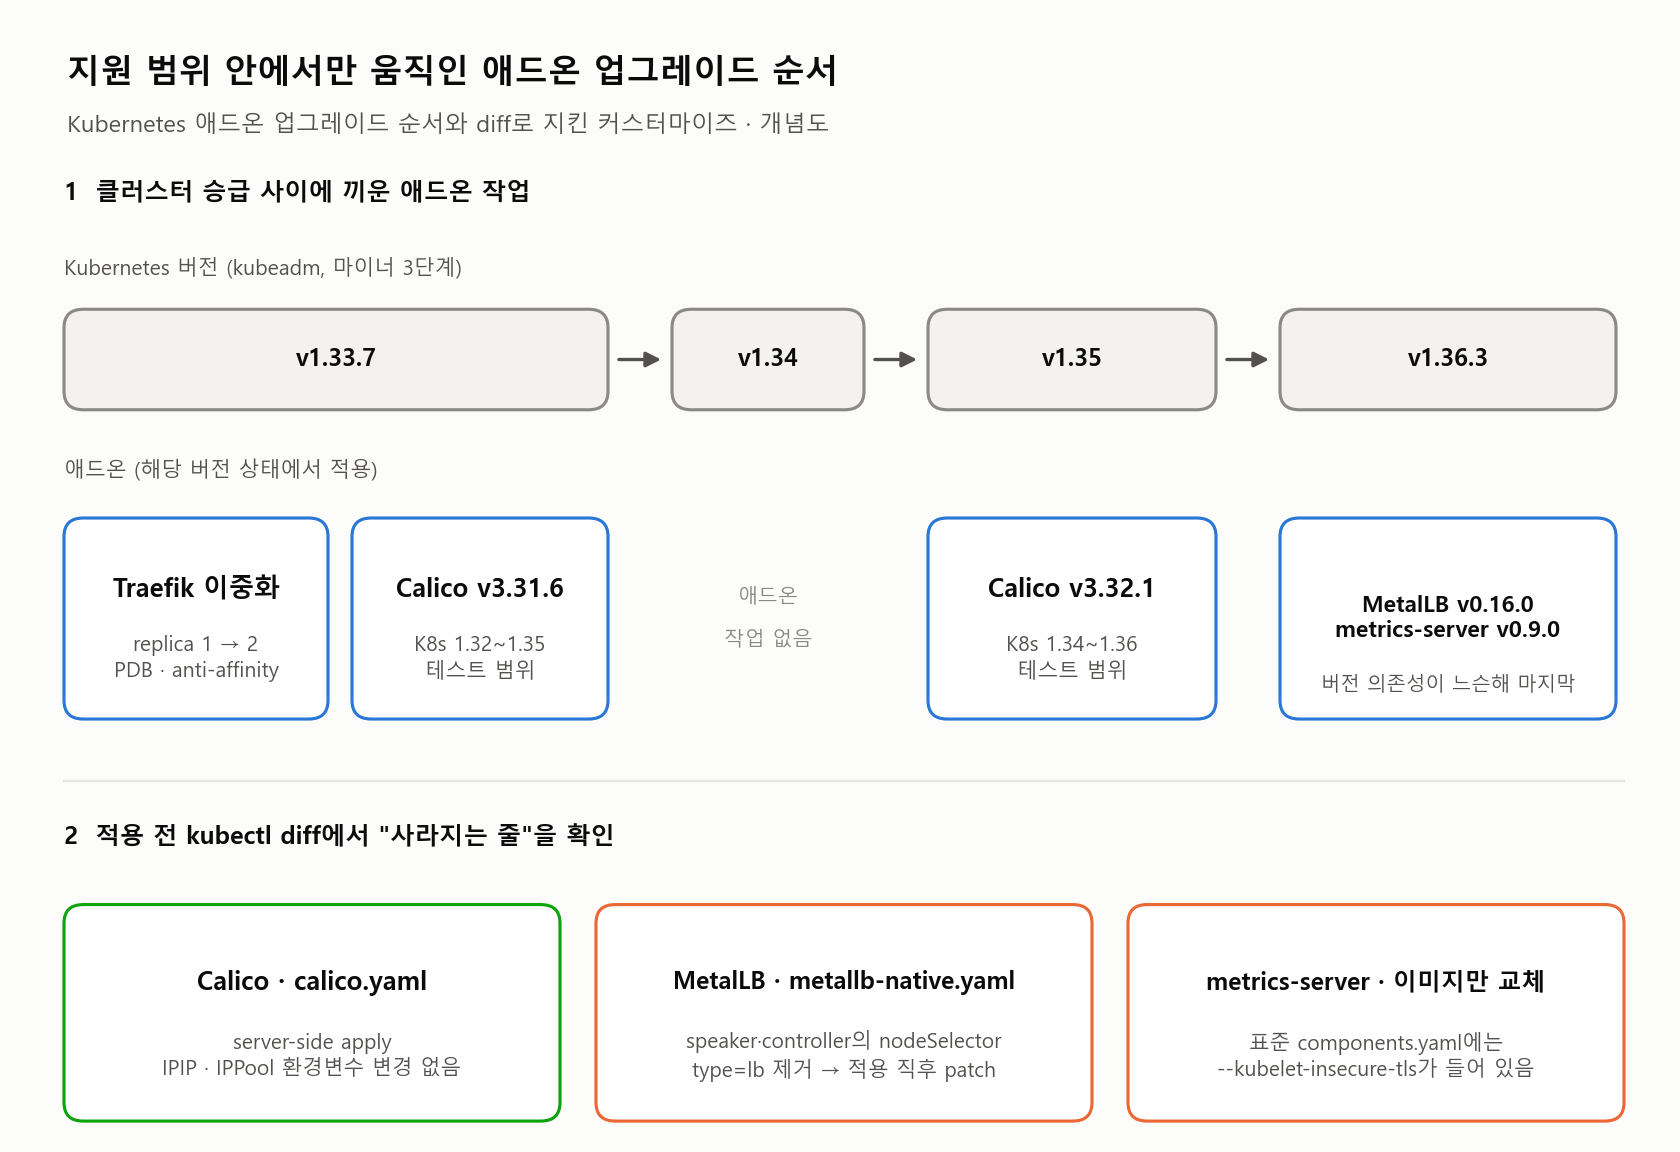
Kubernetes 애드온 업그레이드 순서를 v1.33.7부터 v1.36.3까지 클러스터 버전별로 나눠 Traefik 이중화, Calico 두 단계, MetalLB와 metrics-server 적용 시점과 diff 확인 항목을 보여 주는 개념도입니다.
Kubernetes 애드온 업그레이드 시점은 Calico 테스트 범위에 맞춰 나눴고, MetalLB와 metrics-server는 마지막에 올렸습니다.

2. Traefik 이중화 — 클러스터 업그레이드 전 필수 선행 작업

클러스터 업그레이드는 워커 노드를 순차적으로 drain합니다. 그런데 Traefik이 replica 1개로 떠 있었기 때문에, 그 노드를 drain하는 순간 모든 Ingress 호스트가 30~60초씩 끊기는 구조였습니다. 마이너 3단계 × 워커 3대면 이 단절이 반복됩니다.

Helm values에 replica 2개, PodDisruptionBudget, 노드 분산 anti-affinity를 추가했습니다.

deployment:
  replicas: 2

podDisruptionBudget:
  enabled: true
  minAvailable: 1

affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchLabels:
            app.kubernetes.io/name: traefik
            app.kubernetes.io/instance: traefik-traefik
        topologyKey: kubernetes.io/hostname

anti-affinity를 required로 둔 이유는, 두 파드가 같은 워커에 몰리면 이중화 의미가 없어지기 때문입니다. PDB는 drain이 두 파드를 동시에 축출하지 못하게 막습니다.

적용은 helm upgrade로 했고, 차트의 롤아웃 전략이 이미 maxUnavailable: 0 / maxSurge: 1이라 기존 파드를 유지한 채 새 파드가 먼저 올라옵니다. 0.5초 간격 프로브로 278회를 측정했는데 전부 HTTP 200이었습니다.

3. Calico 업그레이드 — server-side apply

Calico는 매니페스트 방식으로 설치되어 있어 업스트림 calico.yaml을 적용합니다. 공식 문서가 --server-side --force-conflicts를 권장하는데, 일반 kubectl apply는 CRD 어노테이션 크기 제한(262144 bytes)에 걸릴 수 있기 때문입니다.

curl -fsSLO https://raw.githubusercontent.com/projectcalico/calico/v3.32.1/manifests/calico.yaml

# 커스터마이즈가 사라지지 않는지 먼저 확인
kubectl diff -f calico.yaml | head -100

kubectl apply --server-side --force-conflicts -f calico.yaml
kubectl -n kube-system rollout status ds/calico-node --timeout=600s

diff에서 확인해야 할 것은 환경변수입니다. IPIP 모드나 IPPool CIDR이 매니페스트 기본값으로 덮이면 네트워크가 끊깁니다. 두 번의 Calico 업그레이드 모두 환경변수 변경이 없었고, 바뀐 것은 이미지 태그와 init 컨테이너 이름, CRD 스키마, ClusterRole의 가산적 권한뿐이었습니다.

한 가지 주의할 점은 v3.31부터 이미지 레지스트리가 docker.io에서 quay.io로 바뀐다는 것입니다. 노드에서 quay.io 도달이 안 되면 롤아웃이 중간에 멈춥니다.

DaemonSet은 노드 1대씩 롤링되며 6노드 기준 약 4분이 걸렸습니다. 이 구간에 노드 Ready 상태는 6/6을 유지했고, 기존 파드의 네트워크 경로는 Calico 재시작 중에도 끊기지 않았습니다.

4. MetalLB v0.16.0 — nodeSelector 재적용이 핵심

MetalLB는 표준 metallb-native.yaml을 적용합니다. 그런데 이 클러스터는 speaker DaemonSet과 controller Deployment에 nodeSelector: type=lb를 걸어 워커 3대에만 배치하도록 커스터마이즈해두었습니다. 표준 매니페스트에는 이 설정이 없습니다.

즉 그대로 적용하면 nodeSelector가 사라집니다. speaker DaemonSet은 control-plane taint에 대한 toleration을 가지고 있어서, 셀렉터가 없어지면 컨트롤플레인 노드에도 배치됩니다.

# 적용 전 반드시 확인 — 제거되는 줄(-)이 있는지
kubectl diff -f metallb-native.yaml | grep -E "^[+-].*(nodeSelector|type: lb)"
#   -        type: lb
#   -        type: lb        ← speaker, controller 두 곳에서 제거됨

kubectl apply -f metallb-native.yaml

# 적용 직후 즉시 복구 (창을 최소화)
kubectl -n metallb-system patch ds speaker \
  -p '{"spec":{"template":{"spec":{"nodeSelector":{"type":"lb"}}}}}'
kubectl -n metallb-system patch deploy controller \
  -p '{"spec":{"template":{"spec":{"nodeSelector":{"type":"lb"}}}}}'

IPAddressPool과 L2Advertisement 같은 CR은 별도 리소스이므로 매니페스트 적용으로 사라지지 않습니다. 이 부분은 아래 CRD와 CR 구분 항목에서 다시 설명하겠습니다.

적용과 patch를 이어서 실행하고 롤아웃을 기다린 결과, VIP 3개가 모두 유지되고 speaker는 워커 3대에만 배치됐습니다. 이 구간에도 서비스 단절은 없었습니다.

5. metrics-server v0.9.0 — 이미지만 교체

metrics-server는 표준 components.yaml을 적용하지 않았습니다. 현재 배포에는 --kubelet-insecure-tls가 의도적으로 빠져 있는데, 표준 매니페스트는 이 플래그를 포함하고 있어 적용하면 보안 수준이 낮아지기 때문입니다.

# 현재 인자 확인 — --kubelet-insecure-tls 가 없는 상태를 지켜야 함
kubectl -n kube-system get deploy metrics-server \
  -o jsonpath='{.spec.template.spec.containers[0].args}'

# 이미지만 교체
kubectl -n kube-system set image deploy/metrics-server \
  metrics-server=registry.k8s.io/metrics-server/metrics-server:v0.9.0

kubectl -n kube-system rollout status deploy/metrics-server --timeout=180s
kubectl top nodes

인자 5개가 그대로 유지되는지 적용 후 다시 확인했고, kubectl top nodes로 6노드 메트릭이 정상 수집되는 것을 검증했습니다.

diff와 로그에서 드러난 다섯 가지 함정

externalTrafficPolicy 때문에 VIP가 22초 사라진 문제

현상 — 워커 노드를 drain했을 때 데이터베이스 VIP가 22초간 응답하지 않았습니다. 그런데 해당 VIP가 가리키는 파드는 다른 노드에 있었고 정상 동작 중이었습니다. 데이터베이스 클러스터도 쿼럼을 유지하고 있었습니다.

원인 — MetalLB speaker 로그가 답을 줬습니다.

kubectl -n metallb-system logs -l component=speaker --since=5m \
  | grep -E "serviceAnnounced|serviceWithdrawn"

# serviceAnnounced  ips=[192.168.x.x]
# serviceWithdrawn  reason="notOwner"     ← 소유권 상실
# serviceAnnounced  ips=[192.168.x.x]     ← 22초 후 재광고

해당 Service의 externalTrafficPolicy가 기본값인 Cluster였습니다. 이 설정에서는 엔드포인트가 없는 노드도 VIP를 광고할 수 있습니다. 광고 중이던 노드를 cordon하자 MetalLB가 L2 소유권을 재선출했고, 그 사이 LAN에 VIP가 존재하지 않았던 것입니다.

즉 데이터베이스 계층의 문제가 아니라 로드밸런서 계층의 문제였습니다. 파드 상태만 확인했다면 원인을 엉뚱한 곳에서 찾았을 것입니다.

해결 — externalTrafficPolicy: Local로 변경했습니다. 이 값이면 엔드포인트를 가진 노드만 VIP를 광고하므로, 다른 노드를 drain해도 소유권이 흔들리지 않습니다.

kubectl -n <namespace> patch svc <service-name> \
  -p '{"spec":{"externalTrafficPolicy":"Local"}}'

kubectl -n <namespace> get svc <service-name> \
  -o jsonpath='{.spec.externalTrafficPolicy} {.spec.healthCheckNodePort}'
# Local 30797     ← healthCheckNodePort 가 새로 할당됨

변경 후 다른 워커를 drain해봤을 때 VIP 단절은 0초였습니다. 부수 효과로 SNAT가 사라져 클라이언트 소스 IP가 보존되는데, 접속 제한이나 접속 로그를 소스 IP 기준으로 운영한다면 이 변화도 함께 고려해야 합니다.

참고로 오퍼레이터가 관리하는 Service였는데, 커스텀 리소스에 이 필드를 넣어도 이미 존재하는 Service에는 반영되지 않았습니다. 매니페스트에 선언해두고 실행 중인 Service는 직접 patch하는 두 가지 작업이 모두 필요했습니다.

Helm values 병합이 만든 중복 키

현상 — 병합 요청에서 충돌 1건이 보고됐고, 충돌 자체는 같은 값에 주석만 다른 사소한 것이었습니다. 그런데 병합 결과를 검사해보니 traefik-values.yaml에 최상위 deployment: 키가 두 개 있었습니다.

14: deployment:
      replicas: 2                  # 이중화를 위해 추가한 설정

65: deployment:
      revisionHistoryLimit: 5      # 다른 브랜치에서 추가한 공통 정책

원인 — 두 변경이 파일의 다른 위치에 있었기 때문에 Git이 텍스트 기준으로 충돌 없이 병합했습니다. 그러나 YAML은 같은 키가 중복되면 뒤에 나온 값이 앞을 덮습니다. 결과적으로 replicas: 2가 무효화되어 Traefik이 다시 1개로 돌아갈 상황이었습니다.

업그레이드 무중단을 위해 일부러 넣은 설정이 병합 과정에서 조용히 사라지는 셈입니다. 다음 유지보수 때 원인 모를 Ingress 단절로 나타났을 것입니다.

해결 — 두 블록을 하나로 합쳤습니다. 그리고 이런 유형을 자동으로 잡기 위해 중복 키를 오류로 처리하는 YAML 로더로 브랜치 전체를 검사했습니다. 표준 파서는 중복 키를 조용히 허용하므로 일반 문법 검사로는 발견되지 않습니다.

python3 - <<'EOF'
import yaml
class Dup(yaml.SafeLoader): pass
def nodup(loader, node, deep=False):
    m = {}
    for k, v in node.value:
        key = loader.construct_object(k, deep=deep)
        if key in m:
            raise ValueError(f"중복 키: {key!r} (line {k.start_mark.line+1})")
        m[key] = loader.construct_object(v, deep=deep)
    return m
Dup.add_constructor(yaml.resolver.BaseResolver.DEFAULT_MAPPING_TAG, nodup)

for f in ['helm/traefik-values.yaml', 'helm/monitoring-values.yaml']:
    try:
        list(yaml.load_all(open(f), Loader=Dup))
        print(f"OK   {f}")
    except Exception as e:
        print(f"FAIL {f}  {e}")
EOF

Helm values는 여러 사람이 서로 다른 섹션을 건드리기 쉬운 파일입니다. 병합 후 이 검사를 한 번 돌리는 것만으로 상당한 위험을 줄일 수 있습니다.

메트릭 포트 변경이 관측성을 조용히 끊는 경우

현상 — MetalLB 0.16의 diff를 보다가 메트릭 포트가 바뀐 것을 발견했습니다.

-        prometheus.io/port: "7472"
+        prometheus.io/port: "9120"
-        - --port=7472
+        - --port=9120
-        - containerPort: 7472
-          name: monitoring
+        - containerPort: 9120
+          name: metricshttps

원인 — 0.16부터 kube-rbac-proxy가 네이티브 TLS로 교체되면서 포트 번호와 포트 이름이 함께 바뀌었습니다. ServiceMonitor는 보통 포트 이름으로 타깃을 지정하므로, monitoring을 참조하던 설정은 매칭에 실패합니다.

문제는 이 실패가 오류로 드러나지 않는다는 점입니다. 스크레이프 타깃이 사라져도 파드는 정상이고 애플리케이션도 정상이며, 그저 그래프가 빈칸이 됩니다.

해결 — 이 클러스터에는 MetalLB용 ServiceMonitor가 없어 실제 영향은 없었습니다. 다만 애드온을 올릴 때 스크레이프 설정 존재 여부를 먼저 확인하는 절차를 추가했습니다.

# 해당 애드온을 스크레이프하는 설정이 있는지 먼저 확인
kubectl get servicemonitor,podmonitor -A | grep -i metallb

# 있다면 diff 에서 포트 이름 변경을 확인하고 함께 수정
kubectl diff -f metallb-native.yaml | grep -E "^[+-].*(port|name: metric|name: monitoring)"

CRD와 CR을 grep으로 구분하려다 오판한 경우

현상 — 적용 전 안전성을 확인하려고 매니페스트에서 우리 CR이 정의되어 있는지 검색했습니다.

grep -cE "kind: (IPAddressPool|L2Advertisement)" metallb-native.yaml
#   2      ← "인스턴스가 2개 들어 있다"고 오판

원인 — 매칭된 것은 CustomResourceDefinition의 spec.names.kind 필드였습니다. CRD는 자신이 정의하는 리소스의 종류 이름을 이 필드에 담고 있어서, 들여쓰기를 무시한 검색으로는 실제 인스턴스와 구분되지 않습니다.

해결 — 행 시작 앵커를 붙여 최상위 문서의 kind:만 세면 됩니다.

grep -c "^kind: IPAddressPool" metallb-native.yaml
#   0      ← 인스턴스 없음. 우리 CR 은 안전

# 매니페스트에 포함된 리소스 종류 전체를 보는 편이 더 확실
grep -E "^kind:" metallb-native.yaml | sort | uniq -c | sort -rn

실제로 metallb-native.yaml에는 CRD 9개, RBAC, Deployment, DaemonSet만 들어 있고 IPAddressPool·L2Advertisement 인스턴스는 없습니다. 따라서 IP 풀 설정은 매니페스트 적용으로 사라지지 않습니다.

Git과 클러스터가 어긋난 것을 나중에 발견한 경우

현상 — 병합 후 매니페스트와 클러스터를 대조했더니 Traefik의 revisionHistoryLimit이 저장소에는 5, 클러스터에는 10으로 달랐습니다.

원인 — 다른 브랜치가 이 값을 저장소에 커밋했지만, 이 작업 브랜치에서 helm upgrade를 두 번 실행할 때 그 필드가 없는 버전의 values 파일을 사용했습니다. 결과적으로 클러스터를 차트 기본값으로 되돌린 셈이 됐습니다.

kubectl apply로 관리하는 리소스는 파일이 곧 선언이라 이런 드리프트가 잘 드러납니다. 반면 Helm은 실행 시점에 넘긴 values가 반영되므로, 저장소 파일이 최신이어도 마지막 helm upgrade가 구버전 파일이었다면 클러스터는 뒤처집니다.

해결 — 병합된 values로 helm upgrade를 다시 실행해 맞췄습니다. revisionHistoryLimit은 파드 템플릿이 아니라 Deployment 스펙 필드라 롤아웃이 발생하지 않고, 파드는 재시작조차 하지 않았습니다.

# 매니페스트 파싱값과 클러스터 실제값을 대조
python3 -c "import yaml; d=yaml.safe_load(open('helm/traefik-values.yaml')); \
  print('manifest:', d['deployment'])"
kubectl -n traefik get deploy traefik \
  -o jsonpath='cluster: replicas={.spec.replicas} rhl={.spec.revisionHistoryLimit}'

애드온 작업 후에는 파일만 확인하지 말고 클러스터 실제값과 한 번 대조하는 편이 안전합니다.

Kubernetes 애드온 업그레이드 최종 상태와 실측 단절 시간

애드온 4종의 최종 상태입니다. 모든 구성요소가 목표 버전에 도달했고 정상 동작합니다.

kubectl -n kube-system get ds calico-node \
  -o jsonpath='calico     : {.spec.template.spec.containers[0].image} {.status.numberReady}/{.status.desiredNumberScheduled}{"\n"}'
kubectl -n metallb-system get ds speaker \
  -o jsonpath='metallb    : {.spec.template.spec.containers[0].image} {.status.numberReady}/{.status.desiredNumberScheduled}{"\n"}'
kubectl -n kube-system get deploy metrics-server \
  -o jsonpath='metrics    : {.spec.template.spec.containers[0].image}{"\n"}'
kubectl -n traefik get deploy traefik \
  -o jsonpath='traefik    : {.spec.template.spec.containers[0].image} {.status.readyReplicas}/{.status.replicas}{"\n"}'

# calico     : quay.io/calico/node:v3.32.1  6/6
# metallb    : quay.io/metallb/speaker:v0.16.0  3/3
# metrics    : registry.k8s.io/metrics-server/metrics-server:v0.9.0
# traefik    : docker.io/traefik:v3.7.5  2/2

커스터마이즈 보존 여부도 함께 확인했습니다. Calico의 IPIP 모드와 IPPool CIDR, MetalLB의 nodeSelector와 IP 풀, metrics-server의 인자 5개가 모두 그대로입니다.

kubectl get ippools.crd.projectcalico.org \
  -o custom-columns=NAME:.metadata.name,CIDR:.spec.cidr,IPIP:.spec.ipipMode --no-headers
kubectl -n metallb-system get ds speaker \
  -o jsonpath='{.spec.template.spec.nodeSelector}{"\n"}'
kubectl get svc -A --field-selector spec.type=LoadBalancer \
  -o custom-columns=NS:.metadata.namespace,NAME:.metadata.name,IP:.status.loadBalancer.ingress[0].ip --no-headers

Kubernetes 애드온 업그레이드 구간의 실측 단절 시간은 다음과 같습니다. 외부에서 1초 간격으로 HTTP 응답과 VIP TCP 도달성을 측정했습니다.

작업 실측 단절 측정 방식
Traefik 이중화 (replica 1 → 2) 0초 0.5초 간격 278회, 전부 200
Calico v3.31.6 0초 174회, 노드 Ready 6/6 유지
Calico v3.32.1 0초 DB 클러스터 크기 이탈 0회
MetalLB v0.16.0 0초 VIP 3개 유지
metrics-server v0.9.0 0초 인자 보존 확인
Traefik values 정렬 0초 150회, 파드 재시작 없음

애드온 업그레이드 자체는 전부 무중단이었습니다. 실제 단절이 발생한 것은 클러스터 노드를 drain하는 구간이었고, 그중 22초는 위에서 다룬 externalTrafficPolicy 문제였습니다.

결론

이번 Kubernetes 애드온 업그레이드 과정에서 가장 유용했던 습관은 kubectl diff의 제거되는 줄을 눈으로 확인하는 것이었습니다. 업스트림 매니페스트는 우리 환경의 커스터마이즈를 알지 못하므로, 추가되는 내용보다 사라지는 내용이 더 위험합니다.

두 번째는 “성공했다는 신호”를 그대로 믿지 않는 것입니다. Git이 충돌 없이 병합했다고 결과가 올바른 것은 아니었고, YAML 파서가 통과시켰다고 설정이 의도대로 남은 것도 아니었습니다. 적용 후 실제 값을 다시 조회해 확인해야 발견되는 문제들이었습니다.

세 번째는 단절의 원인을 계층별로 분리해 보는 것입니다. VIP가 끊겼을 때 데이터베이스를 먼저 의심했지만 실제 원인은 로드밸런서의 소유권 재선출이었습니다. 파드 상태만 확인했다면 찾지 못했을 원인이고, speaker 로그가 결정적인 단서를 줬습니다.

애드온마다 지원하는 Kubernetes 버전 범위가 다르다는 점도 미리 확인할 가치가 있었습니다. Calico를 두 단계로 나눈 덕분에 모든 중간 상태가 공식 테스트 범위 안에 머물렀습니다.

참고

관련 포스트:

참고 문서: Calico Upgrade · MetalLB Release Notes · Kubernetes Source IP and externalTrafficPolicy · metrics-server
Migrating Standalone MariaDB to a Galera Cluster on Kubernetes

drain할 때마다 2~3분씩 끊기던 단일 인스턴스

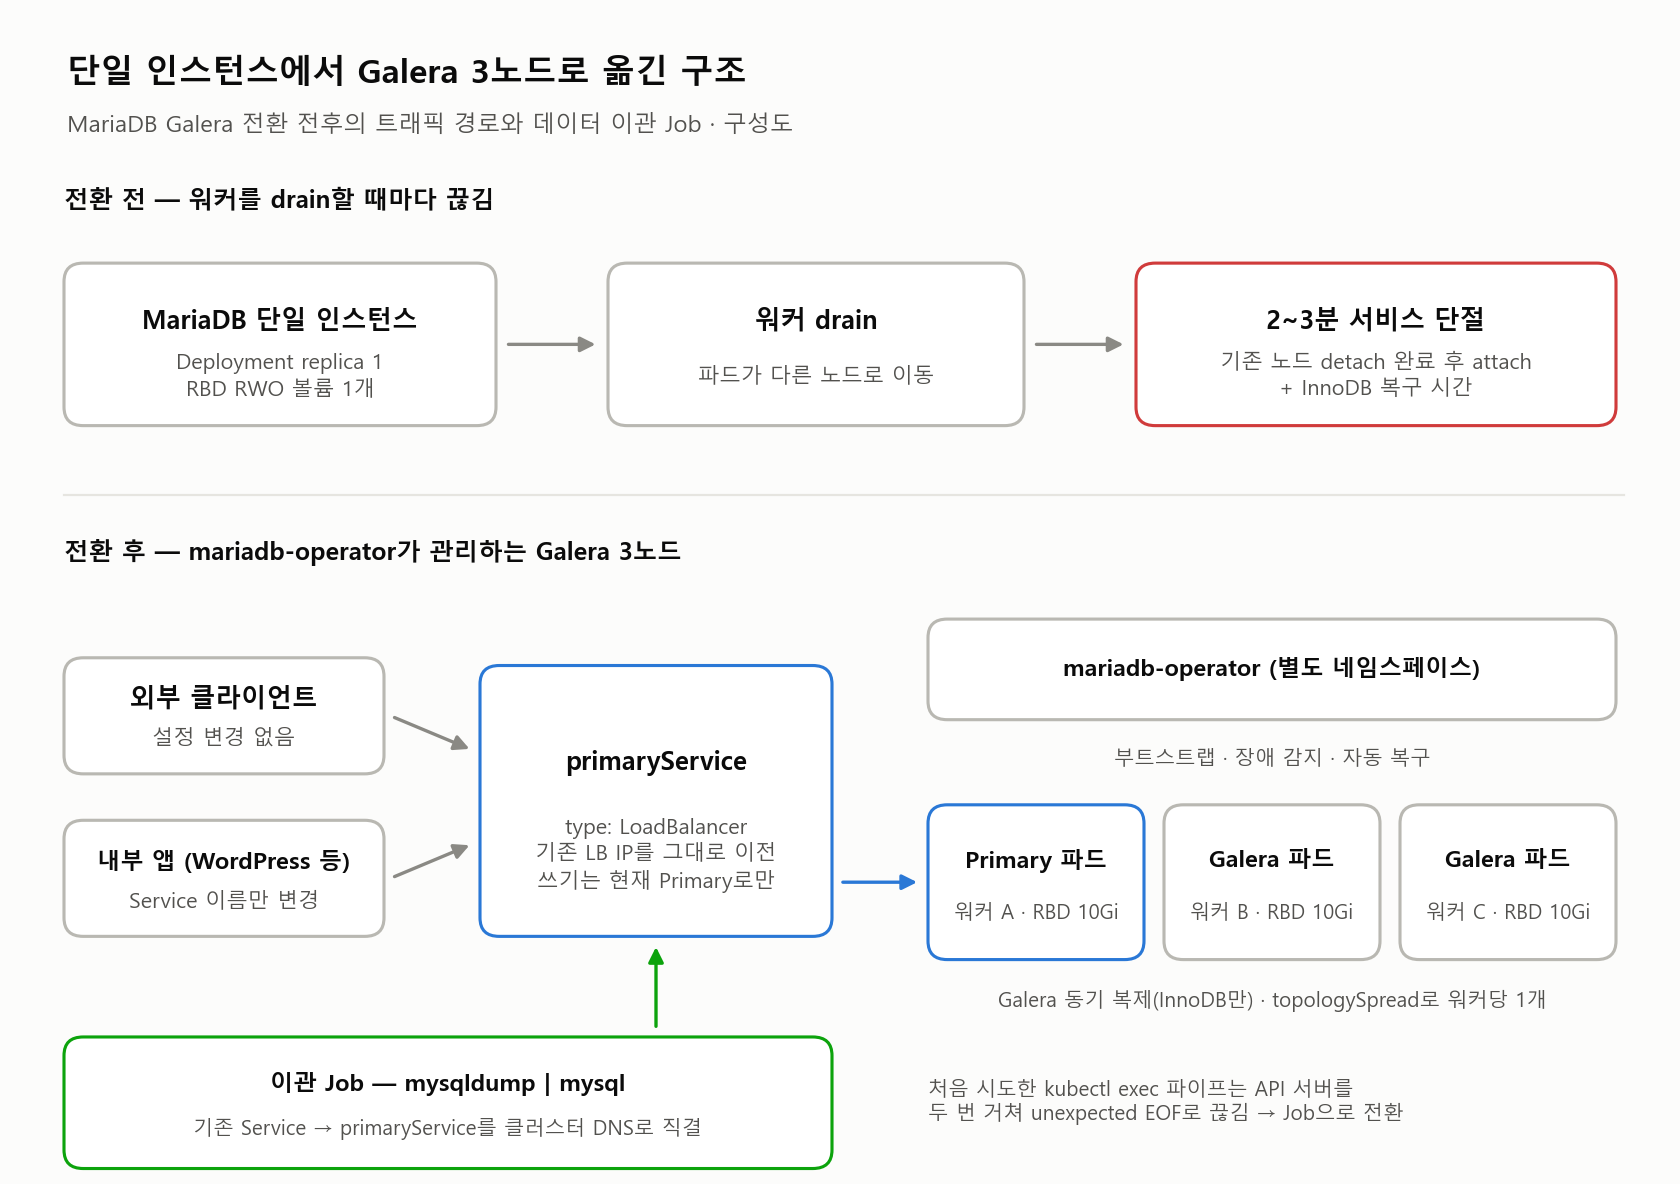
MariaDB Galera 전환 작업을 진행했습니다. 그동안 단일 인스턴스(단일 replica + ReadWriteOnce 볼륨) 구조로 MariaDB를 운영해왔는데, Kubernetes 클러스터 업그레이드 도중 MariaDB가 떠 있는 워커 노드를 drain할 때마다 2~3분 정도 서비스가 끊기는 문제가 반복됐습니다. 단일 replica + RWO 볼륨 조합에서는 drain 시 기존 노드에서 볼륨이 detach되고 새 노드에 attach되는 동안의 지연을 구조적으로 피할 수 없었습니다.

업데이트(2026-11-05): 이 글의 Galera 구성은 지금 운영하지 않습니다.

2026년 9월 19일과 10월 10일 두 차례, 워커 노드 하나가 응답을 멈추는 장애가 있었습니다. Ceph mon과 OSD가 그 노드에서 함께 빠지면서 RBD I/O가 끊겼고, 데이터베이스도 같이 멈췄습니다. MariaDB operator의 자동 복구는 매번 교착되어 피해를 키웠습니다.

Galera는 이 규모에서 성능상 이점도 없었습니다. 쓰기는 certification 왕복 때문에 느려졌고, 읽기는 primary 엔드포인트 하나로만 들어와 분산 효과가 없었습니다.

2026년 10월 11일, 데이터베이스는 Kubernetes 밖 전용 VM의 단일 MariaDB로 옮겼습니다. 9월 장애의 추적 과정은 9초 노드 순단 분석에 정리했습니다. 10월 장애의 원인과 조치는 Ceph OSD 메모리 고갈 분석에 정리했습니다. Galera 전환 당시의 기록은 아래와 같습니다.

이 글에서는 이 문제를 해결하기 위해 mariadb-operator 기반 3노드 Galera 클러스터로 전환한 전체 과정 — 사전 조사, 클러스터 구성, 데이터 마이그레이션, 최종 트래픽 전환(cutover), 그리고 그 과정에서 만난 트러블슈팅을 정리합니다.

환경

  • Kubernetes 클러스터 (Control-plane 3대, Worker 3대)
  • Storage: Rook-Ceph RBD (StorageClass, ReadWriteOnce)
  • 기존: MariaDB 10.11 단일 인스턴스(Deployment, replica 1)
  • 전환 후: MariaDB 10.11 Galera 3노드 (mariadb-operator 관리, StatefulSet)
  • 데이터 규모: 2개 DB, 총 143개 테이블, 약 2.3GB

사전 조사부터 컷오버까지 MariaDB Galera 전환 과정

1. 전환 배경 조사

워커 drain 시 실제 단절 시간을 측정해보니, MariaDB가 떠 있는 노드를 drain할 때마다 매번 2~3분씩 서비스가 끊기는 것으로 확인됐습니다. 원인은 단일 replica라 drain되는 순간 파드가 다른 노드로 옮겨가야 하는데, RWO(ReadWriteOnce) 블록 볼륨이라 기존 노드에서 detach가 완료되어야 새 노드에서 attach가 시작되기 때문이었습니다. 이 대기 시간에 InnoDB 복구 시간까지 더해지면서 단절이 발생했습니다.

해결 방법을 두 갈래로 검토했습니다.

  • A안 — cordon-only 절차: drain 대신 cordon만 하고 kubelet을 재기동하는 방식. 컨테이너 런타임이 kubelet 재기동으로 기존 컨테이너를 죽이지 않는다는 점을 이용해, 계획된 업그레이드에 한해서는 단절을 0초로 만들 수 있음. 다만 노드 장애 등 예기치 못한 상황에는 도움이 안 됨
  • B안 — Galera 3노드 전환: 계획된 업그레이드는 물론 노드 장애 시에도 무중단이 되는 진짜 HA 구조

적합성을 미리 조사해보니, 전체 테이블이 InnoDB로 전환 가능했고(예외 1개, 아래에서 다룸), 쓰기 부하도 초당 1~2건 수준으로 매우 낮아 Galera의 동기 복제 오버헤드가 문제 될 수준이 아니었습니다. 워커 노드들의 메모리 여유도 충분해 3노드 확장에 무리가 없다고 판단해 B안으로 진행했습니다.

2. mariadb-operator 설치

OSS mariadb-operator는 Galera 클러스터의 부트스트랩·장애 감지·자동 복구를 대신 처리해주고, 무엇보다 현재 Primary 파드로만 트래픽을 라우팅하는 Service(primaryService)를 자체 제공합니다. Galera는 원래 멀티 마스터 구조라 여러 파드로 쓰기가 분산되면 오히려 인증(certification) 충돌 위험이 있는데, 이 기능 덕분에 별도의 쓰기 라우팅 설계나 MaxScale 도입 없이 “쓰기는 항상 Primary로” 요구사항을 해결할 수 있었습니다.

helm install mariadb-operator-crds oci://ghcr.io/mariadb-operator/charts/mariadb-operator-crds --version 26.6.0 -n mariadb-operator --create-namespace
helm install mariadb-operator oci://ghcr.io/mariadb-operator/charts/mariadb-operator --version 26.6.0 -n mariadb-operator

operator는 DB 워크로드와 별도 네임스페이스에 설치했습니다. 이미 이 클러스터에서 Ingress 컨트롤러, LoadBalancer 컨트롤러 등을 “컨트롤러는 자기 네임스페이스, 워크로드는 자기 네임스페이스”로 분리해온 컨벤션과 동일하며, operator를 재설치/업그레이드할 때 워크로드에 영향을 줄 위험을 줄여줍니다.

3. Galera 클러스터 구성 설계

CRD로 3노드 Galera 클러스터를 선언했습니다. 실제 사용량(메모리 약 1.4Gi)과 여유분을 고려해 request/limit을 산정했고, 워커 3대 = replica 3개인 구조라 topologySpreadConstraints로 반드시 노드당 1개씩 배치되도록 강제했습니다(그래야 노드 장애 내성이 실제로 성립합니다).

apiVersion: k8s.mariadb.com/v1alpha1
kind: MariaDB
metadata:
  name: mariadb-galera
spec:
  image: mariadb:10.11
  replicas: 3
  galera:
    enabled: true
    sst: mariabackup
  storage:
    size: 10Gi
    storageClassName: rook-ceph-block
  resources:
    requests: { cpu: 250m, memory: 1Gi }
    limits: { cpu: "1", memory: 2Gi }
  primaryService:
    type: LoadBalancer
  topologySpreadConstraints:
    - maxSkew: 1
      topologyKey: kubernetes.io/hostname
      whenUnsatisfiable: DoNotSchedule
      labelSelector:
        matchLabels:
          app.kubernetes.io/instance: mariadb-galera

4. 데이터 이관 준비

Galera는 InnoDB 테이블만 복제합니다. 143개 테이블을 점검해 보니 보안 플러그인이 쓰는 캐시 테이블 1개만 MEMORY 엔진이었고, 그마저도 항상 비어 있어 InnoDB로 바로 전환했습니다.

계정/권한 이관은 평문 비밀번호를 몰라도 되는 방법을 썼습니다. SHOW GRANTS FOR 'user'@'%'로 확인되는 IDENTIFIED BY PASSWORD '*HASH' 값을 그대로 새 클러스터에 CREATE USER ... IDENTIFIED BY PASSWORD '*HASH'로 재생성한 것입니다. 외부 애플리케이션이 쓰는 계정처럼 평문 비밀번호를 알 수 없는 계정도 문제없이 동일하게 이관할 수 있었습니다.

5. 데이터 마이그레이션

논리 덤프(mysqldump)로 실제 데이터를 옮겼습니다. 이 과정에서 스트림이 끊기는 문제가 한 번 있었는데, 아래 exec 스트림 단절 항목에서 자세히 다룹니다. Job을 클러스터 안에서 일회성으로 실행해 소스와 타겟 DB를 직접 연결하는 방식으로 최종 이관을 안정적으로 마쳤습니다.

6. 최종 컷오버

실제 트래픽 전환 직전에는, 쓰기 중인 애플리케이션을 짧게 멈추고 최종 재동기화를 한 번 더 돌려 모든 테이블에서 정확히 0건 차이임을 확인한 뒤 진행했습니다. 외부에서 접속하는 클라이언트가 있었기 때문에, 기존에 쓰던 LoadBalancer IP를 그대로 새 클러스터의 primaryService로 이전해서 그 클라이언트 쪽 설정은 전혀 바꿀 필요가 없도록 했습니다. 클러스터 내부에서 DNS 이름으로 접속하던 애플리케이션(WordPress 등)만 새 Service 이름으로 연결 문자열을 바꿔주면 됐습니다.

MariaDB Galera 전환 전후를 비교한 구성도로, drain 때마다 끊기던 단일 인스턴스와 mariadb-operator가 관리하는 Galera 3노드, primaryService, 이관 Job 경로를 보여 줍니다.
MariaDB Galera 전환 뒤에는 primaryService가 기존 LB IP를 이어받아 외부 클라이언트 설정을 바꾸지 않았습니다.

설정 볼륨 Pending과 exec 스트림 단절

Galera 설정 볼륨이 StorageClass 미지정으로 Pending

현상: 클러스터를 처음 생성했을 때 3개 파드 모두 Pending 상태로 멈췄습니다. 이벤트를 보니 pod has unbound immediate PersistentVolumeClaims, PVC 쪽에는 no persistent volumes available for this claim and no storage class is set 에러가 나 있었습니다.

원인: 데이터 볼륨 외에 Galera 설정 파일 전용 PVC가 하나 더 자동으로 생성됩니다. PVC 템플릿에 StorageClass가 지정되지 않았고, 클러스터에도 기본(default) StorageClass가 없어 바인딩될 곳이 없었습니다.

해결: 설정 파일용 볼륨을 따로 만들지 않고 데이터 볼륨을 재사용하도록 옵션을 켰습니다. 다만 이 옵션은 리소스 생성 후에는 변경 불가능한(immutable) 필드라, 처음부터 이 옵션을 켠 상태로 리소스를 삭제 후 재생성해야 했습니다.

  galera:
    enabled: true
    config:
      reuseStorageVolume: true   # 생성 후 변경 불가 - 처음부터 켜야 함

대용량 마이그레이션 중 kubectl exec 스트림 단절

현상: 소스 파드에서 mysqldump를 실행해 그 표준출력을 타겟 파드의 mysql 클라이언트로 바로 파이프 연결하는 방식으로 마이그레이션을 시도했는데, 수백만 줄이 넘어간 시점에 unexpected EOF로 스트림이 끊겼습니다. 타겟 쪽에서는 끊긴 지점의 잘린 SQL 구문 때문에 문법 오류가 발생했습니다.

원인: 두 파드를 각각 별도의 exec 세션으로 열고, 로컬 셸의 파이프로 이어 붙인 방식이었습니다. API 서버를 데이터가 두 번 거치는 이중 스트리밍 구조라, 데이터량이 크고 전송 시간이 길수록 이 경로가 끊길 가능성이 커집니다.

해결: 클러스터 내부에서 직접 실행되는 일회성 Job으로 전환했습니다. Job 안에서 소스/타겟 Service의 DNS 이름으로 직접 연결해 mysqldump | mysql을 실행하니, API 서버를 거치지 않고 클러스터 네트워크 안에서 바로 전송되어 안정적으로 완료됐습니다.

apiVersion: batch/v1
kind: Job
metadata:
  name: mariadb-galera-migrate
spec:
  backoffLimit: 0
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: migrate
          image: mariadb:10.11
          command: ["sh", "-c"]
          args:
            - |
              mysqldump -h <source-service> -uroot -p"$SRC_PW" \
                --databases db1 db2 --single-transaction --routines --triggers --events \
              | mysql -h <target-primary-service> -uroot -p"$DST_PW"

0건 차이 검증과 4일 이상 무단절 운영

전환 후 다음 항목들을 확인했습니다.

  • 마이그레이션 후 모든 테이블에서 정확히 0건 차이 검증 완료
  • 4일 이상 무재시작·무단절 운영 확인 (Galera 3노드 전부 Synced)
  • 기존 인스턴스는 행 수가 더 이상 늘지 않음(트래픽 완전히 이전) vs 신규 클러스터는 계속 증가 — 컷오버가 실제로 적용됐음을 재확인
  • 관찰 기간 이후 기존 단일 인스턴스는 설정을 문서로 백업한 뒤 정리(삭제)

단일 인스턴스 대비 이번 MariaDB Galera 전환 덕분에 계획된 업그레이드는 물론 예기치 못한 노드 장애 상황에서도 서비스 단절 없이 운영할 수 있는 구조를 갖췄다고 판단했습니다. 2026년 11월에 덧붙인 글머리의 업데이트에 이후 실제 운영 결과를 적었습니다.

참고

관련 포스트:

참고 문서: mariadb-operator (GitHub) · Galera Cluster Documentation

Migrating WordPress from a Standalone LAMP Server to Kubernetes with Traefik

CentOS 7 단일 서버를 떠나며 세운 네 가지 목표

레거시 CentOS 7 + Apache + PHP 7.4 단일 서버에서 운영하던 사이트를 자체 관리형 클러스터로 옮긴 WordPress Kubernetes 마이그레이션 기록입니다. 대상 서버는 두 개 도메인을 서빙하고 있었고, DB는 이미 클러스터 내 MariaDB를 외부 LoadBalancer IP로 접속하고 있어 데이터베이스 자체는 새로 구축할 필요 없이 접속 경로만 전환하면 되는 상태였습니다.

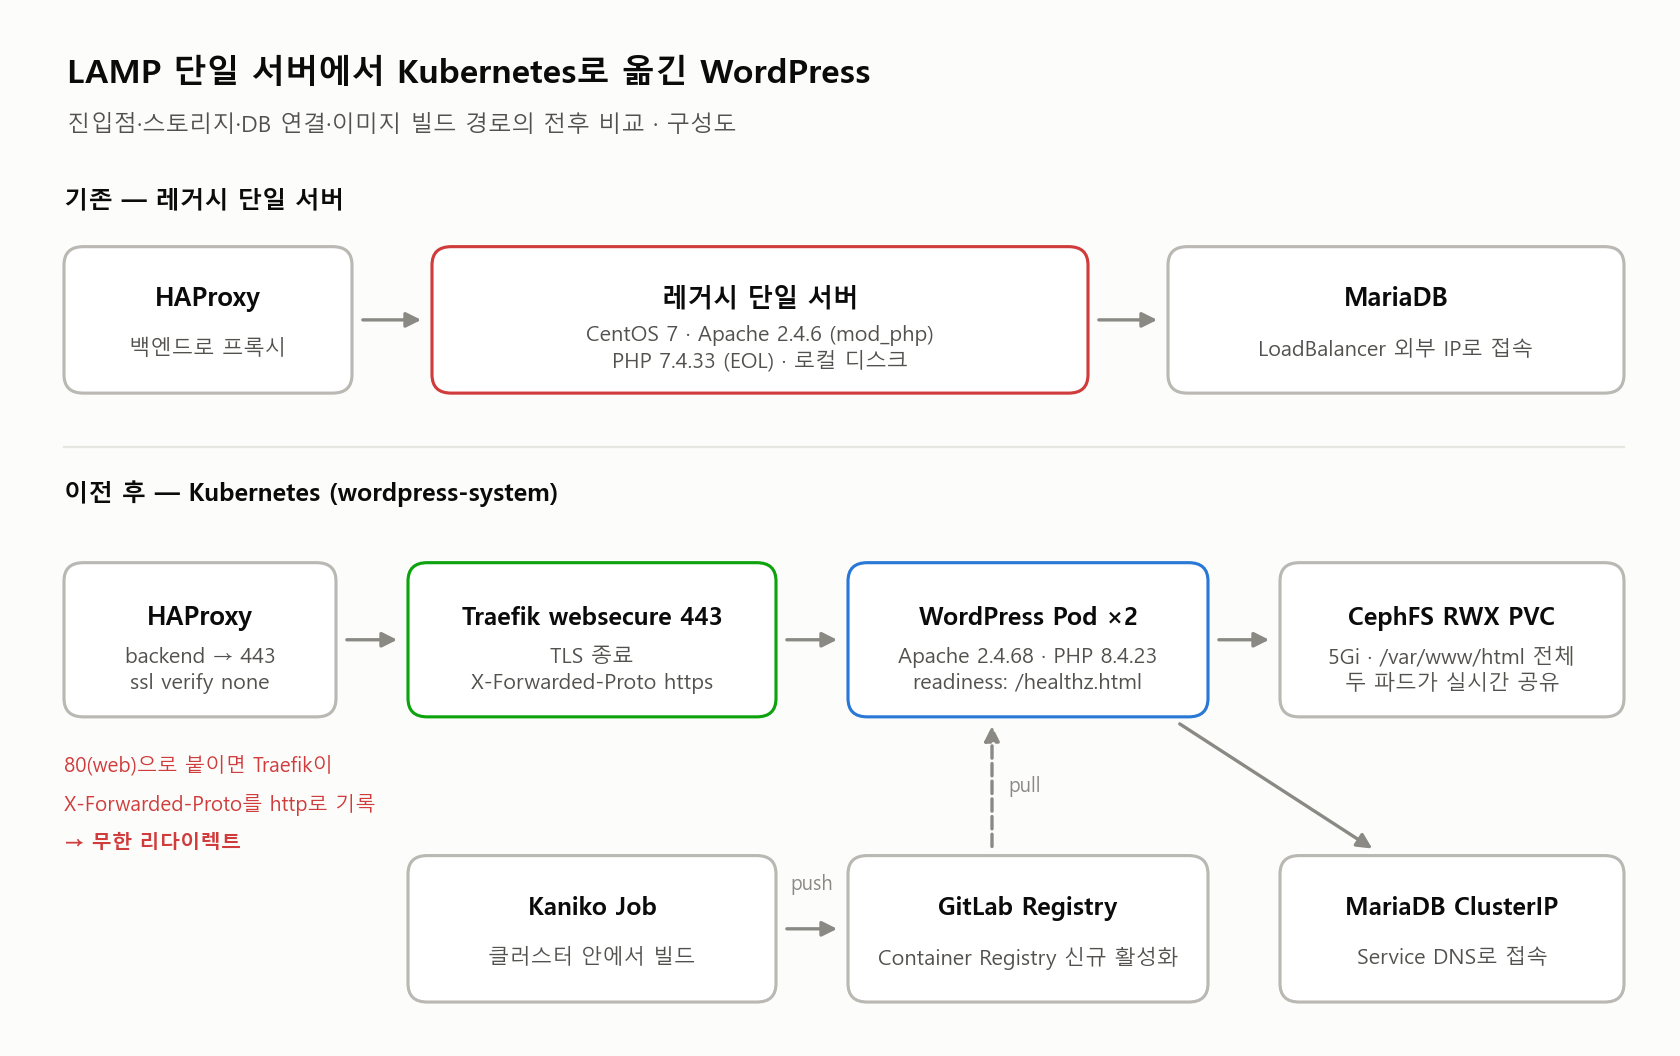
이번 작업에서는 ① 진입점을 Traefik Ingress로 전환 ② MariaDB 접속을 ClusterIP로 전환 ③ 다중 파드 확장을 고려해 Rook CephFS(ReadWriteMany) 볼륨 채택 ④ PHP 7.4(EOL)에서 PHP 8.4로 업그레이드, 이 네 가지를 목표로 설계했습니다. 로컬 환경에 docker/podman이 없어 커스텀 이미지를 클러스터 안에서 직접 빌드해야 했고, 그 과정에서 GitLab Container Registry를 신규로 활성화하는 작업도 함께 진행했습니다.

WordPress Kubernetes 마이그레이션 구성도로, CentOS 7 레거시 단일 서버 구성과 HAProxy에서 Traefik websecure 443, WordPress 파드 2개, CephFS RWX PVC, MariaDB ClusterIP로 이어지고 Kaniko와 GitLab Registry가 이미지를 공급하는 이전 후 구성을 비교합니다.
진입점은 Traefik 443으로, webroot는 CephFS RWX 볼륨으로, 이미지는 클러스터 안 Kaniko 빌드로 바뀐 전후 구성입니다.

환경

항목 기존 (192.168.x.x 레거시 서버) 신규 (Kubernetes)
OS / 웹서버 / PHP CentOS 7, Apache 2.4.6 (mod_php, mpm_prefork), PHP 7.4.33 Debian(컨테이너), Apache 2.4.68, PHP 8.4.23
진입점 HAProxy가 TLS 종료 후 백엔드로 프록시 Traefik Ingress (websecure 443)
DB 연결 MariaDB LoadBalancer 외부 IP MariaDB ClusterIP (Service DNS)
스토리지 로컬 디스크 단일 서버 Rook CephFS RWX PVC 5Gi, 파드 2개 공유
메일 발송 로컬 Postfix (direct-send) 이미지 내 Postfix 동일 구성
이미지 – GitLab Container Registry + Kaniko 빌드

WordPress Kubernetes 마이그레이션 설계와 이관

1. 소스 서버 조사 및 이관 설계

SSH로 레거시 서버에 직접 접속해 vhost 설정, wp-config.php, 활성 플러그인 목록, PHP 설정을 조사했습니다. DB 접속 정보(DB_HOST)가 이미 클러스터 내 MariaDB LoadBalancer 외부 IP로 되어 있다는 점을 확인했고, HAProxy IP 하나만 신뢰하도록 되어 있던 mod_rpaf 설정은 새 토폴로지에서는 의미가 없어 mod_remoteip + Pod 네트워크 대역으로 대체가 필요하다는 점도 함께 확인했습니다.

2. 스토리지 설계: webroot 전체를 RWX PVC로

WordPress는 FS_METHOD=direct로 동작해 .htaccess나 플러그인/코어 업데이트를 파일시스템에 직접 씁니다. 다중 파드 환경에서 모든 레플리카가 일관된 상태를 보게 하려면 wp-content만이 아니라 /var/www/html 전체를 공유 볼륨에 올려야 한다고 판단했습니다.

apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: wordpress-webroot
spec:
  accessModes: [ReadWriteMany]
  storageClassName: rook-cephfs
  resources:
    requests:
      storage: 5Gi

wp-config.php는 이 PVC 밖에 두었습니다. DB 접속 정보 등 비밀이 아닌 값은 ConfigMap으로, DB 비밀번호와 AUTH/SALT 키는 Secret으로 분리해 두 파일을 각각 subPath로 마운트하고, 본체 wp-config.php가 require_once로 Secret 쪽 파일을 불러오는 구조로 구성했습니다.

3. 커스텀 이미지 빌드: GitLab Container Registry + Kaniko

로컬 작업 환경에 docker/podman이 없었고, 클러스터도 이전까지 공개 이미지만 사용해 온 상태라 커스텀 이미지를 빌드할 경로가 필요했습니다. GitLab Container Registry가 비활성 상태였어서 이번에 신규로 활성화했습니다.

FROM wordpress:php8.4-apache

# 원본에 없던 zip 확장 추가
RUN apt-get update && apt-get install -y libzip-dev && docker-php-ext-install zip

# 원본과 동일한 Postfix(direct-send) 구성
RUN echo "postfix postfix/main_mailer_type select Internet Site" | debconf-set-selections && \
    DEBIAN_FRONTEND=noninteractive apt-get install -y postfix

# mod_rpaf 대체
RUN a2enmod remoteip headers rewrite expires
COPY security-headers.conf remoteip.conf /etc/apache2/conf-enabled/
CMD ["/usr/local/bin/start.sh"]

이미지는 로컬 빌드 없이 Kaniko Job으로 클러스터 안에서 빌드하고 바로 Registry에 푸시했습니다.

containers:
  - name: kaniko
    image: gcr.io/kaniko-project/executor:v1.23.2
    args:
      - --dockerfile=/workspace/Dockerfile
      - --context=dir:///workspace/
      - --destination=gitlab.sierracloud.dev:5050/infra/k8s-ops/wordpress:php8.4-2

4. 데이터 이관

PVC를 마운트하는 임시 헬퍼 파드를 띄우고 rsync로 레거시 서버의 /var/www/html을 통째로 옮겼습니다. 총 297MB, 13,822개 파일이었고 컷오버 직전에 증분 동기화를 한 번 더 실행해 다운타임을 최소화했습니다. 미사용 상태로 남아있던 두 번째 WordPress 설치본(운영 DB를 그대로 바라보지만 어떤 vhost에서도 서빙되지 않던 orphan 설치)은 이관 대상에서 제외했습니다.

rsync -az --exclude='wp-config.php' \
  -e 'ssh -i <migration-key>' \
  root@192.168.x.x:/var/www/html/ /mnt/webroot/

레지스트리·빌드·리버스 프록시에서 막힌 네 지점

GitLab Container Registry 활성화 중 nginx 전체 다운

현상: gitlab.rb에 registry_external_url을 추가하고 gitlab-ctl reconfigure를 실행하자 nginx가 기동에 실패했고, Registry뿐 아니라 GitLab 웹 UI 전체가 접속 불가 상태가 되었습니다.

원인: registry_nginx가 메인 사이트에 적용해 둔 커스텀 인증서 경로를 상속받지 않고, 존재하지 않는 기본 경로(/etc/gitlab/ssl/<fqdn>.crt)를 찾다가 nginx 설정 검증 자체가 실패했습니다.

해결: registry_nginx['ssl_certificate']/['ssl_certificate_key']를 메인 사이트와 동일한 인증서 경로로 명시적으로 지정한 뒤 재실행해 즉시 복구했습니다.

registry_external_url 'https://gitlab.sierracloud.dev:5050'
gitlab_rails['registry_enabled'] = true
registry_nginx['ssl_certificate'] = "/data/cert/sierracloud.dev/fullchain.pem"
registry_nginx['ssl_certificate_key'] = "/data/cert/sierracloud.dev/privkey.pem"

Kaniko 빌드 컨텍스트의 dangling symlink

현상: Dockerfile과 부속 설정 파일을 ConfigMap으로 만들어 Kaniko 빌드 컨텍스트로 바로 마운트했더니, COPY 단계에서 cannot operate on dangling symlink 에러로 빌드가 실패했습니다.

원인: Kubernetes ConfigMap 볼륨은 각 파일을 실제 파일이 아니라 ..data/<file>을 가리키는 심볼릭 링크로 마운트합니다. Kaniko의 COPY가 이 링크를 그대로 이미지에 복사하면서, 이미지 안에서는 가리키는 대상이 없는 깨진 링크가 되어버렸습니다.

해결: initContainer에서 cp -rL로 심볼릭 링크를 실제 파일 내용으로 역참조 복사한 emptyDir을 만들고, 이 디렉터리를 Kaniko의 빌드 컨텍스트로 사용하도록 변경했습니다.

initContainers:
  - name: prepare-context
    image: busybox:1.36
    command: ["sh", "-c", "cp -rL /configmap-src/. /workspace/"]

Really Simple Security가 리버스 프록시 뒤에서 무한 리다이렉트를 일으킴

현상: .htaccess의 HTTPS 강제 리다이렉트 규칙이 RewriteCond %{HTTPS} !=on 조건을 쓰고 있었는데, 이관 후에는 모든 요청이 계속 리다이렉트되어 파드가 readiness probe를 통과하지 못하고 CrashLoopBackOff 상태에 빠졌습니다.

원인: 원본 서버는 Apache가 직접 TLS를 종료했기 때문에 %{HTTPS}가 정확했지만, 이관 후에는 Traefik이 TLS를 종료하고 WordPress 컨테이너에는 평문 HTTP로 전달되어 %{HTTPS}가 항상 off로 평가되었습니다.

해결: 플러그인 소스를 직접 확인해, 리버스 프록시/로드밸런서 뒤에서 지원하는 방식인 RewriteCond %{HTTP:X-Forwarded-Proto} !https로 교체했습니다. wp-config.php에도 HTTP_X_FORWARDED_PROTO를 확인해 $_SERVER['HTTPS']를 보정하는 코드를 추가해 PHP 레벨의 is_ssl() 판단도 함께 맞췄습니다. 프로브 자체는 이 로직과 무관한 정적 파일(/healthz.html)로 분리해 안정성을 확보했습니다.

RewriteCond %{HTTP_USER_AGENT} !lscache_runner [NC]
RewriteCond %{HTTP:X-Forwarded-Proto} !https
RewriteCond %{REQUEST_URI} !^/healthz\.html$
RewriteRule ^(.*)$ https://%{HTTP_HOST}/$1 [R=301,L]

Traefik이 평문 HTTP 구간에서는 X-Forwarded-Proto를 신뢰하지 않음

현상: 위 수정 이후에도, HAProxy가 Traefik의 80(web) 엔트리포인트로 붙는 기존 패턴(다른 내부 서비스들과 동일한 구성)으로 연결하면 여전히 무한 리다이렉트가 재현되었습니다.

원인: Traefik은 보안상 클라이언트가 보낸 X-Forwarded-Proto 값을 그대로 신뢰하지 않고, 자신이 실제로 수신한 연결이 TLS인지 여부로 직접 값을 판단해 덮어씁니다. HAProxy와 Traefik 사이 구간이 평문 HTTP(80)이면 Traefik은 이 값을 항상 http로 기록합니다.

해결: HAProxy의 backend를 Traefik의 443(websecure) 엔트리포인트로 변경했습니다(ssl verify none). Traefik이 이 연결에서 직접 TLS를 종료하므로 X-Forwarded-Proto가 정확히 https로 설정됩니다. 마침 traefik 네임스페이스에 이미 로드되어 있던 *.sierracloud.dev 와일드카드 인증서가 Traefik의 기본 인증서로 쓰이고 있어서, 별도 인증서 작업 없이 그대로 유효한 인증서를 응답받을 수 있었습니다.

두 파드의 RWX 볼륨 공유와 접근 경로 검증

WordPress Kubernetes 마이그레이션 이후의 최종 상태를 다음과 같이 확인했습니다.

$ kubectl get pods -n wordpress-system -l app=wordpress
NAME                         READY   STATUS    RESTARTS   AGE
wordpress-xxxxxxxxxx-xxxxx   1/1     Running   0          91m
wordpress-xxxxxxxxxx-yyyyy   1/1     Running   0          91m

두 파드가 동일 PVC(RWX)를 실시간으로 공유하는지도 직접 검증했습니다. 한 파드에서 파일을 쓰고 다른 파드에서 즉시 동일한 내용을 읽어, 별도 볼륨이 아니라 완전히 같은 볼륨임을 확인했습니다.

  • 내부망 DNS(도메인 → Traefik IP 직접) 경로로 로그인 페이지, REST API, 실제 게시글 permalink까지 정상 응답 확인
  • 외부에서는 CDN을 경유해 HAProxy → Traefik → 파드로 이어지는 경로로 동일하게 정상 렌더링 확인
  • HAProxy IP로 CDN을 거치지 않고 직접 접근하면 403이 반환되는 것도 확인 — origin을 직접 노출하지 않도록 걸어둔 기존 접근 제어가 그대로 유지되고 있다는 뜻이라 정상 동작으로 판단했습니다

참고

관련 포스트:

참고 문서: Traefik — EntryPoints Forwarded Headers · Kaniko (GoogleContainerTools) · GitLab Container Registry Administration

Kubernetes MariaDB Resource Limits and Health Probes

request/limit과 probe 없이 2년 넘게 운영된 MariaDB

MariaDB 리소스 제한 설정과 헬스체크(liveness/readiness probe) 구성을 자체 관리형 Kubernetes 클러스터에 반영했습니다. 기존 MariaDB Deployment는 리소스 request/limit이 전혀 설정되지 않은 상태(resources: {})로 2년 넘게 운영되고 있었고, liveness/readiness probe도 없어 mysqld 프로세스가 응답 없이 멈추더라도 Kubernetes가 이를 감지하고 자동으로 재시작할 방법이 없는 구조였습니다.

이번 글에서는 ① 현재 구성 점검 ② 운영 중인 리소스의 YAML 추출 및 Git 반영 ③ 리소스 제한/프로브 설계와 적용, 이렇게 세 가지 작업을 순서대로 정리합니다.

환경

  • Kubernetes v1.33.7 (Control-plane 3대, Worker 3대 HA 구성)
  • Container Runtime: Docker + cri-dockerd
  • Storage: Rook-Ceph RBD (StorageClass rook-ceph-block, ReadWriteOnce)
  • MariaDB: 10.11, mariadb-system 네임스페이스, Deployment 단일 replica
  • PVC: 10Gi, PV ReclaimPolicy: Retain
  • 서비스 노출: MetalLB LoadBalancer (내부망 전용)

형상 점검부터 Recreate 롤아웃까지

1. 현재 구성 형상 점검

먼저 운영 중인 Deployment, PVC, Service, ConfigMap 현황과 실제 리소스 사용량을 확인했습니다.

$ kubectl get all -n mariadb-system -o wide
$ kubectl get pvc -n mariadb-system -o wide
$ kubectl top pod -n mariadb-system

점검 결과 Deployment의 strategy는 이미 Recreate로 설정되어 있었습니다. MariaDB처럼 ReadWriteOnce 볼륨을 사용하는 단일 파드 워크로드는 RollingUpdate 방식으로 배포하면 이전 파드가 볼륨을 반납하기 전에 새 파드가 같은 볼륨을 마운트하려다 충돌하는 경우가 있어, Recreate 전략이 올바른 선택이었습니다. PV의 reclaimPolicy도 Retain으로 설정되어 있어 PVC가 실수로 삭제되더라도 실제 데이터는 보존되는 안전한 구조였습니다.

반면 컨테이너 리소스는 request/limit이 전혀 없는 상태였고, 실제 메모리 사용량은 약 1.4Gi 수준이었습니다. ConfigMap으로 주입한 커스텀 설정은 다음과 같았습니다.

[mysqld]
innodb_buffer_pool_size=512M
innodb_log_file_size=256M
max_connections=300

2. YAML 추출 및 Git 반영

운영 중인 리소스(PVC, ConfigMap, Deployment, Service)를 그대로 추출해 저장소에 매니페스트 파일로 문서화했습니다. Secret은 정책상 Git에 포함하지 않고, 클러스터 재구성 시 수동으로 생성할 수 있도록 커맨드만 주석으로 남겼습니다.

# root 비밀번호(mariadb-secret)는 Git에 없음 - 클러스터 재구성 시 수동 생성 필요
#   kubectl create secret generic mariadb-secret -n mariadb-system \
#     --from-literal=password='<ROOT_PASSWORD>'

추출한 매니페스트를 kubectl diff로 실제 클러스터 상태와 비교해, 새로 작성한 YAML이 운영 중인 리소스와 완전히 동일한지 먼저 확인했습니다. 차이가 없다는 것을 확인한 뒤에야 Git에 커밋했습니다.

3. 리소스 Request/Limit 및 Probe 설계

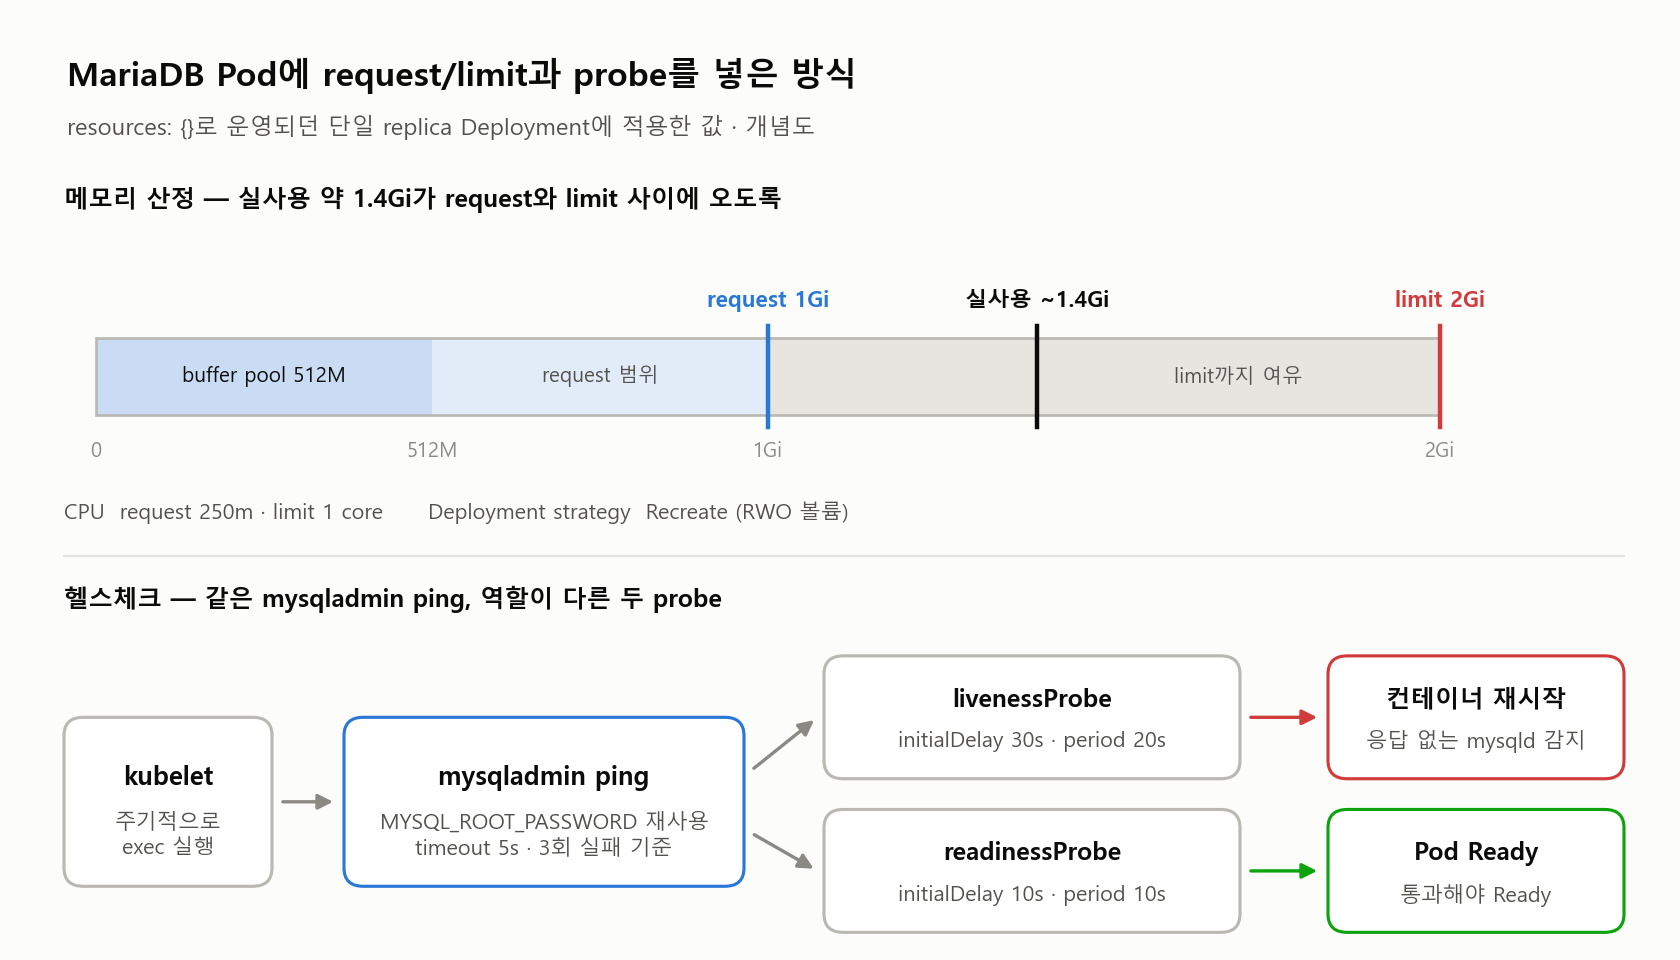
실제 메모리 사용량(~1.4Gi)과 innodb_buffer_pool_size(512M) 설정, 그리고 노드의 여유 용량을 함께 고려해 MariaDB 리소스 제한 값을 다음과 같이 산정했습니다.

resources:
  requests:
    cpu: 250m
    memory: 1Gi
  limits:
    cpu: "1"
    memory: 2Gi
livenessProbe:
  exec:
    command:
      - sh
      - -c
      - mysqladmin ping -uroot -p"$MYSQL_ROOT_PASSWORD" --silent
  initialDelaySeconds: 30
  periodSeconds: 20
  timeoutSeconds: 5
  failureThreshold: 3
readinessProbe:
  exec:
    command:
      - sh
      - -c
      - mysqladmin ping -uroot -p"$MYSQL_ROOT_PASSWORD" --silent
  initialDelaySeconds: 10
  periodSeconds: 10
  timeoutSeconds: 5
  failureThreshold: 3

Probe는 이미 컨테이너 환경변수로 주입되어 있던 MYSQL_ROOT_PASSWORD를 그대로 활용하는 mysqladmin ping exec 방식을 선택했습니다. 별도 Secret을 추가로 마운트할 필요 없이, 실제로 mysqld가 인증까지 정상 처리하는지 확인할 수 있는 방식입니다. Limit 산정 시에는 노드 전체 할당량 대비 여유가 충분한지(CPU 할당 비율, 메모리 할당 비율) 함께 확인한 뒤 값을 확정했습니다.

MariaDB 리소스 제한 개념도로, 실사용 약 1.4Gi 메모리가 request 1Gi와 limit 2Gi 사이에 놓이도록 정한 값과 mysqladmin ping을 쓰는 liveness·readiness probe의 역할을 보여 줍니다.
실사용 메모리와 buffer pool 크기를 기준으로 잡은 request/limit 범위, 그리고 같은 ping을 쓰는 두 probe의 역할입니다.

4. 적용 및 롤아웃 검증

kubectl apply 전에 반드시 kubectl diff로 변경 범위를 먼저 확인했습니다. Deployment의 strategy가 Recreate이기 때문에 적용 시 기존 파드가 먼저 종료되고 새 파드가 그 자리에 생성되는, 짧은 다운타임이 있는 변경이라는 점을 미리 인지하고 진행했습니다.

$ kubectl diff -f manifests/mariadb/mariadb.yaml
$ kubectl apply -f manifests/mariadb/mariadb.yaml
deployment.apps/mariadb configured

$ kubectl rollout status deployment/mariadb -n mariadb-system --timeout=120s
Waiting for deployment "mariadb" rollout to finish: 0 of 1 updated replicas are available...
deployment "mariadb" successfully rolled out

$ kubectl get pods -n mariadb-system -l app=mariadb
NAME                       READY   STATUS    RESTARTS   AGE
mariadb-xxxxxxxxxx-xxxxx   1/1     Running   0          12s

새 파드가 정상적으로 Ready 상태가 되었고, readiness probe가 통과하는 것을 확인했습니다. 로그에도 mariadbd: ready for connections가 정상 출력되어 별다른 문제 없이 전환이 완료되었습니다.

재시작 로그에서 발견한 시스템 테이블 문제

mysql.event 테이블 정의 불일치

현상: 파드 재시작 로그에 Incorrect definition of table mysql.event 에러와 함께 Event Scheduler가 비활성화된다는 메시지가 출력되었습니다.

원인: 과거 MariaDB 마이너 버전 업그레이드 이후 mysql_upgrade를 실행하지 않아, 시스템 테이블(mysql.event)의 컬럼 정의가 현재 바이너리 버전이 기대하는 스키마와 어긋난 상태로 남아있었습니다.

해결: 현재 Event Scheduler(예약 이벤트) 기능을 사용하고 있지 않아 서비스에는 영향이 없는 것으로 확인해, 이번 작업 범위에서는 별도 조치 없이 별도 후속 작업으로 분리했습니다. Event Scheduler를 사용할 계획이라면 mysql_upgrade 실행이 선행되어야 합니다.

request 250m/1Gi, limit 1core/2Gi 적용 확인

최종적으로 다음 항목들을 확인해 이번 MariaDB 리소스 제한 및 헬스체크 반영 작업을 마무리했습니다.

$ kubectl get deployment mariadb -n mariadb-system \
  -o jsonpath='{.spec.template.spec.containers[0].resources}'
{"limits":{"cpu":"1","memory":"2Gi"},"requests":{"cpu":"250m","memory":"1Gi"}}

$ kubectl get pod -n mariadb-system -l app=mariadb
NAME                       READY   STATUS    RESTARTS   AGE
mariadb-xxxxxxxxxx-xxxxx   1/1     Running   0          2m
  • 리소스 request/limit 적용 완료 (request 250m/1Gi, limit 1core/2Gi)
  • liveness/readiness probe 정상 동작 확인
  • 클러스터 재기동 없이 무중단으로 서비스(LoadBalancer)가 재공지되어 애플리케이션 연결 영향 없음

참고

관련 포스트:

참고 문서: Kubernetes – Configure Liveness, Readiness and Startup Probes · Kubernetes – Resource Management for Pods and Containers

Kubernetes MariaDB Failover with Rook Ceph

Galera 없이 RWO PVC만으로 복구되는가

Kubernetes MariaDB Failover 검증은 단일 MariaDB Pod가 실행 중인 worker node에서 다른 node로 이동할 때, Rook Ceph RBD 볼륨을 다시 연결하고 데이터베이스 서비스를 복구할 수 있는지 확인한 과정입니다. 별도의 Galera cluster를 구성하지 않고 기존 Deployment와 ReadWriteOnce PVC가 제공하는 장애 복구 범위를 검증하였습니다.

이번 작업에서는 MariaDB 매니페스트와 runtime 설정을 비교하고, 시스템 테이블 업그레이드와 물리 백업을 수행하였습니다. 또한 LoadBalancer 접근 대역을 제한한 뒤 Pod 이동, PVC 재부착, SQL 실행과 서비스 복구 시간까지 단계별로 확인하였습니다.

검증 결과 clean failover에서는 MariaDB Pod가 다른 worker node에 배치되고 기존 데이터를 사용하여 정상적으로 기동하였습니다. 다만 갑작스러운 node 전원 장애는 Pod toleration과 volume fencing 시간이 추가되므로, 이번 결과는 계획된 유지보수 상황의 복구 기준으로 해석해야 합니다.

환경

구성 요소 검증 환경 역할
Kubernetes v1.33 계열, multi control-plane Pod 재스케줄 및 Service 제공
MariaDB 10.11 LTS, single replica Deployment 애플리케이션 데이터베이스
Rook Ceph RBD StorageClass, 10Gi RWO PVC node 간 영구 볼륨 재부착
MetalLB LoadBalancer Service, TCP 3306 클러스터 외부 내부망 연결

MariaDB에는 1Gi memory request와 2Gi limit를 지정하고 InnoDB buffer pool은 512MiB로 설정하였습니다. 점검 전 PVC 여유 공간과 Ceph cluster의 HEALTH_OK 상태를 확인하였습니다. 이 구성은 추가 database replica 없이 Ceph의 storage 내구성과 Kubernetes의 Pod 재스케줄 기능을 활용합니다.

Kubernetes MariaDB Failover 준비와 시험

1. 매니페스트와 운영 상태 확인

먼저 Git에 저장된 PVC, ConfigMap, Deployment, Service를 실제 cluster object와 비교하였습니다. Deployment는 RWO volume의 동시 attach를 피하기 위해 Recreate 전략을 사용하고 있었으며 PVC는 Bound 상태였습니다. Pod, node, Ceph 상태와 최근 event를 함께 확인하여 점검 전에 진행 중인 장애가 없는지도 검증하였습니다.

kubectl get nodes
kubectl get pods -n mariadb-system -o wide
kubectl get pvc mariadb-pv-claim -n mariadb-system -o wide
kubectl get cephcluster -n rook-ceph -o wide
kubectl diff -f manifests/mariadb/mariadb.yaml

Pod의 Running 상태만 확인하지 않고 MariaDB version, InnoDB 설정, 연결 수와 filesystem 사용량을 함께 점검하였습니다. SQL 검사로 시스템 테이블과 실제 적용 변수를 확인해야 매니페스트와 runtime 사이의 차이를 발견할 수 있습니다.

2. 업그레이드 전 물리 백업

시스템 테이블을 변경하기 전에 mariadb-backup으로 전체 data directory의 streaming physical backup을 생성하였습니다. backup stream은 클러스터 외부 경로에서 압축하고 완료 메시지, gzip 무결성, 파일 크기와 SHA-256 checksum을 확인하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" \
  mariadb-backup --backup --stream=xbstream --user=root' \
  | gzip -1 > /secure-backup/mariadb-pre-upgrade.xb.gz

gzip -t /secure-backup/mariadb-pre-upgrade.xb.gz
sha256sum /secure-backup/mariadb-pre-upgrade.xb.gz

Ceph replica는 disk와 OSD 장애에 대한 내구성을 제공하지만 잘못된 SQL이나 시스템 테이블 변경을 되돌리는 backup은 아닙니다. 따라서 storage 상태가 정상이더라도 database upgrade 전에는 독립적인 backup이 필요합니다.

3. MariaDB 시스템 테이블 업그레이드

점검 과정에서 MariaDB binary와 data directory의 시스템 테이블 형식이 일치하지 않는 문제를 확인하였습니다. mysql.user view와 mysql.event, mysql.proc, mysql.column_stats에서 column definition 오류가 발생하였습니다. 기존 upgrade marker로 인해 일반 검사가 완료 상태로 판단하였으므로 backup을 확인한 뒤 --force 옵션을 적용하였습니다.

kubectl exec -n mariadb-system deploy/mariadb -- sh -c \
  'MYSQL_PWD="$MARIADB_ROOT_PASSWORD" mariadb-upgrade -uroot --force'

업그레이드 후 문제 테이블을 다시 검사하여 모두 OK 상태인 것을 확인하였습니다. application schema의 table 개수는 이전과 동일하였으며 startup log에서도 기존 definition 오류가 재발하지 않았습니다.

4. LoadBalancer 접근 소스 제한

MariaDB LoadBalancer는 클러스터 외부의 내부망 애플리케이션 서버가 접속하기 위해 유지하였습니다. 모든 source를 허용하지 않도록 loadBalancerSourceRanges에 접근 가능한 CIDR만 지정하였습니다. 아래 문서용 CIDR은 적용 환경에서 허용할 내부 대역으로 변경해야 합니다.

spec:
  type: LoadBalancer
  loadBalancerSourceRanges:
    - 192.0.2.0/24
  ports:
    - name: mariadb
      port: 3306
      targetPort: 3306

적용 전 client dry-run과 server-side diff로 Service 이외의 resource가 변경되지 않는지 확인하였습니다. 적용 후에는 source range, LoadBalancer VIP, EndpointSlice와 cluster 내부 database 연결을 검증하였습니다. NodePort가 별도 경로로 노출될 수 있으므로 routed network가 있다면 node firewall과 상위 network ACL도 함께 확인해야 합니다.

5. Clean failover 시험

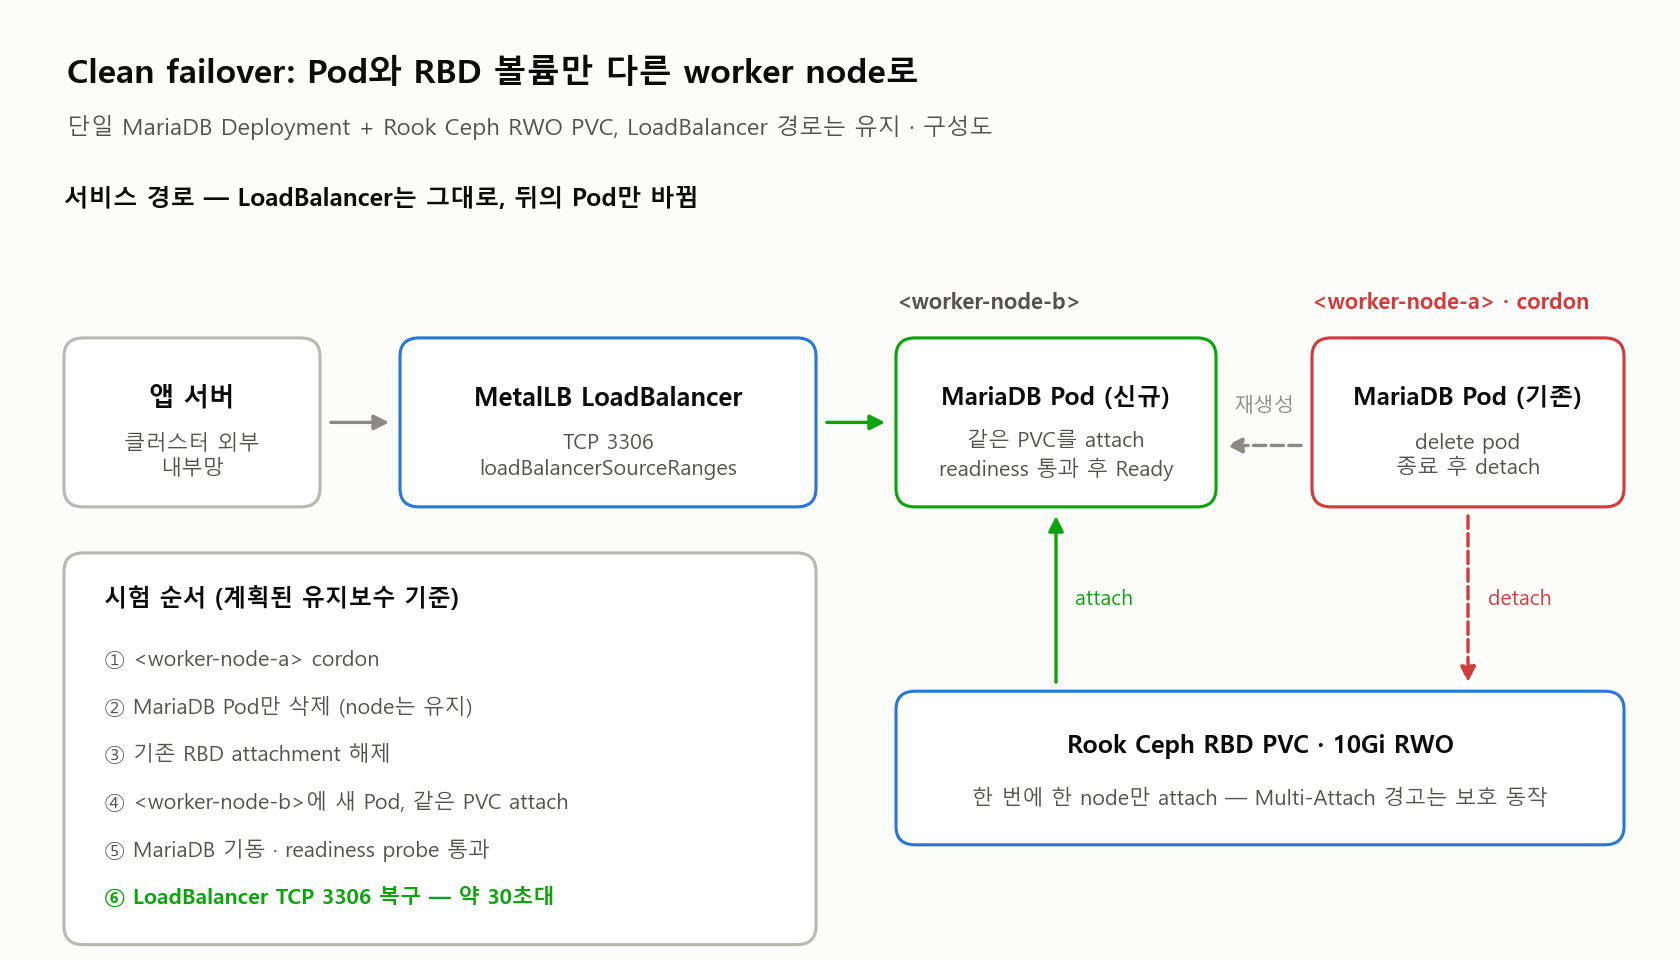
node 전체를 종료하면 같은 node의 다른 workload에도 영향을 줄 수 있습니다. 이번 시험에서는 영향 범위를 MariaDB로 제한하기 위해 현재 node를 cordon하고 MariaDB Pod만 재생성하였습니다. 다음 명령은 backup과 영향 범위를 확인한 유지보수 환경에서 실행해야 합니다.

kubectl cordon <worker-node-a>
kubectl delete pod <mariadb-pod> -n mariadb-system --wait=false
kubectl get pods -n mariadb-system -l app=mariadb -o wide --watch
kubectl get volumeattachment -o wide
kubectl uncordon <worker-node-a>

LoadBalancer TCP 3306을 짧은 간격으로 확인하여 서비스 중단과 복구 시점을 기록하였습니다. 새 Pod는 <worker-node-b>에 배치되었으며 기존 RBD attachment가 해제된 후 같은 PVC를 연결하였습니다. container 시작과 readiness probe가 완료된 뒤 LoadBalancer 접속도 다시 성공하였습니다.

Kubernetes MariaDB Failover 구성도로, cordon한 worker node의 MariaDB Pod를 삭제하면 Rook Ceph RBD PVC가 detach된 뒤 다른 worker node의 새 Pod에 attach되고 MetalLB LoadBalancer TCP 3306 경로가 약 30초대에 복구되는 순서를 보여 줍니다.
LoadBalancer 경로는 그대로 두고 Pod와 RWO 볼륨만 다른 worker node로 옮긴 clean failover 순서입니다.

6. 복구 후 데이터베이스 검증

새 node에서 MariaDB가 Ready 상태가 된 뒤 version, system table, application schema, active connection과 startup log를 다시 검사하였습니다. TCP port만 확인하지 않고 실제 SQL query와 Ceph health, VolumeAttachment 대상 node까지 함께 비교하였습니다.

CHECK TABLE mysql.user;
CHECK TABLE mysql.event;
CHECK TABLE mysql.proc;
CHECK TABLE mysql.column_stats;

SELECT VERSION();
SELECT 1 AS read_test;

검증 완료 후 원래 node를 uncordon하여 scheduler가 다시 사용할 수 있도록 복원하였습니다. MariaDB Pod는 새 node에서 계속 실행되었으며 불필요한 추가 재시작은 발생하지 않았습니다.

failover 시험에서 드러난 네 가지 현상

시스템 테이블 형식 불일치

현상: MariaDB 접속은 가능했지만 system view와 statistics table 오류가 반복되었고 Event Scheduler 초기화도 실패하였습니다.

원인: container image의 MariaDB patch version은 변경되었지만 data directory의 일부 system table과 privilege가 현재 binary 형식으로 정리되지 않았습니다. 기존 upgrade marker로 인해 자동 검사는 추가 작업이 필요하지 않다고 판단하였습니다.

해결: physical backup을 확보한 뒤 mariadb-upgrade --force를 실행하고 system table을 재검사하였습니다. 모든 table이 OK 상태가 되었고 이후 startup에서도 같은 오류는 없었습니다.

RBD Multi-Attach 경고

현상: 새 Pod가 다른 worker node에 생성된 직후 volume이 이전 Pod에서 사용 중이라는 Multi-Attach warning이 한 차례 발생하였습니다.

원인: ReadWriteOnce RBD volume의 이전 attachment 정리와 새 attachment 요청 사이에 짧은 시간 차이가 있었습니다. 이는 두 node가 같은 block volume을 동시에 사용하지 못하도록 보호하는 정상적인 동작입니다.

해결: 이전 Pod가 종료되고 CSI controller가 attachment를 정리할 때까지 기다렸으며 잠시 후 attach가 자동으로 성공하였습니다. 이전 node의 상태를 확인하지 않고 VolumeAttachment를 강제로 삭제하면 data corruption 위험이 있으므로 피해야 합니다.

TCP 점검으로 증가한 Aborted Connections

현상: failover 측정 후 Aborted_connects 값과 unauthenticated connection warning이 증가하였습니다.

원인: TCP port monitor가 MariaDB protocol authentication을 수행하지 않고 연결 직후 종료했기 때문입니다.

해결: 측정 종료 후 증가가 멈추는지 확인하였습니다. 상시 monitoring에는 단순 TCP connect 대신 권한이 제한된 health check 계정으로 ping 또는 query를 실행하는 방식이 적합합니다.

Clean failover와 실제 node 장애의 차이

현상: clean failover는 약 30초대에 완료되었지만 실제 node 장애도 같은 시간에 복구된다고 단정할 수 없습니다.

원인: 비정상 장애에서는 Kubernetes가 NotReady 또는 Unreachable 상태를 판단하고 Pod toleration이 만료될 때까지 기다립니다. 기존 node의 volume attachment가 남아 있다면 CSI fencing과 detach에도 시간이 필요합니다.

해결: 이번 결과는 계획된 유지보수 상황의 RTO로 기록하였습니다. 갑작스러운 전원 장애는 수 분 이상의 RTO를 예상하고 별도 점검에서 node shutdown과 MetalLB 경로 전환을 포함하여 검증해야 합니다.

계획된 이동은 약 30초대, 전원 장애는 별도 검증

Kubernetes MariaDB Failover 시험 결과, 단일 MariaDB Deployment와 Rook Ceph RWO PVC 구성에서도 계획된 Pod 이동 후 다른 worker node에서 데이터베이스를 정상적으로 기동할 수 있었습니다. 기존 데이터, system table, application schema, SQL query와 Ceph health가 모두 정상임을 확인하였습니다.

검증 항목 결과
다른 worker node에 Pod 배치 성공
기존 RBD PVC 재부착 성공
MariaDB 기동 및 SQL 실행 정상
LoadBalancer 서비스 복구 약 30초대
갑작스러운 node 전원 장애 이번 시험 범위에서 제외

이번 Kubernetes MariaDB Failover 시험의 측정 시간에는 기존 Pod 종료, RBD detach와 attach, container 시작, MariaDB 기동과 readiness probe 통과가 포함됩니다. 실제 복구 시간은 image cache, node 부하, Ceph 상태와 transaction recovery 양에 따라 달라질 수 있습니다.

현재 workload 규모에서는 Galera cluster의 추가 memory와 storage 소비보다 단일 instance, Ceph RBD, 정기 physical backup과 source-restricted LoadBalancer 조합이 적합하다고 판단하였습니다. 향후 RTO와 RPO 요구가 강화되면 asynchronous replica 또는 Galera와 database proxy 도입을 다시 검토할 수 있습니다.

storage replica는 backup을 대체하지 않습니다. 정기 backup, checksum 검증, 별도 위치 보관과 restore test를 함께 운영해야 node 장애뿐 아니라 운영 실수와 데이터 손상에도 대응할 수 있습니다.

참고

관련 포스트:

참고 문서: Kubernetes Service · MariaDB Upgrade · MariaDB Backup · Rook Ceph Block Storage

Migrating Ingress Controller: ingress-nginx EOL to Traefik v3.7.5 with Wildcard TLS Automation

ingress-nginx EOL과 Traefik을 고른 이유

kubernetes/ingress-nginx 프로젝트가 2026년 3월 31일부로 EOL(End of Life)을 선언하고 아카이브되었습니다. 이를 계기로 ingress-nginx → Traefik 마이그레이션 작업을 진행하여 자체 관리형 Kubernetes 클러스터의 Ingress 컨트롤러를 Traefik v3.7.5로 교체하고, 모니터링 스택(Prometheus / Alertmanager / Grafana) 도메인을 *.sierracloud.dev로 전환하였습니다. 아울러 HAProxy 서버에서 관리하는 Let’s Encrypt 와일드카드 인증서를 Kubernetes 클러스터에 자동 동기화하는 CronJob을 구성하였습니다.

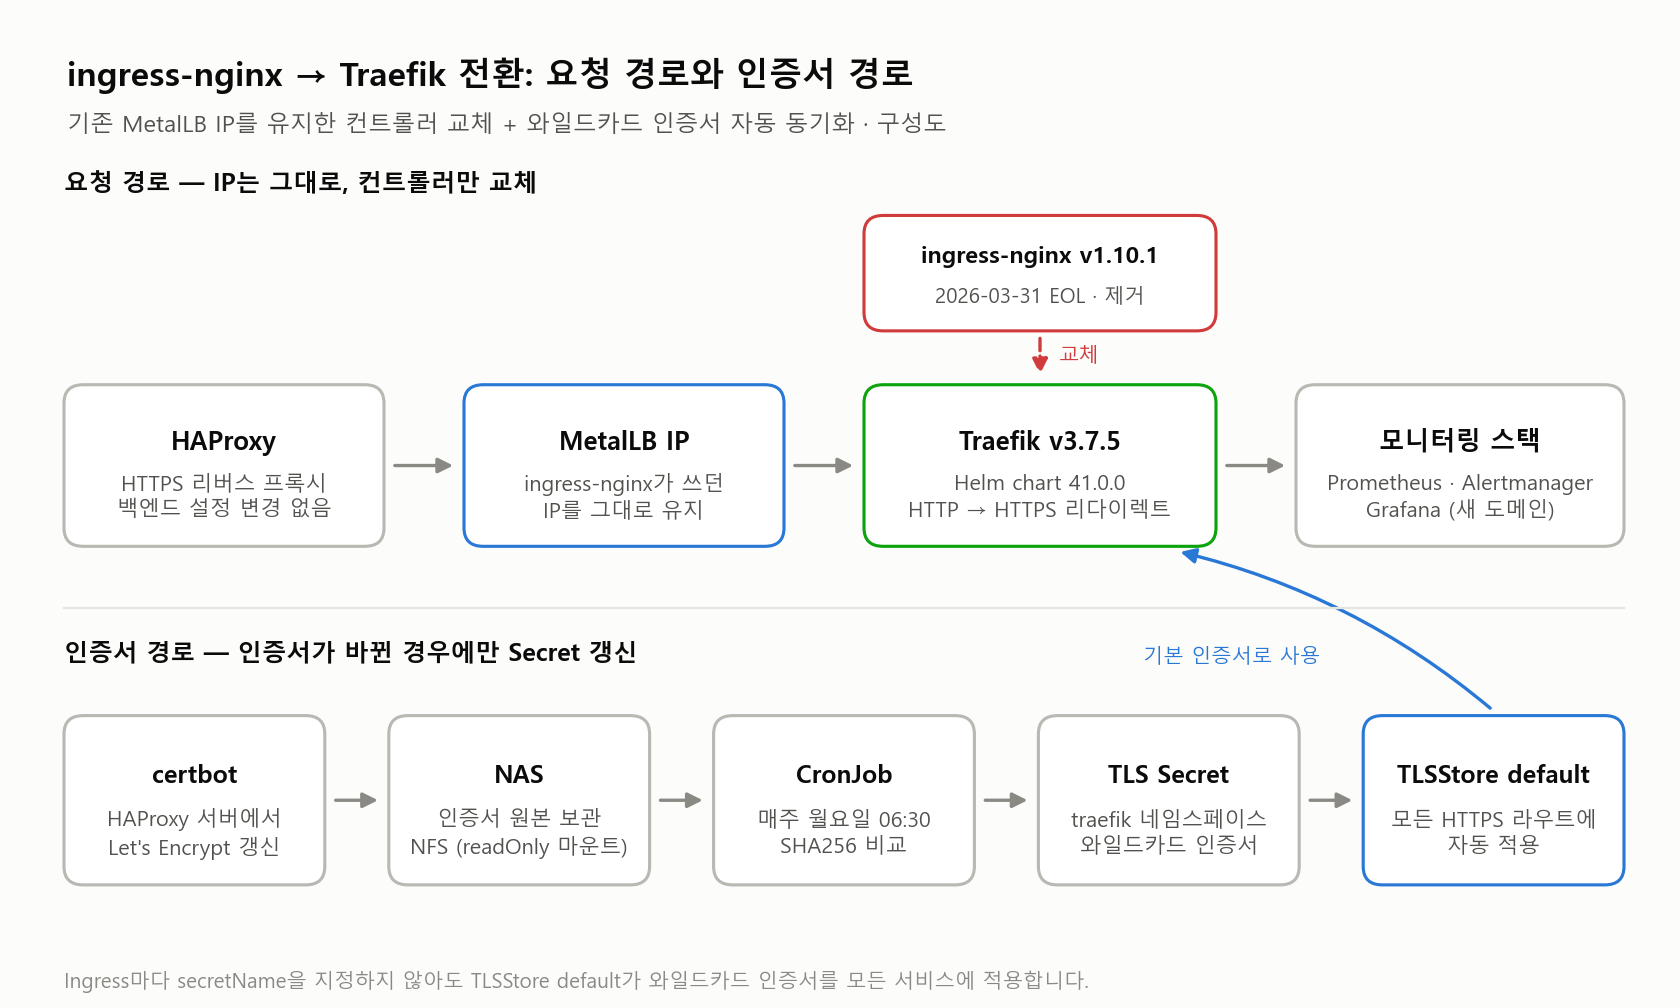
ingress-nginx Traefik 마이그레이션 구성도로, HAProxy와 기존 MetalLB IP 뒤에서 ingress-nginx v1.10.1을 Traefik v3.7.5로 교체한 요청 경로와 certbot 인증서가 NAS, CronJob, Secret을 거쳐 TLSStore default로 적용되는 경로를 보여 줍니다.
ingress-nginx → Traefik 마이그레이션 구성도입니다. MetalLB IP는 그대로 두고 컨트롤러만 바꾼 요청 경로와, 인증서가 바뀔 때만 Secret을 갱신하는 동기화 경로를 함께 그렸습니다.

대안으로 Contour, Kong, HAProxy Ingress 등을 검토하였으나, Traefik을 선택한 이유는 다음과 같습니다. Helm chart가 잘 관리되고 있으며, TLSStore를 통한 와일드카드 인증서 중앙 관리가 가능합니다. 또한 CRD(IngressRoute, Middleware 등)를 통한 고급 라우팅 설정과 Kubernetes Ingress 표준 오브젝트와의 호환성을 동시에 지원합니다. HTTP → HTTPS 강제 리다이렉트도 values.yaml 설정 한 줄로 처리됩니다.


환경

  • Kubernetes v1.33.7 (HA: Control Plane 3대 + Worker 3대)
  • MetalLB — LoadBalancer IP 풀: 192.168.x.x/29
  • HAProxy (192.168.x.x:6443) — K8s API LB 및 HTTPS 리버스 프록시 겸용
  • NAS — Let’s Encrypt 인증서 원본 보관, NFS export
  • 교체 전: kubernetes/ingress-nginx v1.10.1 (EOL)
  • 교체 후: Traefik v3.7.5 (Helm chart 41.0.0)

기존 IP를 유지한 교체와 인증서 자동화

1. ingress-nginx 설정 백업

삭제 전에 기존 설정을 코드로 백업하여 재설치 시 활용할 수 있도록 보존합니다.

# IngressClass, ConfigMap, Ingress 리소스 백업
kubectl get ingressclass nginx -o yaml > backup/ingress-nginx/ingressclass-nginx.yaml
kubectl get cm ingress-nginx-controller -n ingress-nginx -o yaml > backup/ingress-nginx/configmap-controller.yaml
kubectl get ingress -n monitoring -o yaml > backup/ingress-nginx/ingress-monitoring.yaml

# Helm values 백업
helm get values ingress-nginx -n ingress-nginx -o yaml > backup/ingress-nginx/helm-ingress-nginx-values.yaml

# 삭제 절차 문서화 후 제거
helm uninstall ingress-nginx -n ingress-nginx

2. Traefik v3.7.5 설치

ingress-nginx가 사용하던 MetalLB IP를 그대로 유지하여 HAProxy의 백엔드 설정 변경 없이 전환합니다.

helm repo add traefik https://traefik.github.io/charts
helm repo update

helm upgrade --install traefik traefik/traefik \
  -f helm/traefik-values.yaml \
  -n traefik --create-namespace

helm/traefik-values.yaml 핵심 설정:

service:
  annotations:
    metallb.universe.tf/loadBalancerIPs: "192.168.x.x"   # 기존 IP 유지

ingressClass:
  enabled: true
  isDefaultClass: true

ports:
  web:
    http:
      redirections:
        entryPoint:
          to: websecure
          scheme: https
          permanent: true   # HTTP → HTTPS 전체 리다이렉트

3. 모니터링 도메인 변경

*.sierracloud.kro.kr에서 *.sierracloud.dev로 전환하고 ingressClassName을 교체합니다. Helm values 수정 후 upgrade를 적용합니다.

# helm/monitoring-values.yaml (변경 부분)
prometheus:
  ingress:
    ingressClassName: traefik    # nginx → traefik
    hosts:
      - prometheus.sierracloud.dev

grafana:
  ingress:
    ingressClassName: traefik
    hosts:
      - grafana.sierracloud.dev
  grafana.ini:
    server:
      domain: grafana.sierracloud.dev
      root_url: https://grafana.sierracloud.dev
      protocol: http             # Traefik이 TLS 종료, Grafana 내부는 HTTP
helm upgrade monitoring prometheus-community/kube-prometheus-stack \
  -f helm/monitoring-values.yaml -n monitoring

4. 와일드카드 TLS 인증서 자동화

HAProxy 서버에서 certbot이 Let’s Encrypt 인증서를 주기적으로 갱신하고 NAS에 복사합니다. Kubernetes CronJob이 이후 NAS NFS를 마운트하여 SHA256 비교 후 변경 시에만 Secret을 갱신합니다.

certbot (HAProxy)
  └─→ NAS (NFS)
        └─→ K8s CronJob (SHA256 비교)
              └─→ traefik/wildcard-sierracloud-dev Secret
                    └─→ Traefik TLSStore default → 모든 서비스 자동 적용

TLSStore를 사용하면 각 네임스페이스의 Ingress 리소스에 secretName을 지정할 필요 없이 모든 HTTPS 라우트에 와일드카드 인증서가 자동으로 적용됩니다.

# manifests/traefik/tls-store.yaml
apiVersion: traefik.io/v1alpha1
kind: TLSStore
metadata:
  name: default
  namespace: traefik
spec:
  defaultCertificate:
    secretName: wildcard-sierracloud-dev

CronJob은 매주 갱신 주기에 맞춰 실행되며 SHA256 비교를 통해 인증서가 변경된 경우에만 Secret을 업데이트합니다.

# manifests/traefik/tls-secret-sync.yaml (핵심 부분)
schedule: "30 6 * * 1"    # 매주 월요일
timeZone: "Asia/Seoul"
concurrencyPolicy: Forbid

volumes:
  - name: certs
    nfs:
      server: 192.168.x.x
      path: /data/cert
      readOnly: true
# CronJob 컨테이너 스크립트 (요약)
CURRENT_SHA=$(kubectl get secret wildcard-sierracloud-dev -n traefik \
  -o jsonpath='{.data.tls\.crt}' | base64 -d | sha256sum | cut -d' ' -f1)
NEW_SHA=$(sha256sum < /certs/sierracloud.dev/fullchain.pem | cut -d' ' -f1)

if [ "$CURRENT_SHA" != "$NEW_SHA" ]; then
  kubectl create secret tls wildcard-sierracloud-dev \
    --cert=/certs/sierracloud.dev/fullchain.pem \
    --key=/certs/sierracloud.dev/privkey.pem \
    -n traefik --dry-run=client -o yaml | kubectl apply -f -
fi

전환 중 만난 이미지 태그 삭제와 일시적 503

① bitnami/kubectl 이미지 태그 없음

증상: CronJob 컨테이너 이미지 bitnami/kubectl:1.33이 ImagePullBackOff 발생.

원인: 2025년 12월 이후 bitnami/kubectl Docker Hub 레포지토리에서 버전 태그가 삭제됨 (GitHub issue #88999). latest 태그만 존재.

해결: alpine/k8s:1.33.10으로 교체. Alpine 기반으로 kubectl + 기본 유틸리티(sha256sum, base64 등) 포함, K8s 1.33.x 버전과 동일 minor version으로 완전 호환.

image: alpine/k8s:1.33.10    # bitnami/kubectl:1.33 → 교체

② 도메인 변경 후 Traefik 503 (약 5초)

증상: Helm upgrade 직후 prometheus.sierracloud.dev, grafana.sierracloud.dev 접속 시 503 반환.

원인: Traefik이 새로운 Ingress 라우트를 동기화하는 데 약 5초 소요.

해결: 별도 조치 없이 자연 해소. Traefik의 정상적인 라우트 갱신 동작.


검증

# Traefik LoadBalancer IP 확인
kubectl get svc -n traefik

# TLSStore 적용 확인
kubectl get tlsstore -n traefik

# Secret 인증서 유효기간 확인
kubectl get secret wildcard-sierracloud-dev -n traefik \
  -o jsonpath='{.data.tls\.crt}' | base64 -d | openssl x509 -noout -subject -dates

# HTTPS 접속 확인
curl -skI https://grafana.sierracloud.dev | head -3
curl -skI https://prometheus.sierracloud.dev | head -3
# 출력 예시
HTTP/2 302       ← Grafana 로그인 리다이렉트 (정상)
HTTP/2 405       ← Prometheus (정상)

subject=CN = *.sierracloud.dev
notAfter=Sep 17 13:39:09 2026 GMT

결론

ingress-nginx EOL 전환을 계기로 Traefik v3.7.5를 도입하고, Let’s Encrypt 와일드카드 인증서의 자동 갱신 파이프라인을 구성하였습니다. Secret을 traefik 네임스페이스에 단일 관리하고 TLSStore default로 노출함으로써 향후 신규 서비스 추가 시 Ingress에 secretName을 별도 지정할 필요 없이 자동으로 와일드카드 인증서가 적용됩니다.

기존 ingress-nginx와의 전환 과정에서 MetalLB LoadBalancer IP를 그대로 유지했기 때문에 HAProxy 백엔드 설정 변경 없이 완전한 무중단 전환이 가능하였습니다. Traefik v3 계열의 Kubernetes Gateway API 지원, 향상된 observability, 그리고 CRD 기반의 미들웨어 체인 설정은 장기적인 운영에서도 ingress-nginx 대비 유리한 점이 많습니다.

참고

관련 포스트:

참고 문서: Traefik TLSStore Default Certificate (공식 문서) · Traefik Helm Chart 설치 가이드